NetworkPolicy 网络策略
[toc]
本文解决一个让很多人吃惊的问题:k8s 里 Pod 与 Pod 之间默认全通,任何 Pod 都能访问集群里所有 Pod 的任何端口。怎么把集群从"全互通"改造成"只放行该通的流量"?答案就是 NetworkPolicy——一套声明式的"白名单防火墙"。
适合谁读:集群已经跑起来、开始关心东西向流量安全的人。本文讲清 NetworkPolicy 的前提条件(CNI 支持)、四个核心字段(podSelector/policyTypes/ingress/egress)、默认拒绝的写法、几个典型场景 YAML,以及最容易踩的 DNS 大坑和调试方法。流量入口(Service/Ingress)的内容见同目录相关笔记。
官方文档参考
| 页面 | 链接 |
|---|---|
| 网络策略(Network Policies)概念 | https://kubernetes.io/zh-cn/docs/concepts/services-networking/network-policies/ |
| 声明网络策略(任务:入门示例) | https://kubernetes.io/zh-cn/docs/tasks/administer-cluster/declare-network-policy/ |
| Kubernetes 网络模型(CNI 插件列表) | https://kubernetes.io/zh-cn/docs/concepts/cluster-administration/networking/ |
相关笔记:Service 与集群内访问模型见 service简介;集群部署时如何选装 CNI(Calico/Flannel)见 使用kubeadm安装最新版k8s集群-v1.37。
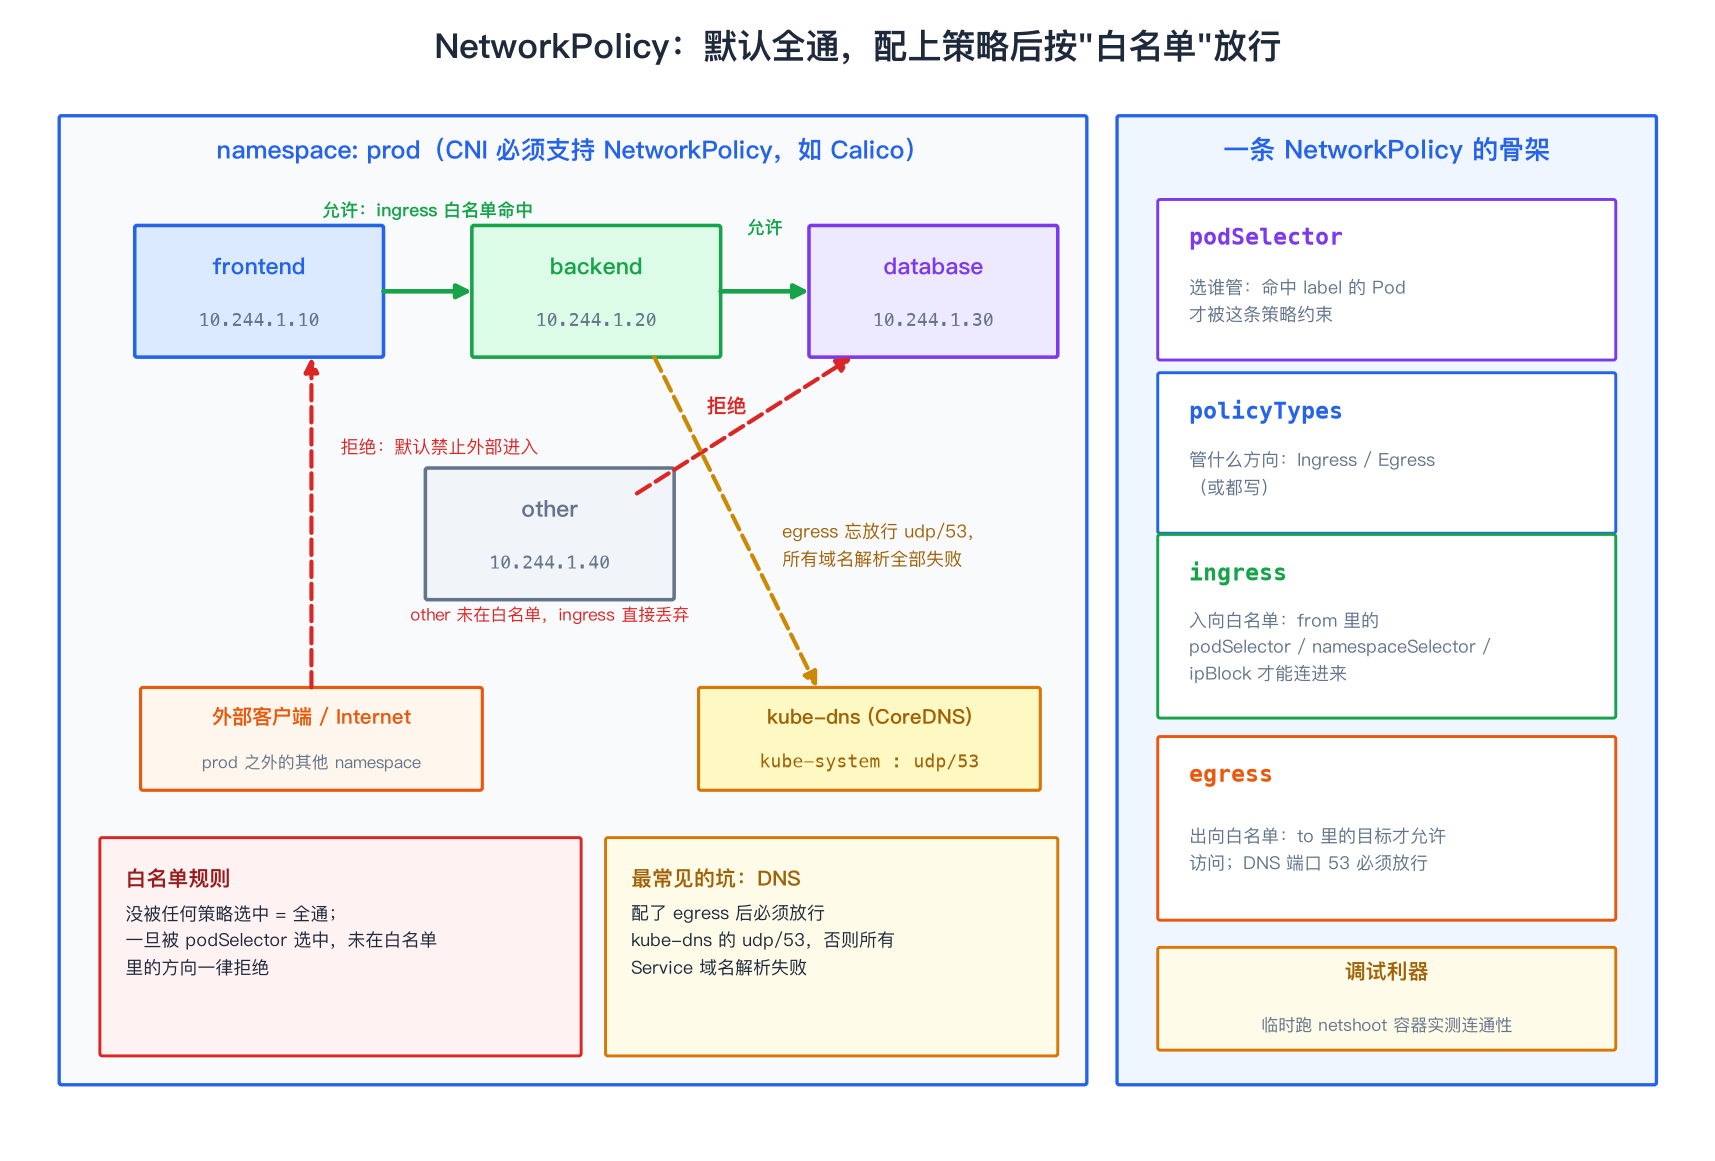
1. 为什么 Pod IP 全通:CNI 默认不做隔离
k8s 的网络模型只要求三件事:Pod 之间无 NAT 直通、节点与 Pod 互通、Pod 自己看到的 IP 就是别人看到的 IP。它没有规定任何隔离,所以 CNI 插件(flannel、calico……)装好后,集群里任意两个 Pod、任意两个端口都是互通的——哪怕一个是前端、一个是数据库。
这在测试环境无所谓,在生产环境是明显短板:
- 一个被攻破的业务 Pod 可以直接横向探测数据库、中间件
- 非生产 namespace 的 Pod 可以随意连生产数据库
- 违反等保、安全审计等合规场景里"最小网络可达"的要求
NetworkPolicy 是标准 API,但 k8s 自带组件不执行它,真正落实规则的是 CNI 网络插件。 常见支持情况:Calico、Cilium 支持;Flannel 不支持——在 Flannel 集群里 kubectl apply NetworkPolicy 不会报错(对象创建成功),但规则完全不生效,这是最隐蔽的坑。Cilium/Weave 等其他插件的支持范围也有差异(如是否支持 ipBlock、SCTP),动手前务必对照 CNI 插件官方列表 和你自己集群的插件文档验证。验证方法:写一条 default-deny 策略,用下面第 7 节的 netshoot 容器实测流量是否真的被拦。
2. NetworkPolicy 是什么:声明式的白名单
NetworkPolicy 的心智模型是白名单,三个核心规则:
- 默认全通:没被任何 NetworkPolicy 的
podSelector选中的 Pod,进出流量全部放行(和没有策略时一样) - 选中即收紧:Pod 一旦被某条策略选中,它就进入"白名单模式"——ingress/egress 里没明确允许的方向,一律拒绝
- 允许是叠加的:多条策略同时选中一个 Pod 时,允许列表取并集;想收紧只能改策略或删策略,没有"拒绝某条"的语法
它是纯声明式的:你描述"谁可以连谁",实际的拦截由 CNI 在节点上写 iptables/eBPF 规则实现,作用点在每个 Pod 的网卡上,而不是集群级防火墙。
3. 四个核心字段逐个讲
先看一条策略的完整骨架,再逐字段拆:
apiVersion: networking.k8s.io/v1
kind: NetworkPolicy
metadata:
  name: demo-policy
  namespace: prod            # 策略是 namespace 级对象,只影响本 namespace 的 Pod
spec:
  podSelector:               # ① 选谁管:命中这些 label 的 Pod 受本策略约束
    matchLabels:
      app: backend
  policyTypes:               # ② 管什么方向:Ingress(入)/ Egress(出),可同时写
  - Ingress
  - Egress
  ingress:                   # ③ 入向白名单:列表里的每一项都是一条"允许"
  - from:
    - podSelector:           # 允许同 namespace 内带 app=frontend 标签的 Pod 连入
        matchLabels:
          app: frontend
    ports:
    - protocol: TCP          # 只允许访问 TCP 8080 端口
      port: 8080
  egress:                    # ④ 出向白名单:结构同 ingress,把 from 换成 to
  - to:
    - podSelector:           # 允许出向访问同 namespace 的 app=database Pod
        matchLabels:
          app: database
    ports:
    - protocol: TCP
      port: 3306
3.1 podSelector:这条策略管谁
spec.podSelector 决定哪些 Pod 被"白名单化"。空的对象 podSelector: {} 表示选中本 namespace 的全部 Pod(default-deny 全拒绝就是靠它写的)。注意区分两个位置的 selector:
spec.podSelector:管谁(策略的靶子)ingress[].from[].podSelector:谁可以进来(白名单条目)
3.2 policyTypes:管入还是管出
- 只写
Ingress:入向白名单化,出向不受影响 - 只写
Egress:出向白名单化,入向不受影响 - 都写:双向白名单化
- 完全不写 policyTypes 但写了 ingress/egress:k8s 会按实际写的字段推断
3.3 ingress / egress 的三种"对端"
from/to 列表里可以写三种选择器,可组合:
| 字段 | 含义 | 注意 |
|---|---|---|
| podSelector | 同 namespace 内指定 label 的 Pod | 想跨 namespace 必须与 namespaceSelector 联用 |
| namespaceSelector | 指定 label 的 namespace | 选中 namespace 后其下所有 Pod |
| ipBlock | CIDR 网段(含 Pod IP、节点 IP、外部 IP) | 见下节 except 的坑 |
三者同写在一个列表条目里是 OR 关系;注意一个易错点:单独写 podSelector 的条目只匹配与策略同 namespace 的 Pod,跨 namespace 必须这样写:
- from:
  - namespaceSelector:      # 先圈定 namespace
      matchLabels:
        project: dev
    podSelector:            # 再在圈定的 namespace 里圈 Pod(注意:同一层级缩进,是"且"关系)
      matchLabels:
        app: api
3.4 ipBlock 与 except
ipBlock 按网段匹配源/目标 IP,常用于放行办公网、拉黑已知坏网段:
- from:
  - ipBlock:
      cidr: 10.0.0.0/16      # 允许 10.0.0.0/16 网段
      except:
      - 10.0.5.0/24          # 但排除其中的 10.0.5.0/24
- except 的 CIDR 必须真包含在 cidr 里,写错直接报错
- 部分插件(如某些版本的 Calico)对 except 的网段大小有限制,太小的前缀会被拒绝
- ipBlock 匹配的是网络层看到的源 IP,经过 SNAT 后 Pod 流量的源 IP 可能变成节点 IP,导致 ipBlock 规则表现和预期不符——优先用 podSelector/namespaceSelector,ipBlock 留给真正的外部网段
4. 默认拒绝:两张最常用的 YAML
"白名单防火墙"的第一步是把默认状态改成全拒绝。以下两条策略配合使用,分别封死入向和出向(空 podSelector 选中本 namespace 全部 Pod,空的 ingress:/egress: 列表表示"没有任何允许项"):
# default-deny-ingress.yaml:本 namespace 所有 Pod 禁止一切入向流量
apiVersion: networking.k8s.io/v1
kind: NetworkPolicy
metadata:
  name: default-deny-ingress
  namespace: prod
spec:
  podSelector: {}            # 选中 prod 里全部 Pod
  policyTypes:
  - Ingress
  ingress: []                # 空列表 = 没有任何入向白名单 = 全部拒绝
# default-deny-egress.yaml:本 namespace 所有 Pod 禁止一切出向流量
apiVersion: networking.k8s.io/v1
kind: NetworkPolicy
metadata:
  name: default-deny-egress
  namespace: prod
spec:
  podSelector: {}            # 选中 prod 里全部 Pod
  policyTypes:
  - Egress
  egress: []                 # 空列表 = 全部拒绝
两条都建(常合称 default-deny-all)之后,prod 变成"孤岛":没有一条 allow 策略的 Pod 连 DNS 都通不了。下面按场景逐个补白名单。
5. 典型场景示例集
5.1 允许 frontend 访问 backend
# 管住 backend:只允许 frontend 用 TCP 8080 访问它
apiVersion: networking.k8s.io/v1
kind: NetworkPolicy
metadata:
  name: allow-frontend-to-backend
  namespace: prod
spec:
  podSelector:
    matchLabels:
      app: backend            # 目标:backend
  policyTypes:
  - Ingress
  ingress:
  - from:
    - podSelector:
        matchLabels:
          app: frontend       # 来源:同 namespace 的 frontend
    ports:
    - protocol: TCP
      port: 8080
5.2 允许指定 namespace 访问
# 允许 dev namespace 里带 app=api 标签的 Pod 访问本 namespace 的 backend
apiVersion: networking.k8s.io/v1
kind: NetworkPolicy
metadata:
  name: allow-dev-namespace
  namespace: prod
spec:
  podSelector:
    matchLabels:
      app: backend
  policyTypes:
  - Ingress
  ingress:
  - from:
    - namespaceSelector:
        matchLabels:
          project: dev        # namespace 也要有 label,kubectl label ns dev project=dev
      podSelector:
        matchLabels:
          app: api            # 与 namespaceSelector 同级缩进 = "且"关系
namespaceSelector 匹配的是 namespace 对象上的 label,默认 namespace 往往一个 label 都没有。先 kubectl label ns dev project=dev,否则规则永远匹配不上。
5.3 放行 DNS:最常见的坑,没有之一
只要给 Pod 配置了 Egress 白名单(哪怕只是想允许访问数据库),就必须同时放行到 kube-dns 的 53 端口,否则 Pod 连 mysql.service.consul、api.example.com 之类的域名全部解析失败,应用表现为大量 no such host 报错——规则本身没写错,纯粹是忘了 DNS。这是 NetworkPolicy 最经典的翻车点,网上搜"NetworkPolicy 无法解析域名"一半是它。
# 给带 app=backend 标签的 Pod 放行 DNS 查询(CoreDNS 位于 kube-system)
apiVersion: networking.k8s.io/v1
kind: NetworkPolicy
metadata:
  name: allow-dns
  namespace: prod
spec:
  podSelector:
    matchLabels:
      app: backend
  policyTypes:
  - Egress
  egress:
  - to:
    - namespaceSelector:
        matchLabels:
          kubernetes.io/metadata.name: kube-system   # k8s 默认给每个 ns 打的内置 label
      podSelector:
        matchLabels:
          k8s-app: kube-dns
    ports:
    - protocol: UDP        # DNS 主要走 UDP 53
      port: 53
    - protocol: TCP        # 大包/区域传输会走 TCP 53,一并放行
      port: 53
建议的做法:把这条 allow-dns 做成 namespace 里的"标配"——凡是写了 Egress 策略的 namespace,先垫上这条再写业务放行规则。
6. 一条完整的"最小可用"策略组合
把前面的场景拼起来:backend 允许 frontend 进、允许自己访问 database 和 DNS。先 default-deny,再叠加允许,这正是生产环境推荐的做法:
# 1) 全局兜底:default-deny(见第 4 节,两条都要)
# 2) 放行 frontend -> backend:8080(见 5.1)
# 3) 放行 backend -> database:3306
apiVersion: networking.k8s.io/v1
kind: NetworkPolicy
metadata:
  name: backend-to-db
  namespace: prod
spec:
  podSelector:
    matchLabels:
      app: backend
  policyTypes:
  - Egress
  egress:
  - to:
    - podSelector:
        matchLabels:
          app: database
    ports:
    - protocol: TCP
      port: 3306
  - to:                       # 第二条白名单:DNS(见 5.3,此处省略端口细节)
    - namespaceSelector:
        matchLabels:
          kubernetes.io/metadata.name: kube-system
    ports:
    - protocol: UDP
      port: 53
    - protocol: TCP
      port: 53
7. 调试方法:用 netshoot 实测连通性
NetworkPolicy 的规则"看起来对"和"真的生效"之间隔着一个 CNI。最快的验证方法是临时起一个网络工具容器,直接测连通性。
# 起一个临时的 netshoot 容器(自带 curl/nc/dig/tcpdump 等网络工具)
# 打上 app=frontend 标签,让它命中 5.1 的白名单
kubectl run netshoot --rm -it --image=nicolaka/netshoot \
  --labels="app=frontend" -n prod -- /bin/bash

# 容器内依次验证:
nc -zv -w 2 backend-svc 8080        # 应显示 succeeded(白名单命中)
nc -zv -w 2 database-svc 3306       # frontend 未被允许访问 db,应超时被拒
nslookup kubernetes.default.svc.cluster.local   # 测 DNS,超时说明 53 被策略挡了

# 换个不被白名单选中的标签,验证"未命中即拒绝"
kubectl run netshoot2 --rm -it --image=nicolaka/netshoot \
  --labels="app=nobody" -n prod -- /bin/bash
# 此时连 backend-svc:8080 也应超时
- CNI 是否支持(Flannel 不支持,见第 1 节的 caution)
kubectl describe networkpolicy确认 label 拼写:被选中 Pod 的 label、对端 Pod 的 label、namespace 的 label 是否都真实存在- 确认 Pod 真的带了 label(Deployment 模板里的
spec.template.metadata.labels) - 用 netshoot 实测,并配合 CNI 自己的诊断工具(如 Calico 的
calicoctl get networkPolicy)
8. 小结
- k8s 默认网络是全通的,隔离靠 NetworkPolicy,而规则真正生效的前提是 CNI 支持(Calico/Cilium 支持,Flannel 不支持)
- 记住白名单三定律:不选中=全通、选中=未允许即拒绝、多条策略取并集
- 四个字段:
podSelector管谁、policyTypes管方向、ingress/egress是各自方向的白名单 - 配 Egress 必放行 DNS(udp/tcp 53),这是最常见的翻车点
- 改动后用 netshoot 容器实测,不要只看 YAML 对不对

