关于CGroupv2
在 Linux 上,控制组(CGroup,Control Group) 约束分配给进程的资源。kubelet 和底层容器运行时都需要对接 CGroup 来强制实施为 Pod 和容器管理资源,这包括为容器化工作负载配置 CPU/内存请求(requests)和限制(limits)。
Linux 中有两个 CGroup 版本:CGroup v1 和 CGroup v2。CGroup v2 是新一代的 cgroup API。
官方文档参考
| 项目 | 链接 |
|---|---|
| 关于 CGroup v2(官方中文文档) | https://kubernetes.io/zh-cn/docs/concepts/architecture/cgroups/ |
什么是 CGroup?
背景知识:CGroup(Control Groups)是 Linux 内核提供的资源隔离与限制机制,也是容器技术的三大基石之一(另两个是 Namespace 和 UnionFS)。它把一组进程组织成树状的控制组,并为每个组设置 CPU、内存、IO、进程数等资源的上限、下限与统计信息。
CGroup 在 Kubernetes 中扮演的角色:
| 角色 | 说明 |
|---|---|
| kubelet 侧 | kubelet 依据 Pod 的 CPU/内存 requests 和 limits,在节点上创建并配置对应的 cgroup 层级,把 Pod 及其容器"挂"到正确的层级上 |
| 容器运行时侧 | containerd / cri-o 等运行时收到 CRI 请求后,调用底层(如 runc)把容器进程放入 kubelet 指定的 cgroup,并写入具体的资源限制参数 |
| 内核侧 | 内核根据 cgroup 配置对进程组实施 CPU 配额(如 CFS quota)、内存上限(触发 OOM)、页面缓存回写约束等 |
换句话说,你在 YAML 里写的每一行 resources.requests 和 resources.limits,最终都是通过 CGroup 在内核里生效的。CGroup 版本(v1/v2)决定了这套约束机制的 API 形态和能力边界。
CGroup v1 与 v2 的核心差异
背景知识:以下对比基于官方对 CGroup v2 改进点的描述,并结合 Linux 内核社区对两代设计的通用解读展开。
CGroup v2 是 Linux cgroup API 的下一个版本,提供了一个具有增强资源管理能力的统一控制系统。相较 v1,它有多项重要改进:
| 维度 | CGroup v1 | CGroup v2 |
|---|---|---|
| 层级结构 | 每个子系统(cpu、memory、blkio……)各有一棵独立的控制树,分别挂载 | 单一统一的层级结构(unified hierarchy),所有控制器共用一棵树 |
| 挂载方式 | 同一进程可能出现在多个挂载点下,控制器之间彼此不可见,容易产生互相矛盾的资源语义 | 一个进程在一个层级中只有唯一位置,跨控制器的资源核算语义一致 |
| 子树委派 | 委派给非特权进程不安全,容易导致父层级被绕过或破坏 | 委派模型被重新设计,可安全地把子树委派给容器(如运行 systemd 的容器内可安全持有自己的子 cgroup) |
| 压力观测 | 无内置压力指标 | 提供 PSI(Pressure Stall Information,压力失步信息),可量化 CPU/内存/IO 的资源压力 |
| 内存核算 | 各类内存分开统计,口径不一 | 统一核算不同类型的内存分配(网络内存、内核内存等) |
| 非即时资源 | 只关注即时消耗 | 考虑非即时资源变化,例如页面缓存回写(page cache writeback) |
| API 形态 | 控制器文件分散、命名不统一 | 控制器文件统一以 memory.、cpu.、io. 前缀组织,语义清晰 |
下面这张图直观展示了两代 CGroup 的层级结构差异:
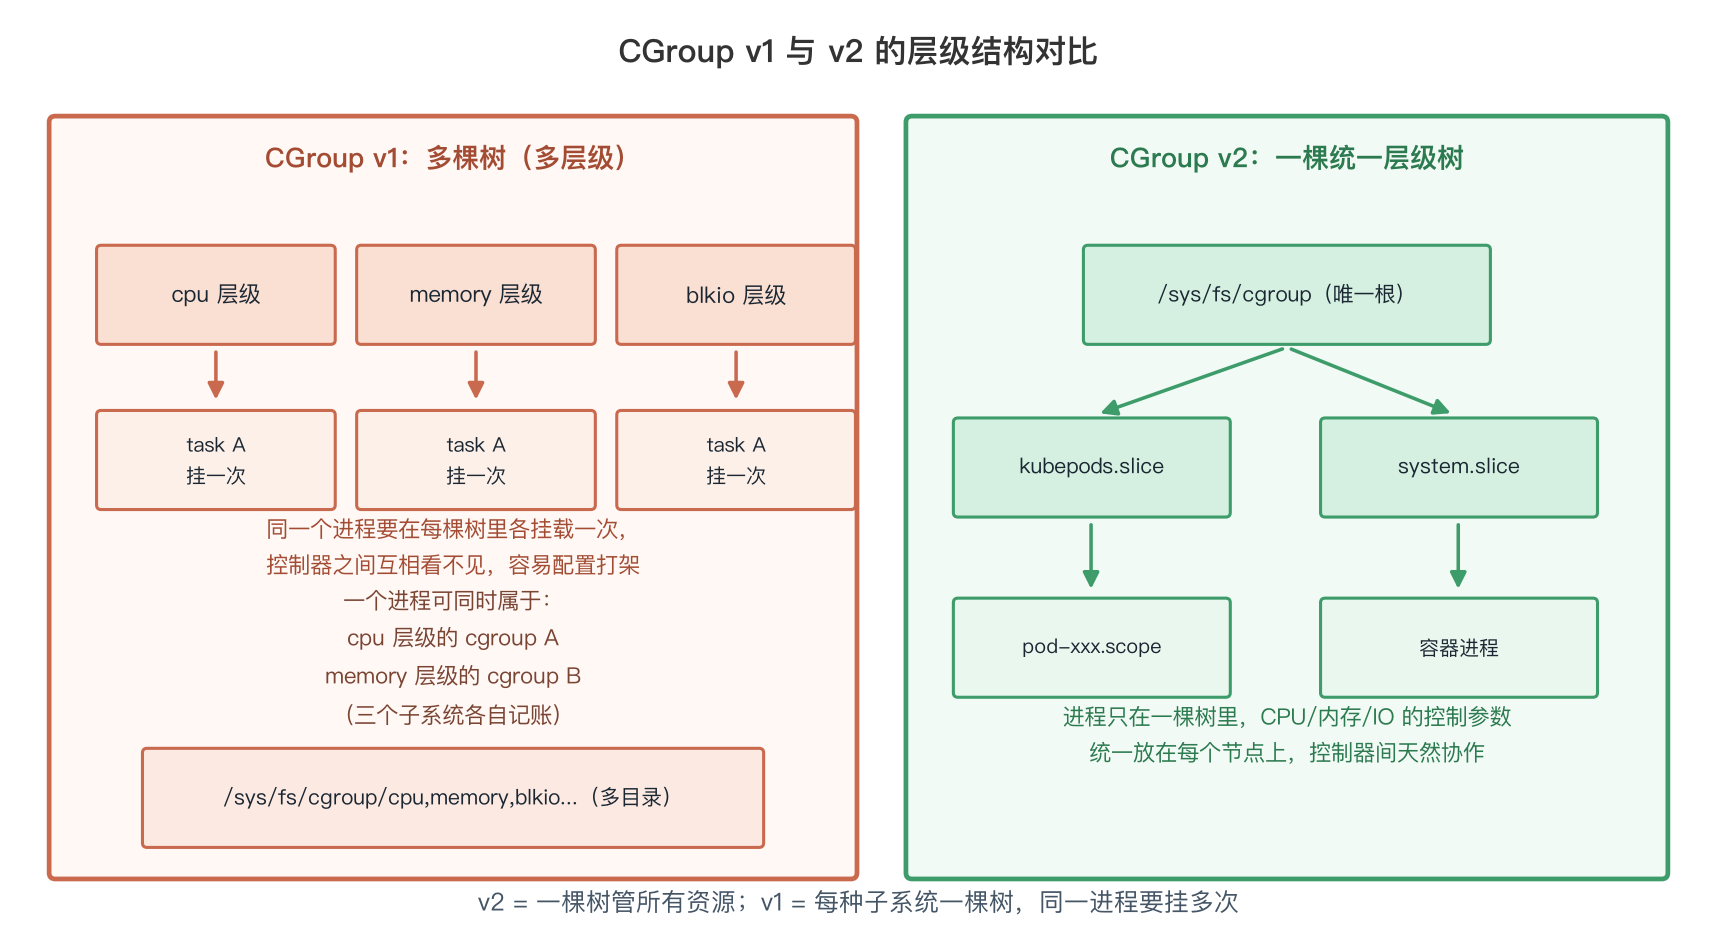
在 v1 中,cpu 控制器和 memory 控制器各自维护一棵树,同一个 Pod 可能在两棵树的不同位置,管理工具很难保证语义一致;v2 的单树设计让"一个进程属于哪个组"只有唯一答案,也让跨资源的资源分配管理与隔离成为可能。这正是 Kubernetes 选择拥抱 v2 的根本原因。
PSI(Pressure Stall Information)是什么?
背景知识:PSI 是 Linux 内核 4.20 引入的资源压力统计机制,CGroup v2 在 v2 层级上暴露了每个控制组的 PSI 指标。它统计"因为等待 CPU / 内存 / IO 而停摆(stall)的时间占比",例如 some avg10=25.00 表示过去 10 秒内约有 25% 的时间至少有部分任务在等资源,full 则表示所有任务同时停摆。相比"利用率"这类水位指标,PSI 直接度量"竞争造成的代价",是判断资源是否真正紧张的有效信号,也为后续基于压力的节点过载检测提供了基础。
委派(Delegation)为什么在 v2 更安全?
背景知识:"委派"指把 cgroup 层级中的某个子树交给另一个(通常权限更低的)进程或组件去管理,典型场景是容器内的 systemd 管理自己子树里的服务进程。
- v1 下委派很危险:因为控制器分散在多棵树上,被委派者可能在某棵树上移动或修改边界,影响其他树上的资源语义,甚至越权干预宿主层级;
- v2 下委派模型被重新设计:只委派单一层级上的一个目录子树,并配以明确的权限模型(如
+cpu +memory控制器使能文件),被委派者只能在自己的子树内操作,无法影响兄弟和祖先层级。
这也是 CGroup v2 官方文档中"更安全的子树委派给容器"的具体含义。
CGroup v2 特性状态
特性状态: Kubernetes v1.25 起 GA(稳定)
CGroup v2 特性自 v1.25 起进入 GA,可以放心在生产环境使用。
使用 CGroup v2 的要求
使用 CGroup v2 的推荐方法是使用一个默认启用 CGroup v2 的 Linux 发行版。要检查你的发行版是否使用 CGroup v2,请参阅下文识别 Linux 节点上的 CGroup 版本。
CGroup v2 具有以下要求:
| 要求项 | 具体标准 |
|---|---|
| 操作系统发行版 | 启用 CGroup v2 |
| Linux 内核 | 5.8 或更高版本 |
| containerd | v1.4 和更高版本 |
| cri-o | v1.20 和更高版本 |
| CGroup 驱动 | kubelet 和容器运行时都配置为使用 systemd CGroup 驱动 |
内核版本与容器运行时版本不达标时,节点即使打开了 v2 挂载,Kubernetes 相关特性也可能无法正常工作。规划节点镜像时务必把"内核 ≥ 5.8 + containerd ≥ 1.4 / cri-o ≥ 1.20 + systemd 驱动"作为一组整体要求来验收。
支持的 Linux 发行版
以下发行版默认(或从指定版本起)支持 CGroup v2:
| 发行版 | 支持 CGroup v2 的起始版本 |
|---|---|
| Container-Optimized OS | 从 M97 开始 |
| Ubuntu | 从 21.10 开始,推荐 22.04+ |
| Debian GNU/Linux | 从 Debian 11(Bullseye)开始 |
| Fedora | 从 31 开始 |
| Arch Linux | 从 2021 年 4 月开始 |
| RHEL 及类似 RHEL 的发行版 | 从 9 开始 |
更完整的官方列表可参阅 CGroup v2 文档(runc 仓库)。要检查你的发行版是否使用 CGroup v2,请参阅发行版文档,或使用下文的检测命令。
手动启用 CGroup v2
如果发行版默认未启用 v2,可以通过修改内核 cmdline 引导参数手动启用。若你的发行版使用 GRUB:
- 编辑
/etc/default/grub,在GRUB_CMDLINE_LINUX中添加systemd.unified_cgroup_hierarchy=1:
# /etc/default/grub 片段示例
GRUB_CMDLINE_LINUX="systemd.unified_cgroup_hierarchy=1"
# 如果该行已有其他参数,用空格追加即可,例如:
# GRUB_CMDLINE_LINUX="crashkernel=auto rhgb quiet systemd.unified_cgroup_hierarchy=1"
- 重新生成 GRUB 配置并重启:
sudo update-grub
sudo reboot
手动改内核参数属于兜底手段,官方推荐的方法仍是直接使用一个默认已启用 CGroup v2 的发行版,减少节点镜像维护成本。
识别 Linux 节点上的 CGroup 版本
CGroup 版本取决于正在使用的 Linux 发行版和操作系统上配置的默认 CGroup 版本。在节点上执行:
stat -fc %T /sys/fs/cgroup/
输出对照:
| 输出结果 | 含义 |
|---|---|
cgroup2fs | 该节点使用 CGroup v2 |
tmpfs | 该节点使用 CGroup v1 |
迁移到 CGroup v2
迁移步骤概括为:确保满足上文要求,然后升级到一个默认启用 CGroup v2 的内核版本。
kubelet 能够自动检测操作系统是否运行在 CGroup v2 上,并相应调整其操作,无需额外配置。
切换到 CGroup v2 时,用户体验应没有任何明显差异,除非有应用直接在节点上或从容器内访问 CGroup 文件系统。CGroup v2 使用一个与 v1 不同的 API,所有直接读取 cgroup 文件系统的应用都需要升级到支持 v2 的版本,典型影响清单如下:
| 应用类型 | 迁移要求 |
|---|---|
| 第三方监控 / 安全代理 | 依赖 CGroup 文件系统的代理需更新到支持 CGroup v2 的版本 |
| cAdvisor(以独立 DaemonSet 形式运行,用于监控 Pod 和容器) | 更新到 v0.43.0 或更高版本 |
| Java:OpenJDK / HotSpot | jdk8u372、11.0.16、15 及更高版本 |
| Java:IBM Semeru Runtimes | 8.0.382.0、11.0.20.0、17.0.8.0 及更高版本 |
| Java:IBM Java | 8.0.8.6 及更高版本 |
| Go:uber-go/automaxprocs | 确保使用 v1.5.1 或更高版本 |
| Node.js | 建议 v20.3.0 及以上;v18 发行线不能可靠地检测 CGroup v2 内存限制 |
补充说明几个容易踩坑的点:
- Node.js:从 v20.3.0 开始,Node.js 通过 libuv 读取 CGroup v2 内存限制。没有此支持的版本可能会读取主机的总内存,而不是应用于 Pod 的限制,这可能导致堆大小不正确和内存不足(OOM)终止。在受影响的版本上,应明确设置堆大小,例如使用
--max-old-space-size标志:
# 在 v18 等受影响版本上,显式指定 V8 老生代堆上限,避免误读宿主机总内存
node --max-old-space-size=512 app.js
- Java 应用:JVM 的容器感知(
UseContainerSupport)同样依赖对 cgroup 接口的正确读取,旧版本 JVM 在 v2 节点上可能按错误口径计算堆大小,务必升级到上表所列版本。
CGroup v1 已弃用
特性状态: 已弃用 since Kubernetes v1.35
Kubernetes 已弃用 CGroup v1,移除将遵循 Kubernetes 弃用策略。
默认情况下,kubelet 将不再在 CGroup v1 节点上启动。要禁用此设置(即继续在 v1 节点上运行 kubelet),集群管理员应在 kubelet 配置文件中将 failCgroupV1 设置为 false:
# kubelet 配置文件(KubeletConfiguration)片段
apiVersion: kubelet.config.k8s.io/v1beta1
kind: KubeletConfiguration
# v1.35 起 kubelet 默认在 CGroup v1 节点上启动失败;
# 仅在确需过渡使用 v1 节点时才显式关闭该失败行为
failCgroupV1: false
failCgroupV1: false 只是过渡期的逃生门。应尽快把节点滚动升级到默认启用 v2 的发行版,而不是长期依赖这个开关。
CGroup 驱动:systemd 与 cgroupfs
背景知识:kubelet 和容器运行时都需要选择一种接口来操作 cgroup,这就是 CGroup 驱动(cgroup driver),有两种选择:
| 驱动 | 工作方式 | 适用场景 |
|---|---|---|
| systemd | 由 systemd 作为 cgroup 层级的唯一管理者,kubelet / 运行时通过 systemd 的 DBus 接口创建和配置 slice/scope 单元 | 绝大多数现代发行版(默认使用 systemd init 的系统)的推荐选择 |
| cgroupfs | 直接读写 /sys/fs/cgroup 下的 cgroup 文件来创建和配置控制组 | 不使用 systemd 的极简系统(如某些嵌入式环境) |
为什么 kubelet 与容器运行时的驱动必须一致?
在同一个节点上,如果 kubelet 使用 systemd 驱动、而容器运行时使用 cgroupfs 驱动(或反过来),两者会在同一棵 cgroup 树上各自创建和管理自己的层级:一边通过 systemd 创建的单元,另一边看不到、还会按自己的理解去改写资源参数,最终互相覆盖对方的资源配置,出现资源限制不生效、进程被挂到错误的控制组等难以排查的问题。
因此铁律是:
- kubelet 与容器运行时必须使用同一种 CGroup 驱动;
- 使用 systemd 作为 init 系统的发行版上,推荐两者都用 systemd 驱动;
- kubeadm 部署的集群默认即采用 systemd 驱动,若运行时侧配置了
SystemdCgroup = true(containerd 的 CRI 配置),kubelet 侧对应配置cgroupDriver: systemd。
# containerd 配置 /etc/containerd/config.toml 片段:
# 运行时侧启用 systemd cgroup 驱动(与 kubelet 保持一致)
[plugins."io.containerd.grpc.v1.cri".containerd.runtimes.runc.options]
  SystemdCgroup = true
# kubelet 配置文件(KubeletConfiguration)片段:
# kubelet 侧同样使用 systemd 驱动
apiVersion: kubelet.config.k8s.io/v1beta1
kind: KubeletConfiguration
cgroupDriver: systemd
kubelet 如何按 QoS 分层创建 cgroup
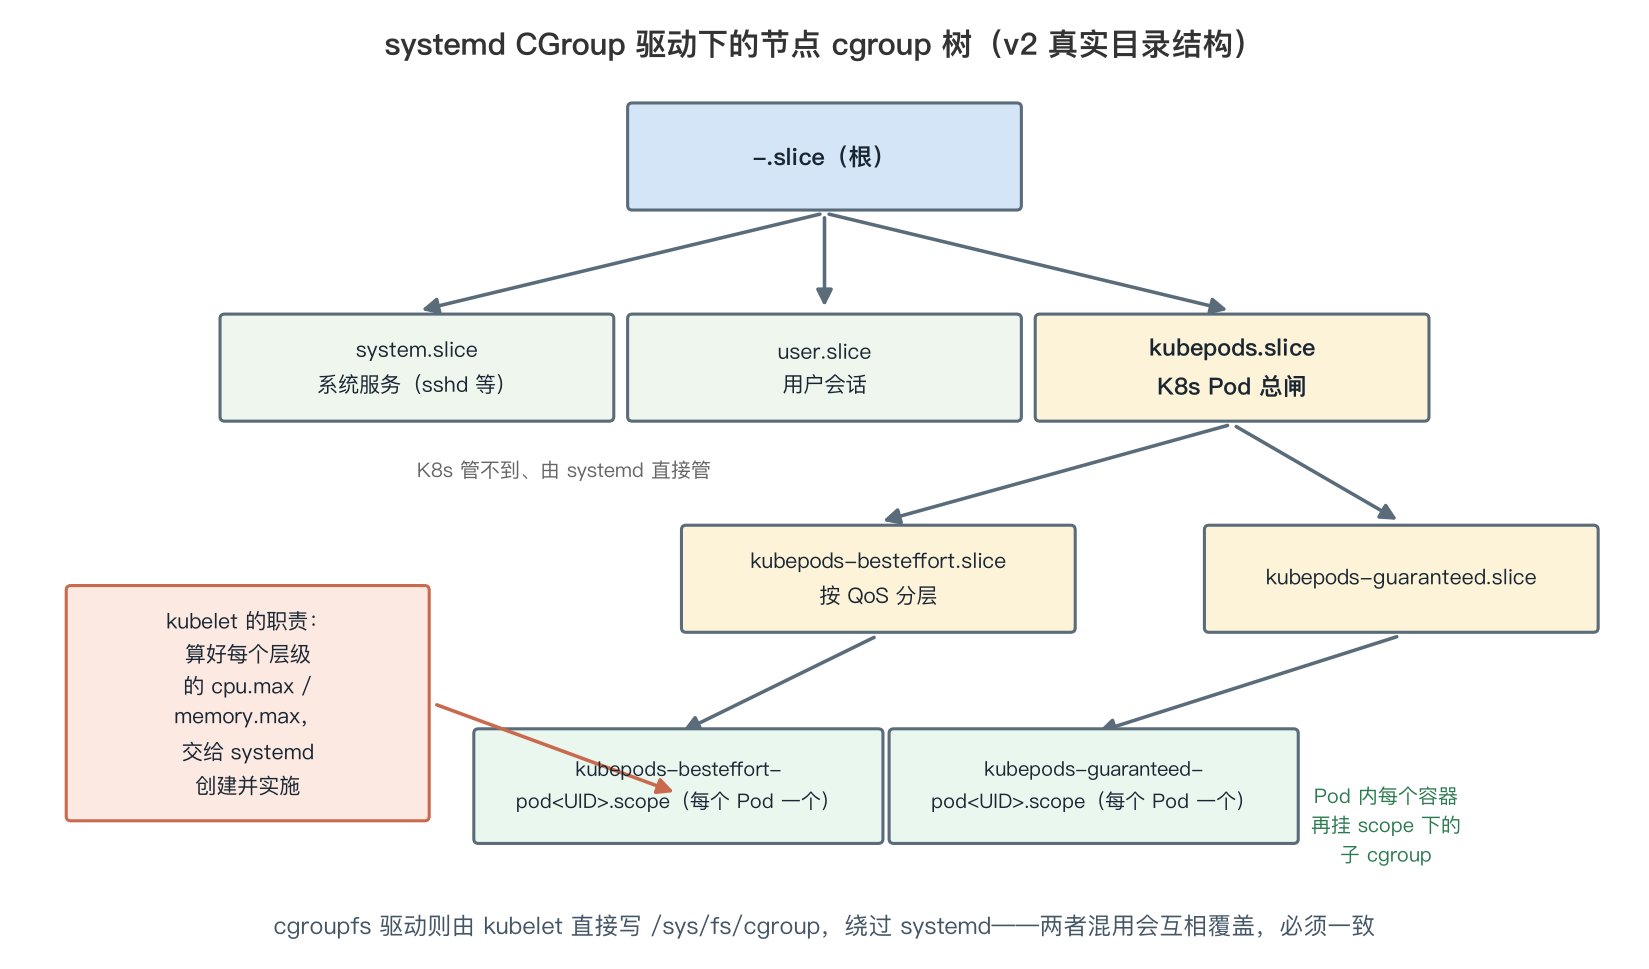
背景知识:在 systemd 驱动下,kubelet 会在节点的 cgroup 树上按 QoS 类(Guaranteed / Burstable / BestEffort) 分层组织 Pod 与容器的控制组,形成如下层级(以 CGroup v2 + systemd 命名风格示意):
-.slice                                  # 根 slice(systemd 根层级)
 └─ kubepods.slice                       # kubelet 管理的所有 Pod 的总控层级
     ├─ kubepods-guaranteed.slice        # QoS = Guaranteed 的所有 Pod
     │   └─ kubepods-guaranteed-pod<uid>.slice   # 单个 Pod 层级(Pod 级 cgroup)
     │       └─ <容器 cgroup>            # Pod 内各容器
     ├─ kubepods-burstable.slice         # QoS = Burstable 的所有 Pod
     │   └─ kubepods-burstable-pod<uid>.slice
     └─ kubepods-besteffort.slice        # QoS = BestEffort 的所有 Pod
         └─ kubepods-besteffort-pod<uid>.slice
这套分层设计的意义:
| 层级 | 作用 |
|---|---|
kubepods.slice(Pod 层级之上) | 为所有 Pod 汇总预留资源(配合 --kube-reserved、--system-reserved 把系统/kubelet 自身隔离在外) |
| QoS 层级(guaranteed / burstable / besteffort) | 按 QoS 类聚合同类 Pod,节点资源紧张时便于按 QoS 优先级施加压力与驱逐 |
Pod 层级(pod<uid>) | 实施 Pod 级的资源管理:Pod 的 limits 作用在这一层,Pod 内容器共享 Pod 级配额,且 Pod 级 cgroup 是 Pod 级资源管理特性(如 Pod 级 resources、Pod overhead 约束)的落点 |
| 容器层级 | 容器自身的 limits 在此生效 |
依赖 CGroup v2 的 Kubernetes 特性
一些 Kubernetes 特性专门使用 CGroup v2 来增强资源管理和隔离:
| 特性 | 依赖点 |
|---|---|
| MemoryQoS | 改进内存 QoS,依赖 CGroup v2 原语。相关配置细节可参阅 Pod QoS 类文档中"使用 CGroup v2 的 MemoryQoS"一节 |
| Pod 级 cgroup 资源管理 | Pod 级别的 CPU/内存资源管理落在 Pod 级 cgroup 上,借助 v2 的统一层级与统一内存核算实现更准确的 Pod 级约束 |
这意味着:节点若停留在 CGroup v1,上述特性要么无法启用,要么退化为较弱的行为。规划特性升级路线时,应把"节点全面迁移到 CGroup v2"列为前置条件。
迁移前后核对清单
将上述内容浓缩成一张核对表,便于逐节点执行:
| 步骤 | 操作 | 判定标准 |
|---|---|---|
| 1 | 检测当前 CGroup 版本 | stat -fc %T /sys/fs/cgroup/ 输出 cgroup2fs |
| 2 | 检查内核版本 | ≥ 5.8 |
| 3 | 检查容器运行时 | containerd ≥ 1.4 或 cri-o ≥ 1.20 |
| 4 | 检查 CGroup 驱动一致性 | kubelet 与运行时均为 systemd 驱动 |
| 5 | 排查直接读 cgroup 文件系统的组件 | 监控/安全代理、独立部署的 cAdvisor(≥ 0.43.0)、JVM/Node.js 版本达标 |
| 6 | 如需手动启用 | GRUB_CMDLINE_LINUX 加 systemd.unified_cgroup_hierarchy=1 后 update-grub 并重启 |
| 7 | 确认未停留在 v1 | v1.35 起 kubelet 默认不在 v1 节点启动 |
下面这张图展示 systemd CGroup 驱动下的节点 cgroup 树形态,可作为第 4、5 步的参照:
kubelet 创建 Pod 的 CGroup 流程
结合前文的 QoS 分层与驱动一致性要求,kubelet 创建一个 Pod 时的 CGroup 工作流程大致如下:
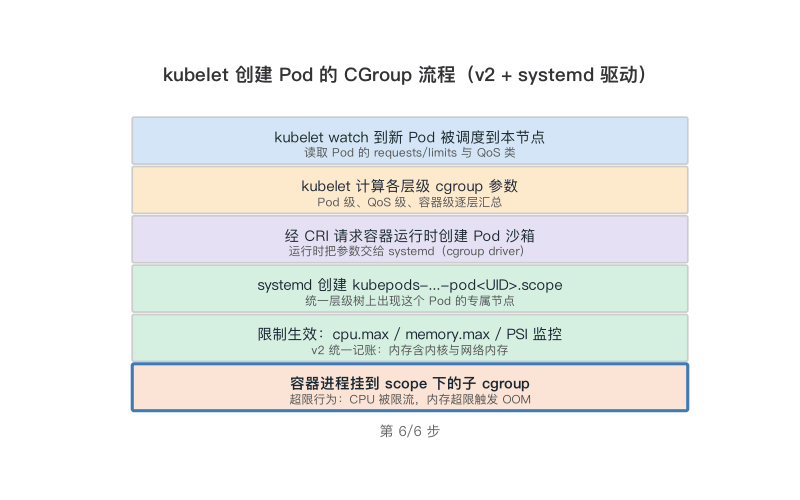
流程要点:
- kubelet 通过 CRI 向容器运行时下发 PodSandbox / 容器创建请求,请求中携带资源参数与目标 cgroup 路径;
- 运行时按 kubelet 的驱动约定(systemd 或 cgroupfs)在节点 cgroup 树上定位/创建 Pod 级与容器级控制组;
- 内核依据控制组中的 CPU/内存参数对进程组实施约束,v2 节点上同时获得统一内存核算与 PSI 等增强能力。
我的总结与避坑清单
- 先看版本再谈特性:
stat -fc %T /sys/fs/cgroup/是迁移第一命令,输出cgroup2fs才是 v2 节点;输出tmpfs说明还是 v1,v1.35 起 kubelet 默认拒绝在 v1 节点启动。 - 版本要求打包记忆:内核 ≥ 5.8、containerd ≥ 1.4、cri-o ≥ 1.20、systemd 驱动,四项缺一不可,验收节点镜像时逐项打勾。
- 驱动一致性是命门:kubelet 与容器运行时混用 systemd / cgroupfs 驱动会互相覆盖资源配置,问题表现为限制不生效、行为诡异且难排查;用 systemd init 的系统一律统一为 systemd 驱动。
- kubelet 无需配置即可适配 v2:kubelet 自动检测 CGroup 版本并调整行为,不要画蛇添足地为"启用 v2"去改 kubelet 参数。
- 真正要升级的是"直接读 cgroup 文件系统的东西":第三方监控/安全代理、独立 DaemonSet 部署的 cAdvisor(≥ 0.43.0),迁移前先盘点这类组件。
- JVM 应用重点核查版本:OpenJDK 需 jdk8u372 / 11.0.16 / 15+,IBM Semeru 需 8.0.382.0 / 11.0.20.0 / 17.0.8.0+,IBM Java 需 8.0.8.6+,否则堆大小可能算错。
- Go 服务注意 automaxprocs:使用 uber-go/automaxprocs 时升级到 v1.5.1 及以上,旧版在 v2 节点上读取不到正确的 CPU 配额。
- Node.js 用 v20.3.0+:v18 无法可靠读取 CGroup v2 内存限制,会按宿主机总内存估算堆,可能引发 OOM;受影响版本务必显式
--max-old-space-size。 - 手动启用 v2 走 GRUB:
GRUB_CMDLINE_LINUX追加systemd.unified_cgroup_hierarchy=1后执行update-grub并重启;但这只是兜底,优先选默认启用 v2 的发行版(Ubuntu 22.04+、Debian 11+、Fedora 31+、RHEL 9+ 等)。 - v1 已弃用不等于立刻不可用:v1.35 起 v1 被弃用且 kubelet 默认在 v1 节点启动失败,过渡期可用 kubelet 配置
failCgroupV1: false强行继续,但应尽快完成节点升级,不要长期依赖该开关。 - 依赖 v2 的特性提前规划:MemoryQoS、Pod 级 cgroup 资源管理等特性专门依赖 CGroup v2 原语,想用这些特性就必须先把节点迁到 v2。
- 理解 QoS 分层有助于排障:kubepods.slice → guaranteed/burstable/besteffort → pod<uid> 的层级结构决定了 Pod 资源约束的作用位置,排查"限制为什么不生效"时先确认进程实际挂在哪个控制组。

