CronJob详解
CronJob 按时间表周期性地创建 Job——一个 CronJob 对象就像 crontab 文件里的一行。它本身不直接管 Pod:到点创建 Job,Job 再创建 Pod。用于备份、报告生成、定期清理这类排期操作(GA since v1.21)。
调度链条
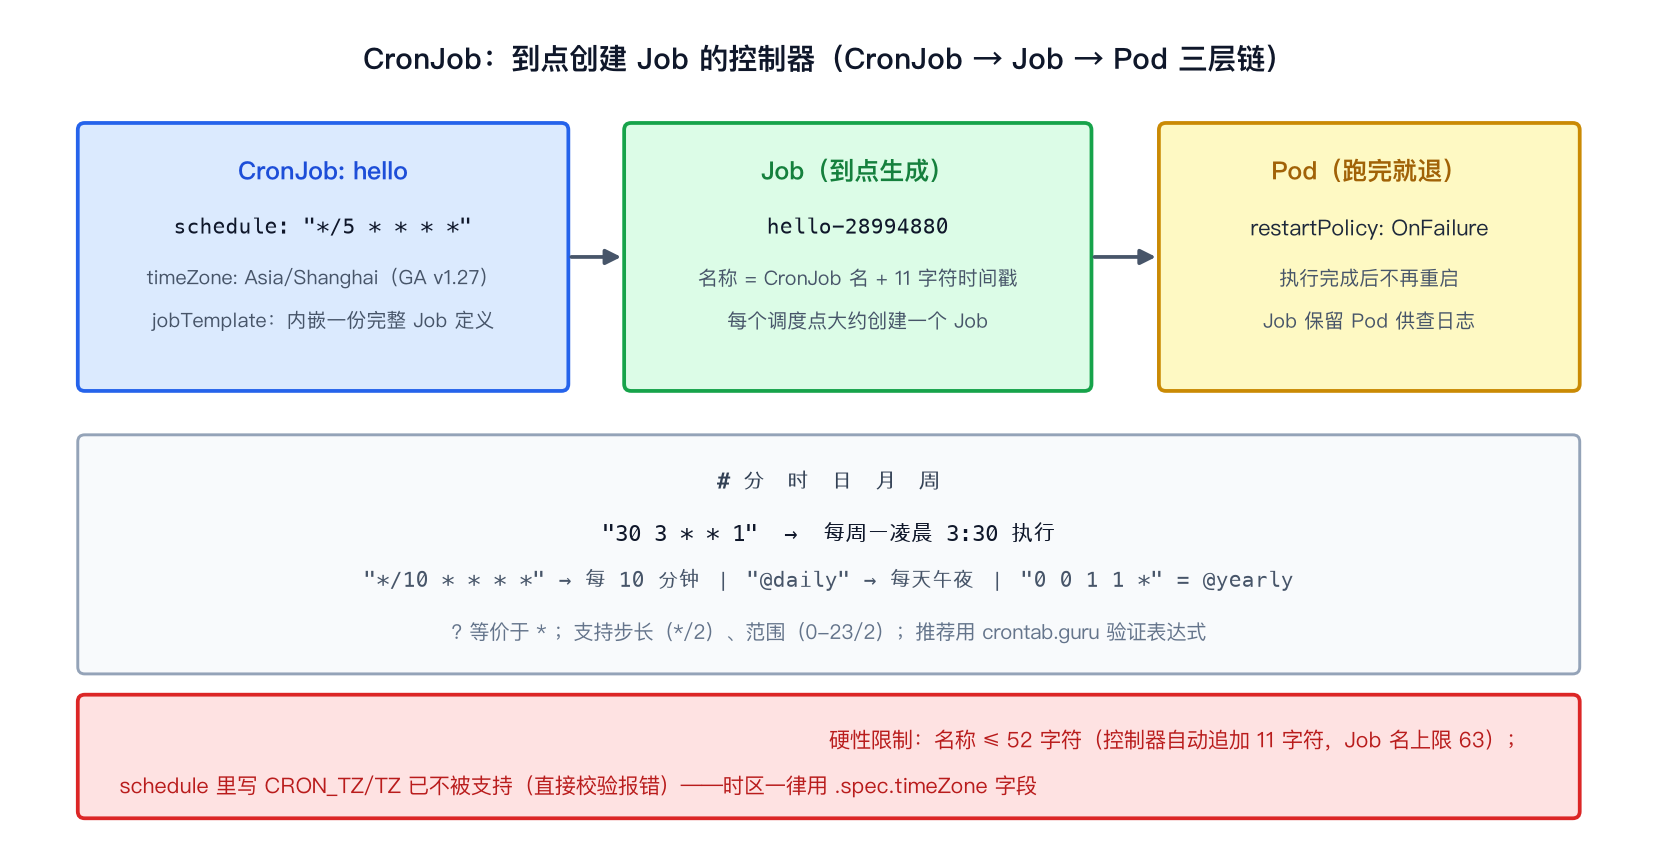
三层链要分清职责:CronJob 管"什么时候"、Job 管"跑几次算成功"、Pod 管"怎么跑"。修改 CronJob 的模板只影响之后创建的 Job——已经运行的 Job 不会被动更新。
创建示例
cat > cronjob.yaml << 'EOF'
apiVersion: batch/v1
kind: CronJob
metadata:
  name: hello                    # 名称 ≤ 52 字符(控制器会追加 11 字符生成 Job 名)
spec:
  schedule: "*/1 * * * *"        # 【必需】cron 表达式:分 时 日 月 周;这里是每分钟
  timeZone: "Asia/Shanghai"      # 【重要】不写则按 kube-controller-manager 的本地时区解释;
                                 # schedule 里的 CRON_TZ/TZ 写法已不被支持(校验直接报错)
  concurrencyPolicy: Allow       # 上一次没跑完下一次又到点时的策略(见下文三选一)
  startingDeadlineSeconds: 60    # 可选:错过调度时间后最多允许多少秒内补启动,超时视为失败
  successfulJobsHistoryLimit: 3  # 保留几个成功的历史 Job(默认 3)
  failedJobsHistoryLimit: 1      # 保留几个失败的历史 Job(默认 1);排查失败就靠它们
  # suspend: true                # 挂起后续调度(已运行的 Job 不受影响)
  jobTemplate:                   # 【必需】内嵌一份完整的 Job spec(无 apiVersion/kind)
    spec:
      template:
        spec:
          restartPolicy: OnFailure   # Job 的约束同样适用:Never 或 OnFailure
          containers:
          - name: hello
            image: busybox:1.28
            imagePullPolicy: IfNotPresent
            command:
            - /bin/sh
            - -c
            - date; echo Hello from the Kubernetes cluster
EOF

kubectl apply -f cronjob.yaml
kubectl get cronjob hello
# NAME   SCHEDULE    TIMEZONE        SUSPEND   ACTIVE   LAST SCHEDULE   AGE
# hello  */1 * * * * Asia/Shanghai   False     0        26s             82s
观察它产生的 Job 和 Pod(Job 名 = CronJob 名 + 11 字符时间戳,如 hello-28994880):
kubectl get jobs --watch
kubectl get pods --selector=job-name=hello-28994880
cron 表达式速记
# ┌───────── 分钟 (0-59)
# │ ┌───────── 小时 (0-23)
# │ │ ┌───────── 日 (1-31)
# │ │ │ ┌───────── 月 (1-12)
# │ │ │ │ ┌───────── 星期 (0-6,0=周日)
# * * * * *
| 写法 | 含义 |
|---|---|
0 3 * * 1 | 每周一凌晨 3:00 |
*/10 * * * * | 每 10 分钟 |
0 0 1 * * | 每月 1 号午夜(= @monthly) |
@daily / @hourly / @yearly | 每天午夜 / 每小时整点 / 每年 1 月 1 日午夜 |
0-23/2 | 范围 + 步长:每两小时 |
? 等价于 *。复杂表达式建议用 crontab.guru 之类工具先验证。
concurrencyPolicy:重叠了怎么办
| 策略 | 行为 | 适用 |
|---|---|---|
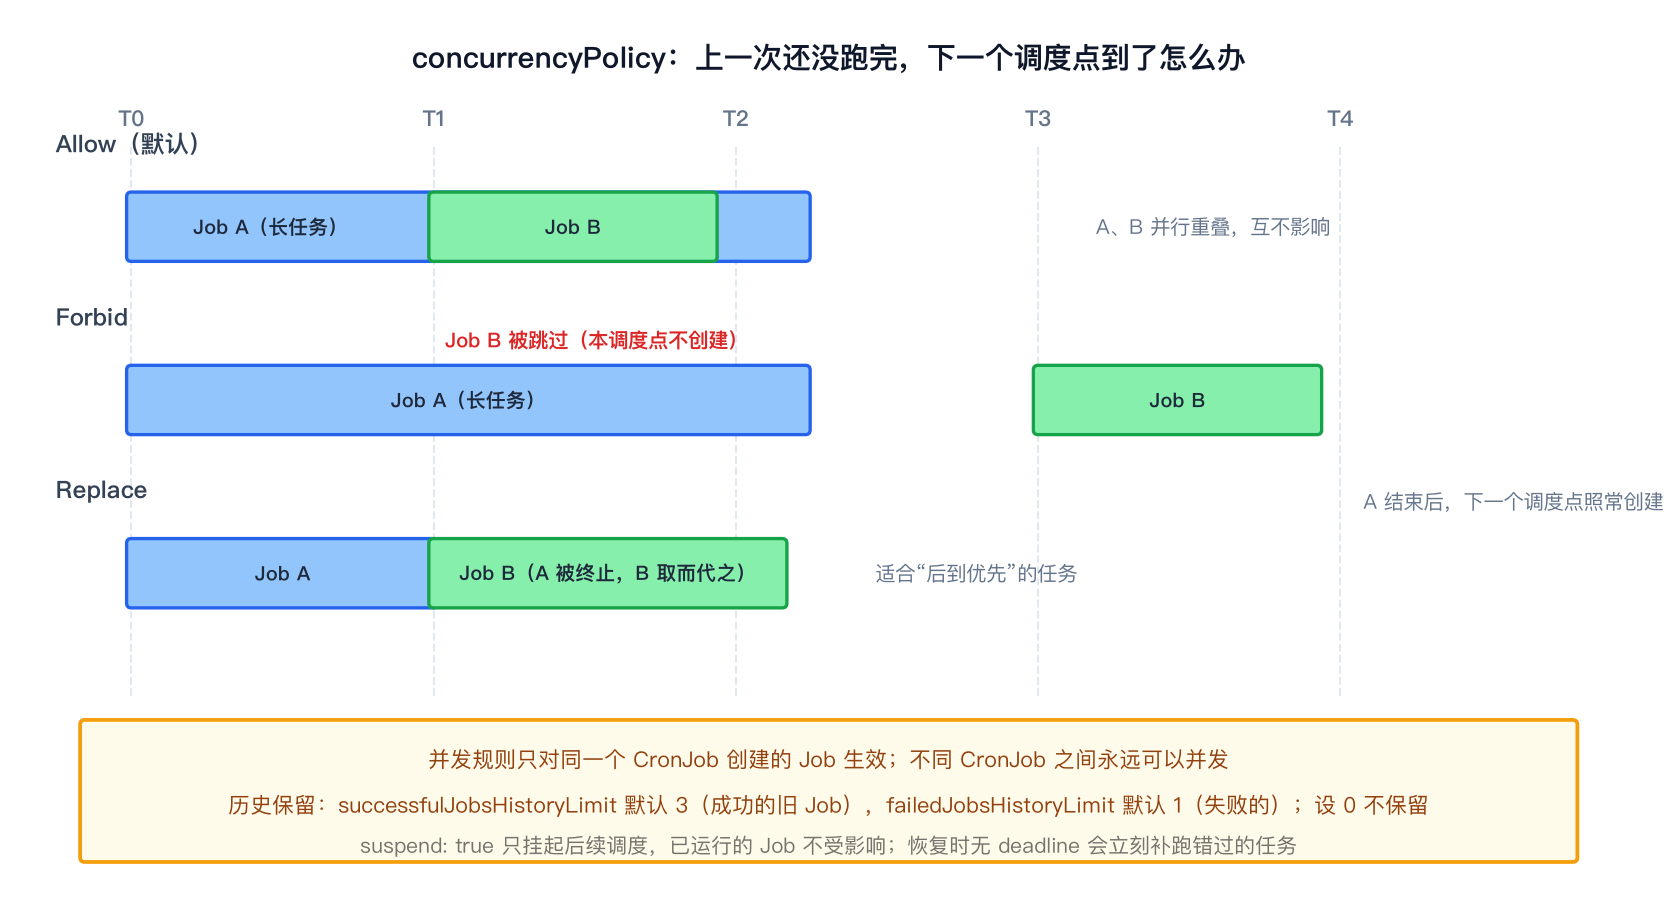
Allow(默认) | 允许重叠,新旧 Job 并行 | 任务之间无依赖、可重入 |
Forbid | 上一次没跑完就跳过本次调度 | 备份类任务:宁愿少跑不能乱跑 |
Replace | 终止正在跑的旧 Job,用新 Job 顶替 | 只关心最新数据的同步类任务 |
两个容易踩的点:并发规则只对同一个 CronJob 创建的 Job 生效,不同 CronJob 之间永远可以并发;Forbid 跳过的调度会被计入"错过次数"(见下文 100 次限制)。
startingDeadlineSeconds:错过调度的处理
- 不设置 = 没有截止时间,错过的调度一直"欠着";
- 设置后(如 200):从预期调度时间起算,超过 200 秒还没创建 Job 就跳过本次(未来的照常调度);
- 100 次限制:控制器检查错过的调度次数,超过 100 次就不再启动并报错
too many missed start time(s)...——典型场景:Forbid的长任务把后续调度全堵成"错过",或控制器停了俩小时。设了startingDeadlineSeconds后则只统计最近 N 秒内的错过次数,控制器恢复后能继续跑; - 低于 10 秒可能无法调度:CronJob 控制器每 10 秒才检查一轮。
官方例子值得记住:每分钟一次、无 deadline,控制器从 08:29 停到 10:21 → 错过超 100 次,Job 不再启动;若设了 startingDeadlineSeconds: 200,控制器只看最近 200 秒(3 次错过),10:22 起恢复正常。
挂起与历史清理
kubectl patch cronjob hello --type=strategic --patch '{"spec":{"suspend":true}}'
suspend: true只停后续调度,已在跑的 Job 不动;恢复时若没设 deadline,错过的任务会被立即补跑(暂停期间的调度都记为"错过");- 历史 Job 清理:
successfulJobsHistoryLimit(默认 3)/failedJobsHistoryLimit(默认 1),超出的旧 Job 被自动删除——排查失败问题前别把失败历史设成 0; - Job 内部还有
ttlSecondsAfterFinished可做更细的清理。
我的总结与避坑清单
- 任务必须幂等:官方明说 CronJob 偶尔会创建两个 Job 或一个都不创建("大约"创建一个),不能完全杜绝——重复执行不能出事。
- 改了 CronJob 不会影响正在跑的 Job:想"改完立刻生效",先 suspend 或删掉正在跑的 Job。
- 时区三个坑:不写 timeZone 按 controller-manager 本地时区(集群时区不对定时任务就全错);
CRON_TZ/TZ已不支持;夏令时时区切换可能导致跳过或重复执行。 - Forbid + 长任务 = 静默停跑:一直 Forbid 一直错过,超过 100 次后彻底不跑(只报事件不报错给用户)。长任务配 Forbid 时务必设
startingDeadlineSeconds并监控kubectl get cronjob的 LAST SCHEDULE。 - 失败排查靠 failedJobsHistoryLimit 保留的现场:
kubectl get jobs找到失败的 Job,再进 Pod 看日志;默认只留 1 个,密集失败时会互相覆盖,排查期可临时调大。 - CronJob 名称 ≤ 52 字符:别到 63 字符上限才想起来还有 11 字符时间戳后缀。
- 备份/报告类建议 Forbid + deadline + 幂等三件套:这是官方文档给出的组合拳。
- v1.32 起创建的 Job 带
batch.kubernetes.io/cronjob-scheduled-timestamp注解(RFC3339),可用于核对"实际执行时间 vs 计划时间"的偏差。
常用操作命令
kubectl get cronjobs                          # 列出所有定时任务
kubectl describe cronjob hello                # 看配置、事件、当前活跃 Job
kubectl create job --from=cronjob/hello manual-run-1   # 手动触发一次(不等排期)
kubectl patch cronjob hello --type=strategic \
  --patch '{"spec":{"suspend":true}}'         # 暂停 / 恢复改回 false
kubectl delete cronjob hello                  # 删除(已创建的 Job 与 Pod 一并清理)
kubectl create job --from=cronjob/... 是排查时的利器:手动触发一次,观察完整执行过程而不必等到下一个调度点。

