节点
Kubernetes 通过将容器放入在**节点(Node)**上运行的 Pod 中来执行工作负载。节点可以是虚拟机或者物理机器,取决于集群配置。每个节点包含运行 Pod 所需的服务,节点由控制面负责管理。通常集群中会有若干个节点;学习或资源受限环境中,集群也可能只有一个节点。
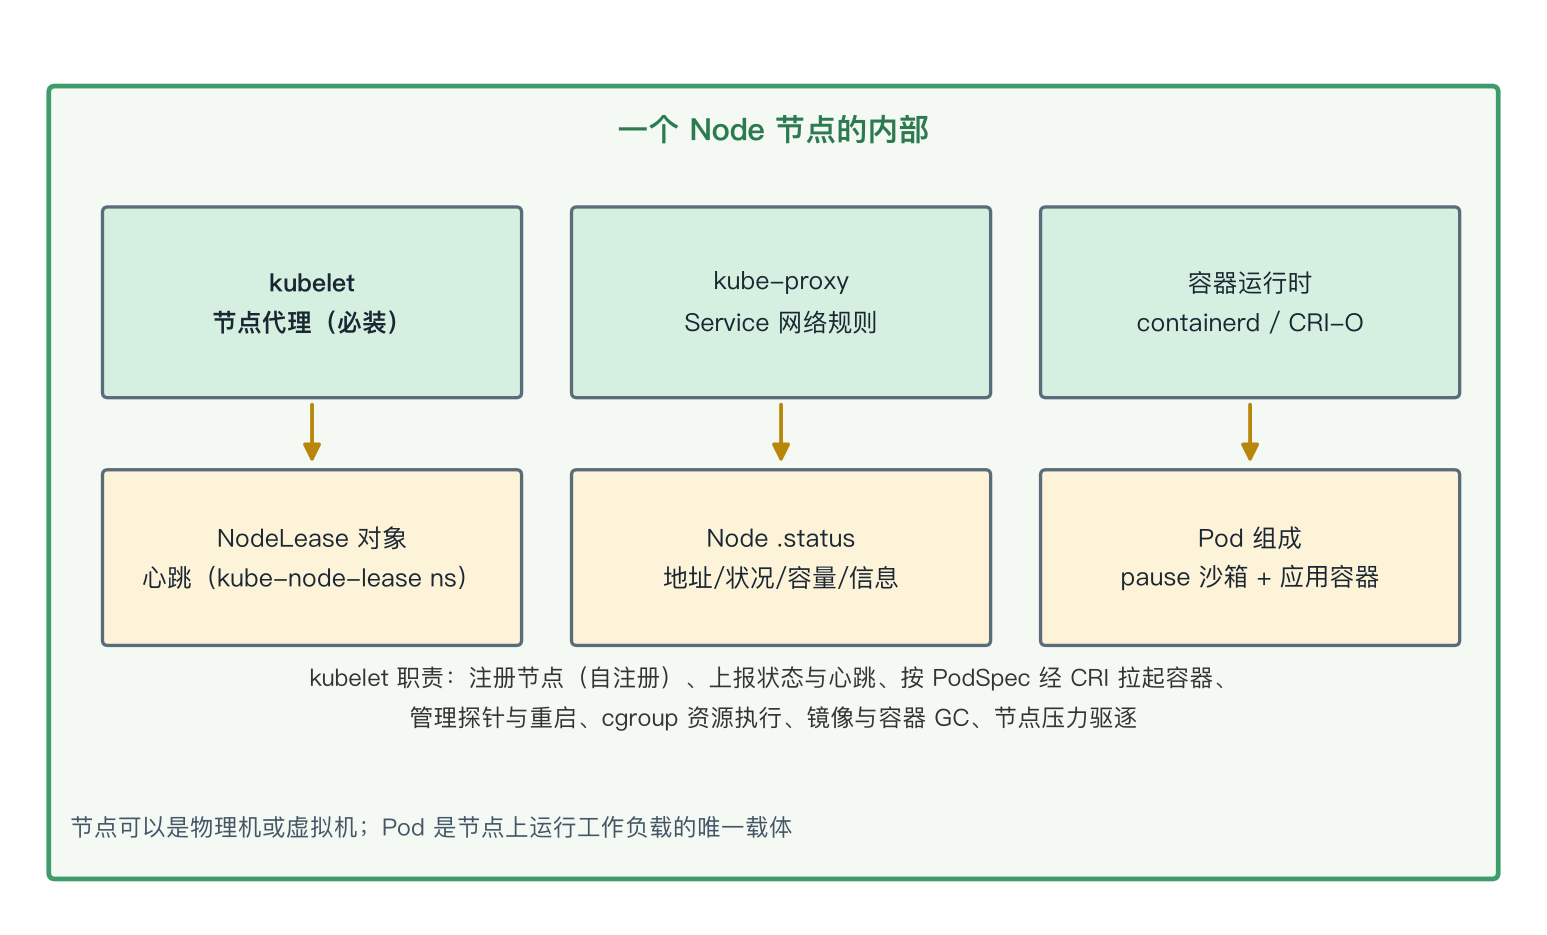
节点上的组件包括 kubelet、容器运行时以及 kube-proxy。下面这张图展示了一个 Node 节点内部的组成:
官方文档参考
| 文档 | 链接 |
|---|---|
| 节点(官方中文) | https://kubernetes.io/zh-cn/docs/concepts/architecture/nodes/ |
节点的管理
向 API 服务器添加节点的方式主要有两种:
| 方式 | 说明 |
|---|---|
| 自注册 | 节点上的 kubelet 向控制面执行自注册(首选模式,绝大多数发行版选用) |
| 手动管理 | 你(或其他人)手动添加一个 Node 对象;此时需设置 kubelet 标志 --register-node=false |
无论哪种方式,控制面都会检查新的 Node 对象是否合法。例如用如下 JSON 创建 Node 对象:
{
  "kind": "Node",
  "apiVersion": "v1",
  "metadata": {
    "name": "10.240.79.157",
    "labels": {
      "name": "my-first-k8s-node"
    }
  }
}
Kubernetes 会在内部创建一个 Node 对象作为节点的表示,并检查 kubelet 向 API 服务器注册节点时使用的 metadata.name 字段是否匹配。如果节点是健康的(即所有必要的服务都在运行中),则该节点可以用来运行 Pod;否则,直到该节点变为健康之前,所有的集群活动都会忽略该节点。
Node 对象的名称必须是合法的 DNS 子域名。
Kubernetes 会一直保存着非法节点对应的对象,并持续检查该节点是否已经变得健康。你必须(或通过某个控制器)显式删除该 Node 对象,才能停止健康检查操作。测试误建的 Node 对象记得手动清理。
节点自注册与 --register-node
当 kubelet 标志 --register-node 为 true(默认)时,它会尝试向 API 服务器注册自己。自注册模式下 kubelet 使用下列参数启动:
| 参数 | 说明 |
|---|---|
--kubeconfig | 用于向 API 服务器执行身份认证所用的凭据的路径 |
--cloud-provider | 与某云驱动进行通信,以读取与自身相关的元数据 |
--register-node | 自动向 API 服务器注册 |
--register-with-taints | 使用所给的污点列表(逗号分隔的 <key>=<value>:<effect>)注册节点;当 register-node 为 false 时无效 |
--node-ip | 可选的、以英文逗号隔开的节点 IP 地址列表,每个地址簇只能指定一个地址(如单协议栈 IPv4 集群中设置为 kubelet 应使用的节点 IPv4 地址)。若未提供,kubelet 优先使用节点默认的 IPv4 地址;没有 IPv4 则使用默认 IPv6 地址 |
--node-labels | 在集群中注册节点时要添加的标签(受 NodeRestriction 准入控制插件实施的标签限制) |
--node-status-update-frequency | 指定 kubelet 向 API 服务器发送其节点状态的频率 |
当 Node 鉴权模式和 NodeRestriction 准入插件被启用后,仅授权 kubelet 创建/修改自己的 Node 资源。
手动节点管理
可以修改 Node 对象(忽略 --register-node 设置),例如修改节点上的标签或将其标记为不可调度。通过在节点上添加一个或多个 node-role.kubernetes.io/<role>: <role> 标签来设置可选的节点角色(<role> 受标签键名格式规则限制;Kubernetes 会忽略标签的值,按惯例将其设置为与键中的 <role> 相同的字符串)。
可以结合节点上的标签和 Pod 上的选择算符来控制调度,例如限制某 Pod 只能在符合要求的节点子集上运行。
标记节点为不可调度(unschedulable)会阻止新 Pod 调度到该节点上,但不影响已经在其上运行的 Pod,这是重启节点或维护前的有用准备步骤:
kubectl cordon $NODENAME # 标记节点为不可调度,新 Pod 不会再调度上来
被 DaemonSet 控制器创建的 Pod 能够容忍节点的不可调度属性。DaemonSet 通常提供节点本地服务(如日志采集、网络插件),即使节点上的应用负载已被腾空,这些服务也仍需运行在节点之上。
节点名称唯一性
节点的名称用来标识 Node 对象,没有两个 Node 可以同时使用相同的名称。Kubernetes 还假定名字相同的资源是同一个对象:就 Node 而言,隐式假定使用相同名称的实例会具有相同的状态(例如网络配置、根磁盘内容)和类似节点标签这类属性。这可能在节点被更改但其名称未变时导致系统状态不一致。
如果某个 Node 需要被替换或者大量变更,需要先从 API 服务器移除现有的 Node 对象,之后再在更新之后重新将其加入。
例如 kubelet 重启时传了新的 --node-labels,但同一个 Node 名称已被使用,所作变更不会起作用——节点标签是在 Node 注册到 API 服务器时完成(或修改)的。重启期间配置若发生变化,已调度到该 Node 的 Pod 可能行为不正常(如已运行的 Pod 通过污点机制设置了与新标签相排斥的规则、不兼容的 Pod 被调到同一节点)。节点重新注册可以确保节点上所有 Pod 被排空并正确重新调度。
节点状态
一个节点的状态包含以下信息,可用 kubectl describe node <节点名称> 查看:
| 要素 | 内容 |
|---|---|
| 地址(Addresses) | 节点的地址信息(如 HostName、InternalIP、ExternalIP 等) |
| 状况(Condition) | 节点的健康状态(如 Ready、MemoryPressure、DiskPressure、PIDPressure、NetworkUnavailable) |
| 容量与可分配(Capacity / Allocatable) | 节点的资源容量与可分配给 Pod 的资源量 |
| 信息(Info) | 节点的一般信息,如内核版本、Kubernetes 版本、容器运行时版本、操作系统等 |
节点心跳
Kubernetes 节点发送的心跳帮助集群确定每个节点的可用性,并在检测到故障时采取行动。心跳有两种形式:
| 心跳形式 | 说明 |
|---|---|
更新节点的 .status | kubelet 定期上报节点状态(频率由 --node-status-update-frequency 控制) |
kube-node-lease 命名空间中的 Lease(租约)对象 | 每个节点都有一个关联的 Lease 对象,kubelet 定期续约 |
节点控制器
节点控制器是 Kubernetes 控制面组件,管理节点的方方面面,在节点的生命周期中扮演多个角色:
| 角色 | 职责 |
|---|---|
| 分配 CIDR 区段 | 节点注册时为它分配一个 CIDR 区段(如果启用了 CIDR 分配) |
| 与云服务商同步节点列表 | 保持节点控制器内的节点列表与云服务商所提供的可用机器列表同步;云环境下若某节点不健康,节点控制器会询问云服务该节点的虚拟机是否仍可用,不可用则将节点从列表删除 |
| 监控节点健康状况 | 在节点不可达时,将 Node 的 .status 中 Ready 状况更新为 Unknown;若节点仍无法访问,对不可达节点上的所有 Pod 触发 API 发起的逐出操作 |
监控健康状况的细节:默认情况下节点控制器每 5 秒检查一次节点状态(可用 kube-controller-manager 的 --node-monitor-period 参数配置);在将节点标记为 Unknown 后默认等待 5 分钟提交第一个驱逐请求。
逐出速率限制与可用区策略
大部分情况下,节点控制器把逐出速率限制在每秒 --node-eviction-rate 个(默认 0.1),即每 10 秒钟内至多从一个节点驱逐 Pod。
当一个可用区(Availability Zone)中的节点变为不健康时,驱逐行为会改变。节点控制器同时检查该可用区中不健康(Ready 状况为 Unknown 或 False)节点的百分比:
| 条件 | 驱逐策略 |
|---|---|
不健康节点比例超过 --unhealthy-zone-threshold(默认 0.55)且集群较小(节点数 ≤ --large-cluster-size-threshold,默认 50) | 驱逐操作停止 |
| 不健康节点比例超过阈值、集群较大 | 驱逐速率降为每秒 --secondary-node-eviction-rate 个(默认 0.01) |
| 某可用区所有节点都不健康 | 以正常速率 --node-eviction-rate 驱逐(因为可用区整体故障时应让工作负载转移到健康可用区) |
| 所有可用区都不健康(集群中没有健康节点) | 节点控制器假设控制面与节点间的连接出了问题,停止所有驱逐动作;故障后部分节点重新连接时,再从剩下不健康或不可达节点中驱逐 Pod |
逐个可用区实施这些策略的原因:当一个可用区可能从控制面脱离时,其它可用区可能仍然保持连接。如果集群没有跨越云服务商的多个可用区,那整个集群就只有一个可用区。
节点控制器还负责驱逐运行在拥有 NoExecute 污点的节点上的 Pod(除非这些 Pod 能容忍此污点),并根据节点故障(如节点不可访问或没有就绪)为其添加污点,从而让调度器不会将 Pod 调度到不健康的节点上。
资源容量跟踪
Node 对象会跟踪节点上资源的容量(例如可用内存和 CPU 数量):
- 通过自注册机制生成的 Node 对象会在注册期间报告自身容量。
- 手动添加的 Node,需要在添加节点时手动设置节点容量。
Kubernetes 调度器保证节点上有足够的资源供其上的所有 Pod 使用:它会检查节点上所有容器的请求总和不超过节点容量。该总请求包括由 kubelet 启动的所有容器,但不包括由容器运行时直接启动的容器,也不包括不受 kubelet 控制的其他进程。
节点的 Capacity 与 Allocatable 之间可以留出系统预留(如 --system-reserved、--kube-reserved),为非 Pod 进程显式保留资源,防止系统守护进程与业务 Pod 抢占 CPU/内存导致节点不稳定。
节点拓扑
如果启用了 TopologyManager 特性门控,kubelet 可以在作出资源分配决策时使用拓扑提示。这是自 Kubernetes 1.27 起就稳定的功能(相关特性门控已移除,无法再手动开关),详细策略见官方"控制节点上拓扑管理策略"任务文档。
我的总结与避坑清单
- 节点接入的两条路:默认走 kubelet 自注册(
--register-node=true);手动建 Node 对象时记得把 kubelet 设为--register-node=false,否则会打架。 - Node 对象名字必须是合法 DNS 子域名,且全局唯一;换机器/大改节点时先删旧 Node 对象再重新注册,复用同名会带来标签不生效、Pod 互斥规则被打破等诡异问题。
kubectl cordon只拦新 Pod,不动已运行 Pod;要连存量一起搬走用kubectl drain(内部会先 cordon 再驱逐)。- DaemonSet Pod 不理会 cordon/驱逐(自带容忍),日志、监控、CNI 代理这类节点本地服务需要靠它保持存活。
- 节点故障驱逐默认节奏要背下来:每 5 秒检查一次(
--node-monitor-period)、标记Unknown后等 5 分钟才发第一个驱逐请求、正常驱逐速率 0.1 个/秒。 - 可用区策略的本质是"防雪崩 + 防误杀":区域内部分不健康时放慢或停止驱逐(默认阈值 0.55、小集群上限 50 节点),整个可用区挂了反而按正常速率驱逐以便把负载赶到健康可用区,全集群都不健康则完全停止驱逐(大概率是控制面失联而非节点全挂)。
- 调度器只看"kubelet 管理的容器"的 requests 总和,容器运行时直接启动的进程不在其中;给系统守护进程留资源要显式配置预留,否则节点容易被业务 Pod 压满。
- 心跳两条通道:
.status更新偏慢偏重、Lease 续约轻量,大规模集群主要依赖 Lease 判断节点存活。

