控制器
在机器人技术和自动化领域,控制回路(Control Loop) 是一个非终止回路,用于调节系统状态。Kubernetes 中的控制器通过监控集群的公共状态,并致力于将当前状态转变为期望状态。
官方文档参考
| 项目 | 链接 |
|---|---|
| 控制器(官方中文文档) | kubernetes.io/zh-cn/docs/concepts/architecture/controller |
控制回路与恒温器类比
以房间里的温度自动调节器(恒温器)为例:
- 你设置了温度,就等于告诉了恒温器你的期望状态(Desired State);
- 房间的实际温度就是当前状态(Current State);
- 通过对设备的开关控制,恒温器让其当前状态接近期望状态。
Kubernetes 的控制器正是以同样的方式工作:不断观测集群状态、做出调整、再观测,循环往复,永不终止。
控制器模式
一个控制器至少追踪一种类型的 Kubernetes 资源。这些对象有一个代表期望状态的 spec 字段,该资源的控制器负责确保其当前状态接近期望状态。
控制器执行动作的两种典型模式:
| 模式 | 工作方式 | 典型例子 |
|---|---|---|
| 通过 API 服务器控制 | 控制器不亲自执行操作,而是向 API 服务器发送消息,由控制面其他组件做出反应 | Job 控制器 |
| 直接控制 | 控制器直接与集群外部系统通信,使当前状态接近期望状态,之后将结果报告给 API 服务器 | 集群节点水平扩容控制器 |
通过 API 服务器控制(Job 控制器例子)
Job 是一种 Kubernetes 资源,它运行一个或多个 Pod 来执行一个任务然后停止。Job 控制器是 Kubernetes 内置控制器,它通过与集群 API 服务器交互来管理状态:
- 当 Job 控制器拿到新任务时,它会保证一组 Node 节点上的
kubelet可以运行正确数量的 Pod 来完成工作; - Job 控制器不会自己运行任何 Pod 或容器,而是通知 API 服务器来创建或移除 Pod;
- 控制面中的其它组件(如调度器、kubelet)根据新的消息作出反应,调度并运行新 Pod,最终完成工作;
- 控制器也会更新配置对象:一旦 Job 的工作完成,Job 控制器会将 Job 对象的状态更新为
Finished。
这有点像温度自动调节器关闭了一个灯,以此来告诉你房间的温度已经到达你设定的值了。
直接控制(集群扩容控制器例子)
有些控制器需要对集群外的一些东西进行修改:
- 如果你使用一个控制回路来保证集群中有足够的节点,那么控制器就需要调用当前集群外的一些服务,在需要时创建新节点;
- 和外部状态交互的控制器从 API 服务器获取它想要的状态,然后直接和外部系统进行通信并使当前状态更接近期望状态;
- 实际上存在一个可以水平扩展集群节点的控制器(如 cluster-autoscaler,位于 kubernetes/autoscaler 项目)。
这里的重点是:控制器做出了一些变更以使事物更接近期望状态,之后将当前状态报告给集群的 API 服务器。其他控制回路可以观测到所汇报数据的变化并采取各自行动。
就 Kubernetes 集群而言,控制面间接地与 IP 地址管理工具、存储服务、云驱动 APIs 以及其他服务协作,通过扩展 Kubernetes 来实现这一点。
期望状态 vs 当前状态
Kubernetes 采用了系统的云原生视图,并且可以处理持续的变化:
| 概念 | 含义 |
|---|---|
| 期望状态 | 对象 spec 字段中声明的目标状态,由用户或上层控制器设定 |
| 当前状态 | 集群中对象此刻的实际状态,记录在对象的 status 字段中 |
在任务执行时,集群随时都可能被修改,并且控制回路会自动修复故障。这意味着集群很可能永远不会达到稳定状态。只要集群中的控制器在运行并进行有效的修改,整体状态稳定与否是无关紧要的。
设计原则:多个简单控制器而非单体
作为设计原则之一,Kubernetes 使用了很多控制器,每个控制器管理集群状态的一个特定方面:
- 最常见的模式是:一个特定的控制器使用一种类型的资源作为它的期望状态,控制另外一种类型的资源向它的期望状态演化;
- 例如,Job 控制器跟踪 Job 对象(以发现新任务)和 Pod 对象(以运行 Job、查看任务何时完成)。新任务会创建 Job,而 Job 控制器会创建 Pod;
- 使用简单的、彼此独立的控制器,而不是一组相互连接的单体控制回路是很有用的——控制器会失败,Kubernetes 的设计正是考虑到了这一点,单个控制器失效不会拖垮整个系统。
多个控制器操作同类对象时靠标签区分
可以有多个控制器来创建或者更新相同类型的对象。在后台,Kubernetes 控制器确保它们只关心与其控制资源相关联的资源。
例如,你可以创建 Deployment 和 Job,它们都可以创建 Pod。Job 控制器不会删除 Deployment 所创建的 Pod,因为有信息(标签/Label 以及所有权引用)让控制器可以区分这些 Pod。
调和循环(Reconcile Loop)
控制器的核心工作机制就是"调和"(Reconcile):观测当前状态 → 与期望状态对比 → 执行动作缩小差距 → 再次观测,如此循环。
控制器不断循环这一过程,直到当前状态与期望状态一致:
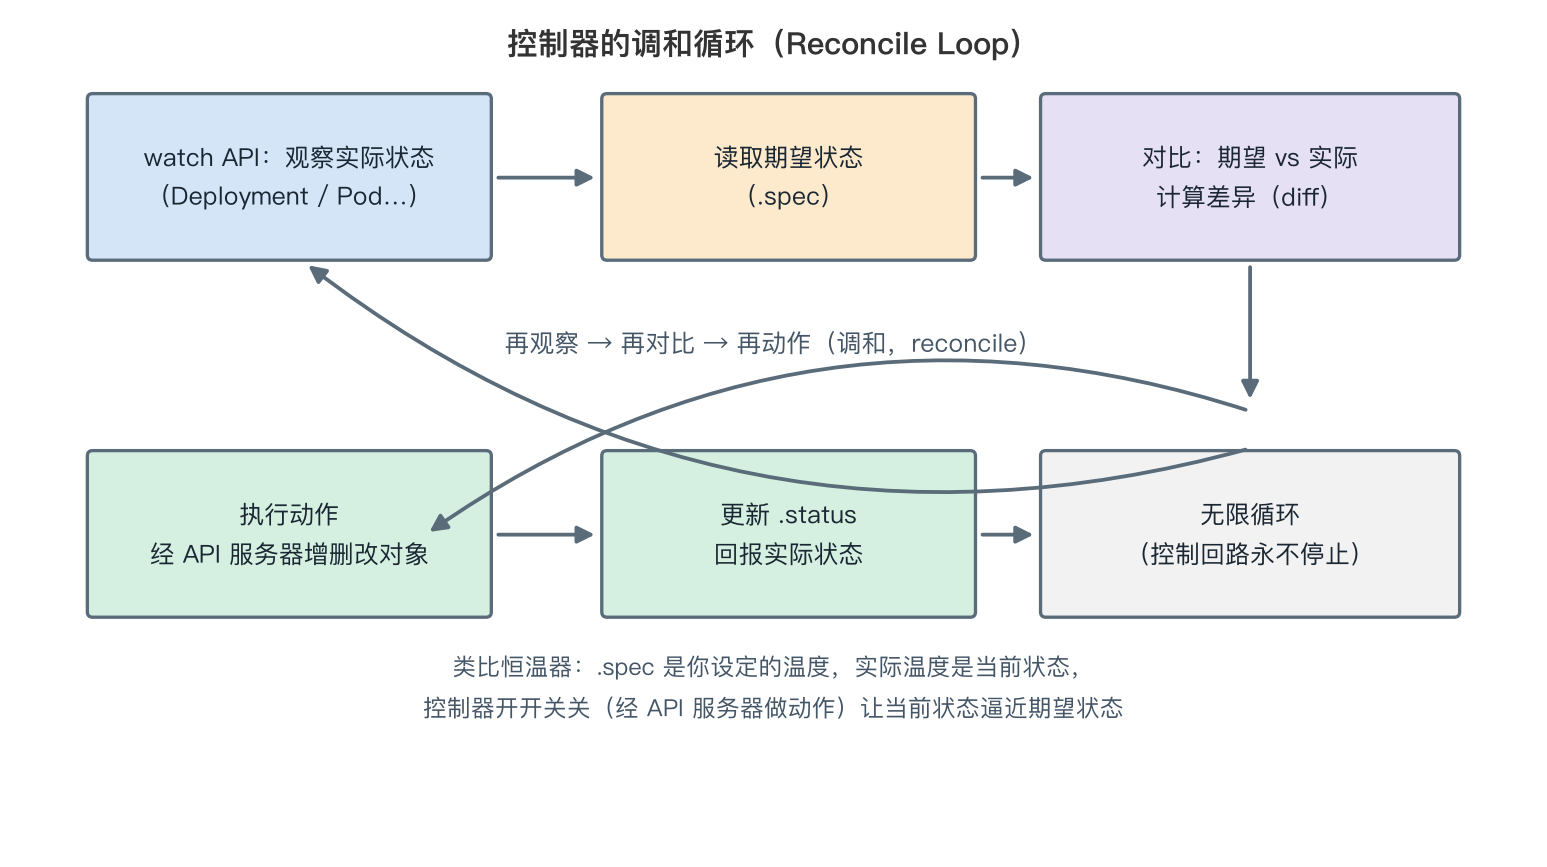
下面这个 GIF 直观演示了 Deployment 控制器如何通过调和循环把 Pod 副本数量拉回到期望值:
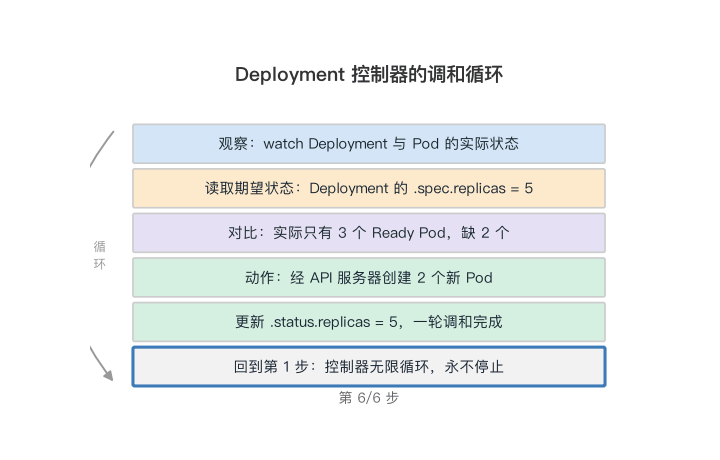
控制器 = 恒温器:读 spec(期望)、看 status(当前)、干活补差价,周而复始,永不停止。
内置控制器的运行位置
Kubernetes 内置一组控制器,运行在 kube-controller-manager 内,这些内置控制器提供了重要的核心功能:
| 要点 | 说明 |
|---|---|
| 运行位置 | kube-controller-manager(控制面组件) |
| 典型例子 | Deployment 控制器、Job 控制器 |
| 容错设计 | Kubernetes 允许你运行一个稳定的控制平面,即使某些内置控制器失败了,控制平面的其他部分会接替它们的工作 |
| 控制面外的控制器 | 某些控制器运行在控制面之外,用以扩展 Kubernetes |
自定义控制器
除了内置控制器,你也可以自己编写新控制器:
- 自定义控制器可以以一组 Pod 的形式运行在集群内,也可以运行在 Kubernetes 之外,最合适的方案取决于控制器所要执行的功能;
- 编写自定义控制器可参考 Kubernetes 扩展模式以及官方的 sample-controller 样例项目。
控制器是控制回路而非守护进程式的业务服务:它的职责是持续调和状态,而不是处理请求。把业务逻辑塞进控制器循环里做高频操作,会造成大量无谓的 API 请求和资源浪费。
我的总结与避坑清单
- 控制器的本质是"恒温器"式控制回路:读期望状态(
spec)、观测当前状态(status)、执行动作缩小差距,永不终止。 - 区分两种控制模式:Job 控制器通过 API 服务器间接干活(自己不跑 Pod);节点扩容类控制器则直接和集群外部系统(云 API)打交道。
- 集群永远处于"变化中",不要指望绝对稳定态;控制器在持续调和,这本身就是 Kubernetes 处理故障的方式。
- Deployment 和 Job 都会创建 Pod,但互不干扰——靠的是标签和所有权引用区分,自定义控制器也应遵循这一模式。
- 内置控制器都跑在 kube-controller-manager 里,排查副本数不对、Job 卡住等问题时优先看它的日志。
- 不要在控制回路里做重活:调和循环应尽量幂等、轻量,重操作交给下游组件异步完成。
- 自定义控制器优先考虑用成熟框架(如 controller-runtime / Kubebuilder)编写,并通过 Deployment 方式部署在集群内。

