Kubernetes自我修复
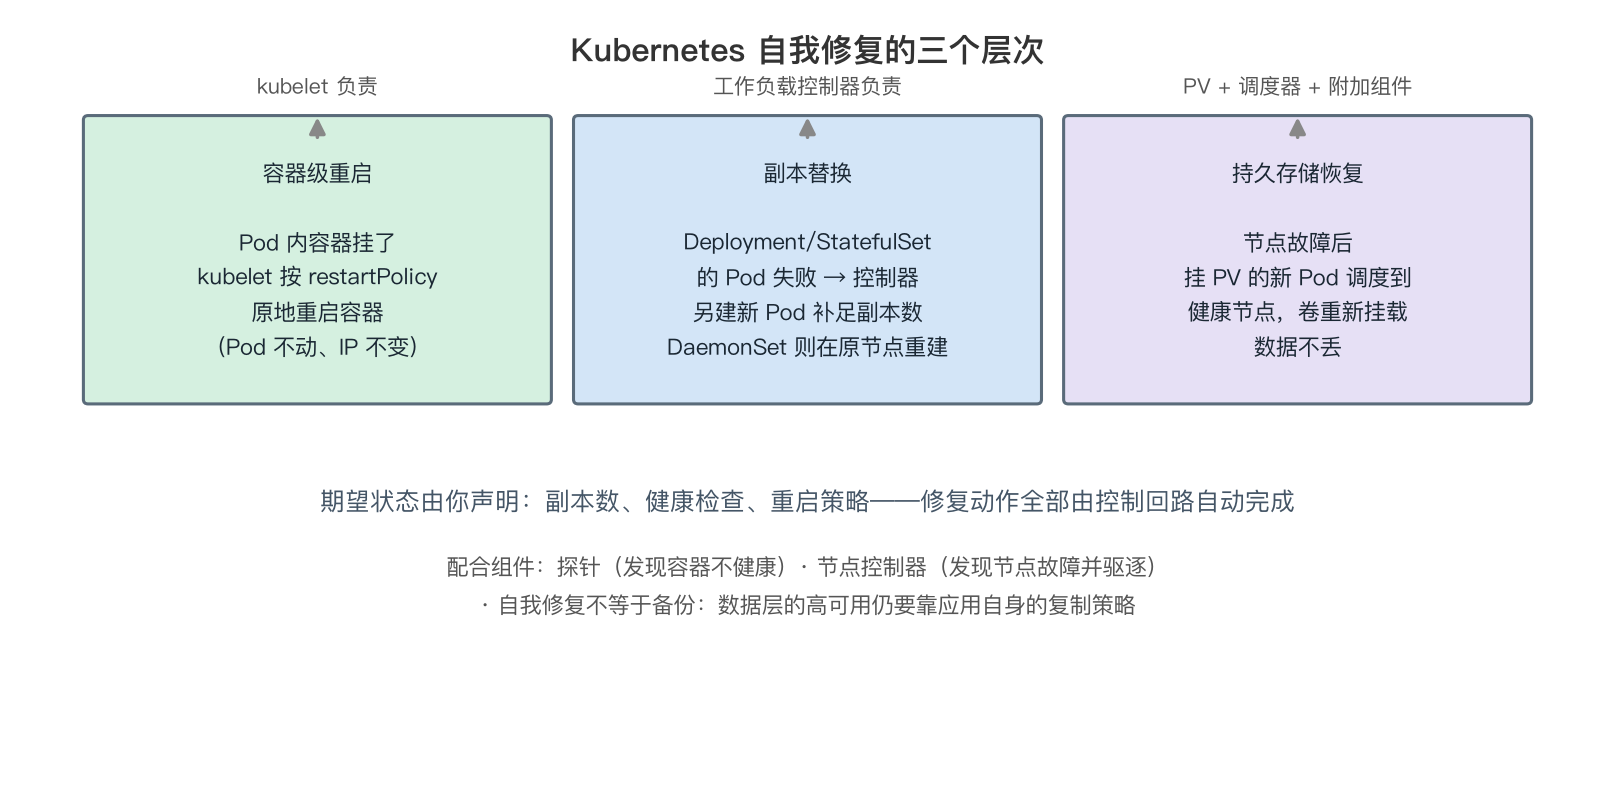
Kubernetes 旨在通过自我修复能力来维护工作负载的健康和可用性。它能够自动替换失败的容器,在节点不可用时重新调度工作负载,并确保系统的期望状态得以维持。
官方文档参考
| 官方文档 | 链接 |
|---|---|
| Kubernetes 自我修复(中文) | kubernetes.io/zh-cn/docs/concepts/architecture/self-healing |
官方定义的三大自我修复能力
| 能力 | 触发场景 | Kubernetes 的行为 |
|---|---|---|
| 容器级重启 | Pod 中的某个容器失败 | 根据 restartPolicy 定义的策略重启此容器 |
| 副本替换(Deployment / StatefulSet) | Deployment 或 StatefulSet 中的某个 Pod 失败 | 创建一个替代 Pod,以维持指定的副本数量 |
| 副本替换(DaemonSet) | DaemonSet 中的某个 Pod 失败 | 控制平面会在同一节点上创建一个替代 Pod |
| 持久存储恢复 | 运行挂载了持久卷(PV)的 Pod 的节点发生故障 | 可以将该卷重新挂载到另一个节点上的新 Pod |
容器级重启:restartPolicy
容器级修复的粒度最小:如果 Pod 中的某个容器失败,kubelet 会根据 restartPolicy 定义的策略重启此容器。restartPolicy 可以取以下值:
| 取值 | 行为 | 典型场景 |
|---|---|---|
Always | 容器退出后总是重启 | 常驻服务,也是 Deployment/StatefulSet/DaemonSet 的唯一合法值 |
OnFailure | 仅在容器非零退出(失败)时重启 | 一次性任务,失败后希望重试 |
Never | 不重启 | 一次性任务,失败后由上层逻辑处理 |
apiVersion: v1
kind: Pod
metadata:
  name: self-healing-demo
spec:
  restartPolicy: Always   # 容器失败时按策略自动重启,Pod 整体不重建
  containers:
    - name: app
      image: nginx:1.27
容器级重启发生在同一个 Pod 内,由 kubelet 执行,Pod 的元数据、IP 地址、挂载的卷都保持不变。只有当整个 Pod 失败且无法通过重启容器恢复时,才会由上层控制器走副本替换的路径。
副本替换:维持期望副本数
对于 Deployment 和 StatefulSet,如果其中某个 Pod 失败,Kubernetes 会创建一个替代 Pod,以维持指定的副本数量。这是声明式期望状态(spec 中声明的 replicas)与实际状态之间的持续调和。
对于 DaemonSet,如果某个 Pod 失败,控制平面会在同一节点上创建一个替代 Pod——因为 DaemonSet 的语义是每个节点上都要运行一个 Pod 副本,替换时不能换节点。
apiVersion: apps/v1
kind: Deployment
metadata:
  name: web
spec:
  replicas: 3          # 期望副本数,某 Pod 失败后控制器会补足
  selector:
    matchLabels:
      app: web
  template:
    metadata:
      labels:
        app: web
    spec:
      containers:
        - name: nginx
          image: nginx:1.27
持久存储恢复:PV 重新挂载
如果某个节点正在运行一个挂载了持久卷(PV)的 Pod,且该节点发生故障,Kubernetes 可以将该卷重新挂载到另一个节点上的新 Pod。配合 StatefulSet 这类有状态工作负载,数据卷会跟随 Pod 的替代实例,保证状态不丢。
自我修复背后的工作机制(结合官方架构与 Pod 生命周期扩展)
官方自我修复页面内容精炼,但其效果依赖控制平面和数据平面的多个机制协同:
| 机制 | 角色 | 与自我修复的关系 |
|---|---|---|
| 声明式期望状态 | API 对象的 spec 字段(如 replicas) | 所有修复的出发点:控制器不断把实际状态调回期望状态 |
| 探针(liveness / readiness / startup) | kubelet 对容器的健康探测 | liveness 探针失败会按容器策略重启容器;readiness 探针失败会把 Pod 从 Service Endpoints 摘除 |
| restartPolicy | Pod spec 字段 | 决定容器失败后是否重启、何时重启 |
| 控制器调和循环 | Deployment / StatefulSet / DaemonSet 控制器 | 发现实际副本数少于期望副本数时创建替代 Pod |
| 节点控制器 | 控制平面组件 | 监测节点健康状况,节点不可达时对其上的 Pod 执行驱逐,由对应工作负载控制器在健康节点上重新调度 |
节点故障的检测依赖超时阈值,节点控制器要等待一段时间确认节点不可达后才会将其上的 Pod 标记并驱逐。因此"节点宕机后 Pod 自动漂移"并不是秒级完成的,对可用性要求极高的服务要同时依赖应用层的多副本与优雅退出。
Kubernetes 只能修复它"知道期望状态"的对象。裸 Pod(不归任何控制器管理)挂掉后只会按 restartPolicy 在原地重启,不会被重新调度到其他节点;只有 Deployment、StatefulSet、DaemonSet 这类工作负载资源声明的 Pod 才能享受副本替换级别的修复。生产环境应避免直接创建裸 Pod。
我的总结与避坑清单
- 自我修复分三个层次:容器级重启(restartPolicy)、副本替换(Deployment/StatefulSet 建替代 Pod,DaemonSet 在原节点重建)、持久存储恢复(PV 重新挂载到新节点上的新 Pod)。
- 区分两个关键词:容器重启发生在同一 Pod 内(IP、卷不变),副本替换会创建全新的 Pod(新 IP、重新调度),排查问题时先判断故障发生在哪一层。
- DaemonSet 的替换 Pod 一定在原节点上创建,这与 Deployment 换节点重建的行为不同,不要混用预期。
- Deployment/StatefulSet 的 Pod 模板中
restartPolicy只能是Always,OnFailure/Never只适合裸 Pod 或 Job 类工作负载。 - 裸 Pod 没有控制器兜底,节点故障后不会被重新调度;务必用工作负载资源声明应用。
- 节点故障驱逐有检测延迟,自我修复不是瞬时生效,关键业务要靠多副本 + 反亲和分散风险。
- PV 能否重新挂载取决于存储驱动的挂载模式与卷的附加/分离行为,选择 StorageClass 时要确认其支持多节点读写或快速分离重挂载的能力。

