拓扑分布约束
[toc]
引言
你部署了一个 3 副本的 Deployment,调度器"贴心"地把三个副本全部放到了同一个节点上——然后这个节点宕机,服务整体不可用。这不是 bug,而是调度器的默认行为:调度器只保证"放得下",不保证"放得散"。Pod 拓扑分布约束(Pod Topology Spread Constraints)就是官方给出的答案:告诉调度器"把同类 Pod 尽量均匀地铺开到各个可用区/节点/机架上"。
本文面向已了解基础调度概念(见 将Pod调度到指定节点 和 污点和容忍度)的读者,逐字段讲透 maxSkew、whenUnsatisfiable、topologyKey 三大核心参数,并给出可直接运行的完整示例。
官方文档参考
以上链接均为 Kubernetes 中文官网地址,已逐一验证有效。
1. 为什么需要拓扑分布约束
先看反面教材。一个普通的 3 副本 Deployment,没有分布约束时可能被调度成:
节点 node1          节点 node2         节点 node3
[pod] [pod] [pod]   (空)             (空)
三个副本同宿一节点,至少有三类问题:
- 可用性问题:node1 宕机 = 服务全灭,多副本的容灾意义归零;
- 资源争抢问题:三个副本挤在 node1 上互相抢 CPU/内存,node2、node3 却闲置;
- 滚动更新风险:滚动更新时新旧副本全部落在同一节点,一次重启波动放大三倍。
有了拓扑分布约束后,调度器会尽量铺开:
节点 node1   节点 node2   节点 node3
[pod]        [pod]        [pod]
"拓扑域"由节点标签定义。常见的域划分方式:
kubernetes.io/hostname——每个节点一个域(按节点打散)topology.kubernetes.io/zone——按云厂商可用区打散(如北京一区/二区)topology.kubernetes.io/region——按地域打散- 自定义标签——按机架、电源域、机房等物理结构打散
这些标签由 kubelet 或云厂商自动打在节点上,可用 kubectl get nodes --show-labels 查看。
2. 与节点亲和性的区别:管"能不能来",不管"来几个"
新手常混淆拓扑分布约束与 节点亲和性,二者定位完全不同:
| 维度 | 节点亲和性(affinity) | 拓扑分布约束(topologySpreadConstraints) |
|---|---|---|
| 回答的问题 | "这个 Pod 能不能/愿不愿去某些节点?" | "同类 Pod 在各拓扑域中分布够不够均匀?" |
| 作用对象 | 单个 Pod 与节点集合的关系 | 新 Pod 与已存在 Pod 群落的关系 |
| 软硬控制 | required(硬)/ preferred(软) | DoNotSchedule(硬)/ ScheduleAnyway(软) |
| 统计依据 | 不统计已有 Pod | 按 labelSelector 统计各域中已有 Pod 数 |
两者是互补关系而非替代关系:亲和性圈定"候选节点范围",分布约束在范围内决定"怎么摆最匀"。实际生产中经常组合使用。
3. 三个核心字段逐个讲透
topologySpreadConstraints:
  - maxSkew: 1                          # 允许的最大分布不均匀度
    topologyKey: topology.kubernetes.io/zone   # 用哪个标签划分拓扑域
    whenUnsatisfiable: DoNotSchedule    # 不满足约束时怎么办
    labelSelector:                      # 统计哪些"同类 Pod"
      matchLabels:
        app: my-app
3.1 maxSkew:允许"歪"多少
官方定义:maxSkew 描述这些 Pod 可能被不均匀分布的程度,必须大于零。计算公式:
skew = 某个拓扑域中匹配 Pod 的数量 − 全局最小值
(全局最小值 = 所有符合条件域中匹配 Pod 的最小数量)
约束要求:每个符合条件的域的 skew 都不得超过 maxSkew。
举例:3 个可用区分别有 2、2、1 个匹配 Pod,全局最小值为 1:
- zone-a 的 skew = 2 − 1 = 1
- zone-b 的 skew = 2 − 1 = 1
- zone-c 的 skew = 1 − 1 = 0
此时 maxSkew: 1 满足;若设 maxSkew: 0,则要求所有域 Pod 数完全相等(实践中几乎不可满足,慎用)。
maxSkew: 1 是生产环境最常见取值:允许各域数量差最多 1,兼顾均匀性与调度灵活性。数值越大,分布越"歪",容灾效果越差。
3.2 topologyKey:按什么维度"分堆"
topologyKey 是节点标签的键。官方定义:如果节点使用此键标记并且具有相同的标签值,则将这些节点视为处于同一拓扑域中。调度器把每个域内节点上匹配 labelSelector 的 Pod 数加总,参与 skew 计算。
同一个 key 不同的 value 就是一个独立的域:
节点           topology.kubernetes.io/zone 标签值    所属域
node1, node2   zone-a                                域 1
node3, node4   zone-b                                域 2
node5          zone-c                                域 3
注意:没有该标签的节点不属于任何域,也就不会参与调度计算——如果集群里所有节点都缺少该标签,带硬约束的 Pod 将永远 Pending。
3.3 whenUnsatisfiable:不满足时是"拒绝"还是"将就"
官方定义:指示如果 Pod 不满足分布约束时如何处理。
| 取值 | 行为 | 类比 |
|---|---|---|
DoNotSchedule(默认) | 硬约束:找不到满足约束的节点就 Pending | 类似 requiredDuringScheduling 亲和 |
ScheduleAnyway | 软约束:照样调度,但优先选择能让 skew 更小的节点 | 类似 preferredDuringScheduling 亲和 |
ScheduleAnyway 的"软"体现在排序上:调度器仍会调度 Pod,只是给能降低偏差的域更高的优先级分数。
DoNotSchedule 意味着"宁可不上线也不破坏均匀性"。如果可用区数量不足以放下副本数(比如 3 副本但只有 2 个可用区、maxSkew: 1 时第 3 个副本无处可放),Pod 会一直 Pending。此时要么降低 maxSkew 对应的期望,要么改用 ScheduleAnyway,要么配合 minDomains 调整全局最小值逻辑。
3.4 labelSelector:统计谁
labelSelector 用于查找"要被均匀分布"的那批 Pod——调度器统计每个拓扑域中带有该标签的已有 Pod 数量。因此 labelSelector 必须能匹配到这批 Pod 自身的标签(通常与工作负载的 selector 一致),否则调度器看到的"同类 Pod"数量永远是 0,均匀性计算就失去了意义。
4. maxSkew 计算图解
假设集群 5 个节点分属两个可用区,现有 3 个 app=my-app 的 Pod 分布如下:
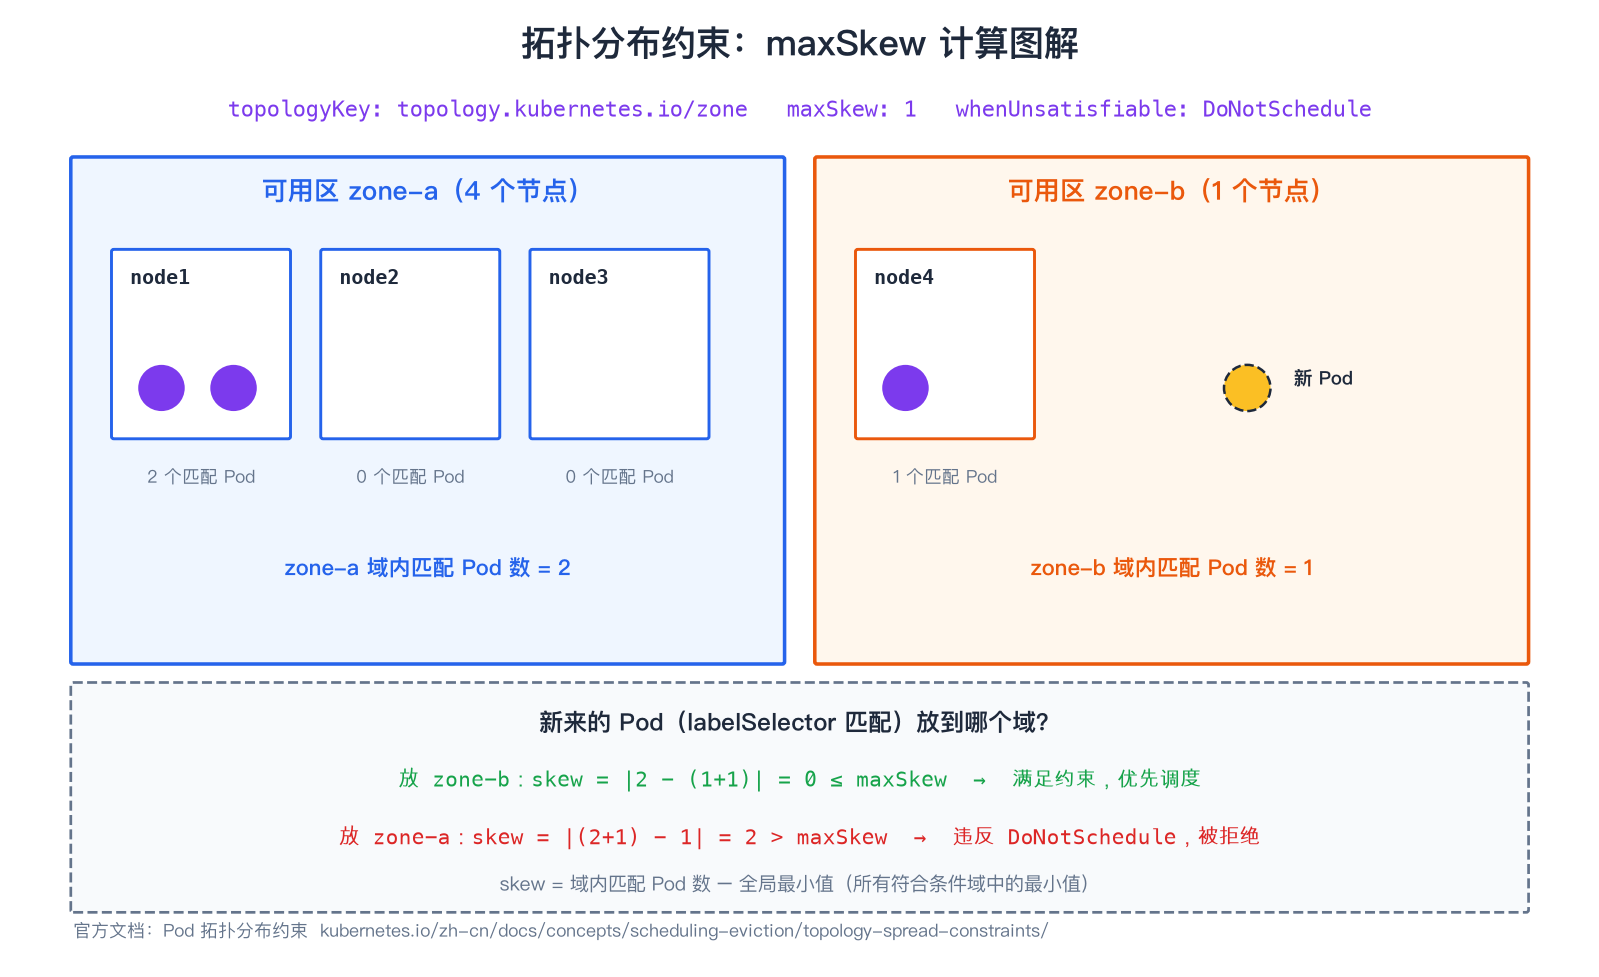
新 Pod 到来时,调度器逐域试算 skew:放入 zone-b 后 skew 为 0,满足约束;放入 zone-a 则 skew 为 2,超过 maxSkew: 1,被硬约束拒绝。这就是分布约束约束住调度结果的全过程。
5. 完整可运行示例
5.1 基于 Deployment 的分布约束
apiVersion: apps/v1
kind: Deployment
metadata:
  name: my-app
  labels:
    app: my-app            # Deployment 自身标签
spec:
  replicas: 4
  selector:
    matchLabels:
      app: my-app          # 必须与模板标签一致
  template:
    metadata:
      labels:
        app: my-app        # 拓扑分布的 labelSelector 靠它匹配
    spec:
      topologySpreadConstraints:
        - maxSkew: 1                       # 各可用区 Pod 数最多差 1
          topologyKey: topology.kubernetes.io/zone   # 按可用区分域
          whenUnsatisfiable: DoNotSchedule # 硬约束:不满足就不调度
          labelSelector:
            matchLabels:
              app: my-app                 # 统计所有 app=my-app 的 Pod
      containers:
        - name: web
          image: nginx:1.27
          resources:
            requests:
              cpu: 100m
              memory: 128Mi
            limits:
              memory: 256Mi
拓扑分布约束写在 Pod spec(template.spec) 里,Deployment/StatefulSet 等工作负载通过 template 间接设置。
5.2 多重约束:区域 + 节点两级打散
一个 Pod 可以同时设置多个约束( AND 关系,全部满足才可调度):
topologySpreadConstraints:
  - maxSkew: 1
    topologyKey: topology.kubernetes.io/zone      # 第一级:跨可用区打散
    whenUnsatisfiable: DoNotSchedule
    labelSelector:
      matchLabels:
        app: my-app
  - maxSkew: 1
    topologyKey: kubernetes.io/hostname           # 第二级:跨节点打散
    whenUnsatisfiable: ScheduleAnyway             # 节点级用软约束,避免过度限制
    labelSelector:
      matchLabels:
        app: my-app
可用区级用 DoNotSchedule 保住容灾底线,节点级用 ScheduleAnyway 保持调度弹性——这是官方文档示例中的推荐组合。
6. 进阶字段:matchLabelKeys 与策略开关
6.1 matchLabelKeys:滚动更新不互相"拖累"的关键
设想滚动更新场景:新版本 ReplicaSet 创建新 Pod 时,旧版本 Pod 仍在运行。如果约束只按 app: my-app 统计,新旧版本的 Pod 会被一起算进各域的数量里,新 Pod 的分布决策被旧 Pod "污染",导致滚动更新期间分布失衡。
matchLabelKeys(v1.27 Beta 起)解决这个问题——它是一个 Pod 标签键列表,调度器会取新 Pod 自身这些标签的值,与 labelSelector 合并后再统计。Deployment 控制器会给每个修订版的 Pod 打上 pod-template-hash 标签,配合使用即可实现"只统计同版本 Pod":
topologySpreadConstraints:
  - maxSkew: 1
    topologyKey: topology.kubernetes.io/zone
    whenUnsatisfiable: DoNotSchedule
    labelSelector:
      matchLabels:
        app: my-app
    matchLabelKeys:
      - pod-template-hash   # 只统计与新 Pod 同一模板版本的 Pod
官方规则要点:
- kube-apiserver 在创建 Pod 时用这些键从传入 Pod 的标签中取值,与 labelSelector 合并;
- 相同的键不允许同时出现在 matchLabelKeys 和 labelSelector 中;
- labelSelector 未设置时不能设置 matchLabelKeys;
- 键在 Pod 标签中不存在时会被忽略。
6.2 nodeAffinityPolicy 与 nodeTaintsPolicy:把"不够格"的节点排除出统计
nodeAffinityPolicy: Honor(默认 Ignore):Pod 上声明了 nodeAffinity/nodeSelector 时,只有满足该亲和性的节点才算入"符合条件的域";nodeTaintsPolicy: Honor(默认 Ignore):被 Pod 容忍度容忍之外的污点"挡住"的节点,不计入符合条件的域。
默认 Ignore 意味着统计分布时不看节点是否真的能接收 Pod;设为 Honor 可让 skew 统计更贴近真实可调度范围。
6.3 minDomains:域数量不足时的兜底
minDomains(v1.28 起默认可用)表示符合条件的域的最小数量:当符合条件的域数小于该值时,"全局最小值"按 0 计算,skew 因此被放大,约束会倾向等待新域出现而不是把 Pod 堆进现有域。未指定时行为等同于 minDomains: 1。典型用法:配合 whenUnsatisfiable: DoNotSchedule,防止集群扩容新可用区之前,约束把副本全堆进旧区。
7. 与污点/容忍度、节点亲和性的配合
三者在调度流水线中的关系:
节点亲和性 / nodeSelector  →  先过滤:圈出 Pod 允许去的节点范围
污点与容忍度(taints/tolerations)→  过滤:无容忍的污点直接排除节点
拓扑分布约束               →  后决策:在"能去"的节点里决定"去哪最匀"
实践要点:
- 分布约束只统计能匹配的节点:节点若因亲和性/污点根本不可能接收 Pod,配合 nodeAffinityPolicy/nodeTaintsPolicy: Honor 可将其排除出统计,避免 skew 被虚高;
- 某节点被驱逐腾出空间后,分布约束不会"自动搬家"已有 Pod——它只在调度新 Pod 时起作用,事后修正需要借助 descheduler 类工具;
- 相关基础概念见 将Pod调度到指定节点(亲和性写法)与 污点和容忍度(污点机制)。
8. 验证与排查
# 查看 Pod 上的分布约束配置
kubectl get pod <pod名> -o jsonpath='{.spec.topologySpreadConstraints}' | jq

# 按可用区统计某类 Pod 的分布情况(自行替换标签)
kubectl get pods -l app=my-app -o wide \
  --custom-columns=NAME:.metadata.name,NODE:.spec.nodeName

# 硬约束不满足时的典型事件(kubectl describe pod 可见)
#   Warning  FailedScheduling  0/3 nodes are available:
#   1 node(s) didn't match pod topology spread constraints, ...
- 集群中是否存在带 topologyKey 标签的节点(缺标签的节点不构成域);
- 副本数与域数量、maxSkew 是否自洽(4 副本 2 域 maxSkew: 1 可以,5 副本 2 域 maxSkew: 1 放不下);
- labelSelector 是否漏写或写错——匹配不到 Pod 会导致 skew 全为 0,看似"满足"实则约束失效。
相关笔记
- 将Pod调度到指定节点——nodeSelector 与节点亲和性
- 污点和容忍度——污点驱逐与容忍度配置
- Pod创建流程详解——调度器在 Pod 创建流程中的位置