DaemonSet详解
DaemonSet(DS)确保全部(或某些)节点上各运行一个 Pod 副本:节点加入集群时自动新增 Pod,节点移除时 Pod 被回收,删除 DS 会删除它创建的所有 Pod。它定义的是节点本地设施——这类 Pod 不是为了"跑业务",而是为了让节点本身正常工作。
与 Deployment 管副本数不同,DaemonSet 管的是"每节点一个":它关心的不是"总共有几个 Pod",而是"每个节点有没有恰好一个"。无状态业务用 Deployment,节点级组件(网络、日志、监控)用 DaemonSet。
工作原理:每节点恰好一个副本
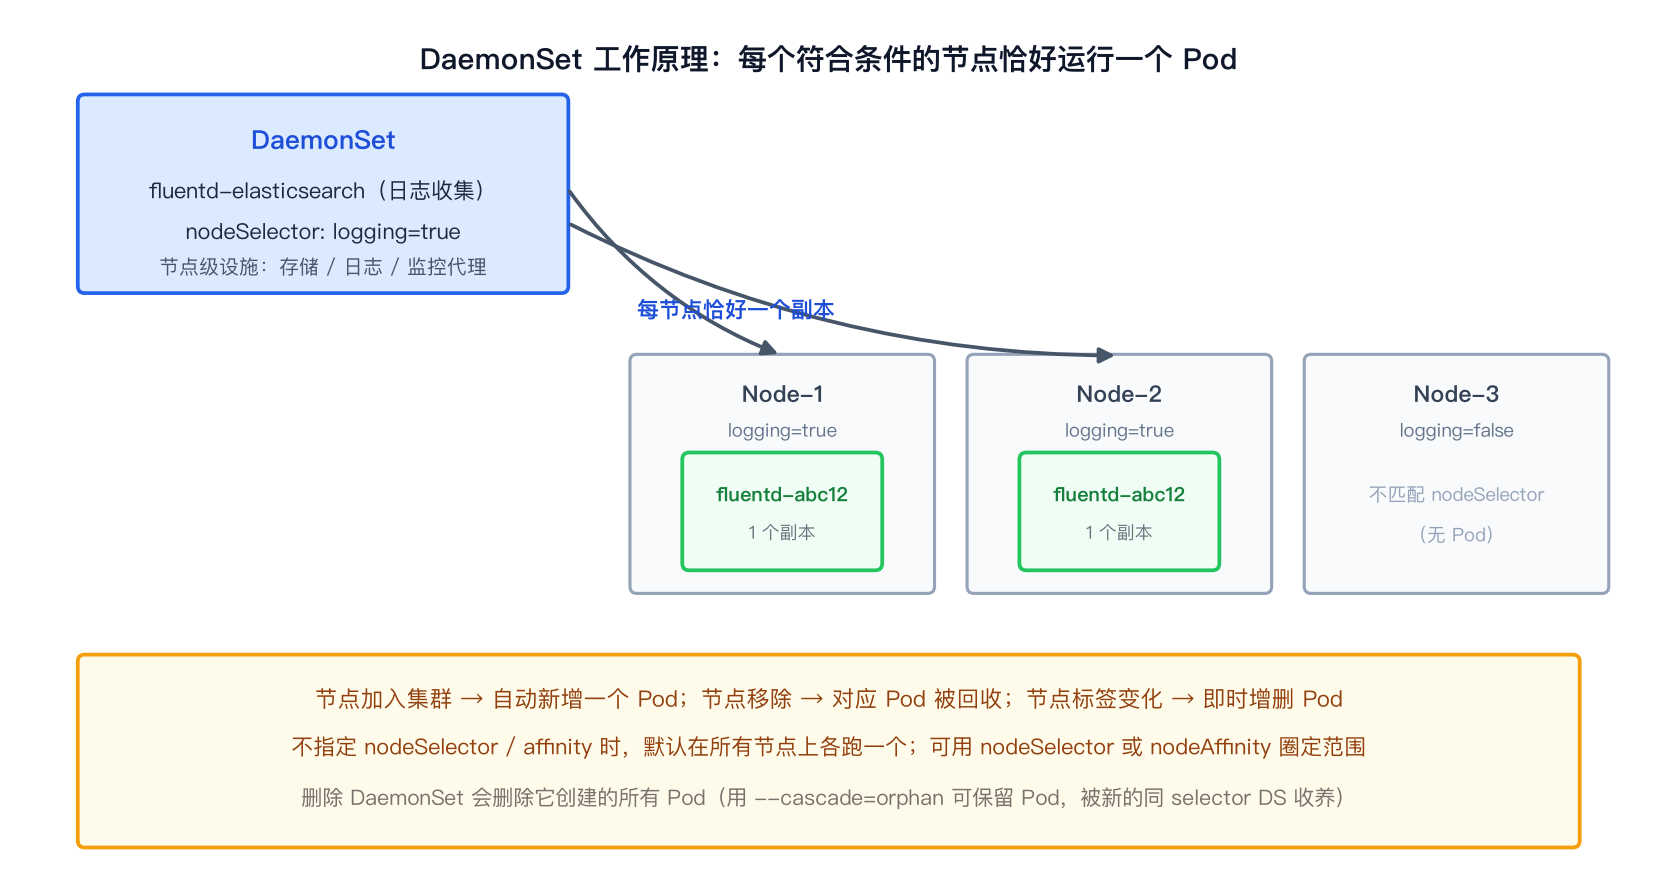
核心行为规则:
- 默认全节点部署:不指定任何筛选条件时,每个节点上一个 Pod;
- nodeSelector / nodeAffinity 圈定范围:指定后只在匹配的节点上创建;
- 动态跟随:节点加入 → 自动新增 Pod;节点移除 → Pod 被回收;节点标签变化 → 即时增删 Pod(改了标签马上就生效);
- 删除即清理:删除 DS 会连带删除所有 Pod;用
kubectl delete --cascade=orphan可保留 Pod,之后创建相同 selector 的新 DS 会收养这些 Pod,需要替换时按 updateStrategy 处理。
典型用法:集群存储守护进程(如 CNI 网络插件、ceph)、每节点日志收集(fluentd)、每节点监控代理(node-exporter)。同一种守护进程也可以部署多个 DS——不同硬件类型配不同的镜像、CPU/内存要求。
创建 DaemonSet
.spec 中唯一必需字段是 .spec.template(Pod 模板,restartPolicy 只能是 Always);.spec.selector 必须与模板标签匹配且创建后不可修改。名称必须是合法 DNS 子域名。
官方 fluentd 日志收集示例(简化自原文):
cat > daemonset.yaml << 'EOF'
apiVersion: apps/v1
kind: DaemonSet
metadata:
  name: fluentd-elasticsearch
  namespace: kube-system         # 节点级组件一般放 kube-system
  labels:
    k8s-app: fluentd-logging
spec:
  selector:
    matchLabels:
      name: fluentd-elasticsearch  # 必须匹配模板标签;创建后不可修改
  updateStrategy:
    type: RollingUpdate           # 默认策略:先终止旧 Pod、再创建新 Pod(与 Deployment 相反)
    rollingUpdate:
      maxUnavailable: 1           # 默认 1 且不能为 0;允许更新期间几个节点上没有可用 Pod
      # maxSurge: 0               # 默认 0(不超额)→ 先删后建;调大可先建后删、节点上短暂两个 Pod
  minReadySeconds: 10             # 新 Pod 稳定就绪多久才算可用;滚动更新的进度检测也用它
  # revisionHistoryLimit: 10      # 保留的旧 RS 数(默认 10),供回滚
  template:
    metadata:
      labels:
        name: fluentd-elasticsearch
    spec:
      tolerations:                # 控制器会自动加 not-ready/unschedulable 等容忍,这里补的
      - key: node-role.kubernetes.io/control-plane   # 是控制平面节点的:不加则 master 上没有副本
        operator: Exists
        effect: NoSchedule
      - key: node-role.kubernetes.io/master
        operator: Exists
        effect: NoSchedule
      # nodeSelector:             # 不写则全节点各跑一个;指定后只在匹配的节点创建
      #   logging: "true"
      # priorityClassName: system-node-critical  # 节点级关键组件建议配高优先级:
      #                                          # 节点资源不足时可抢占普通 Pod 完成部署
      containers:
      - name: fluentd-elasticsearch
        image: quay.io/fluentd_elasticsearch/fluentd:v5.0.1
        resources:
          limits:
            memory: 200Mi
          requests:
            cpu: 100m
            memory: 200Mi
        volumeMounts:
        - name: varlog
          mountPath: /var/log     # 用 hostPath 直接读宿主机目录——"节点本地设施"的典型形态
      terminationGracePeriodSeconds: 30    # 别设 0(官方强烈阻止,守护进程需要体面退出)
      volumes:
      - name: varlog
        hostPath:
          path: /var/log
EOF

kubectl apply -f daemonset.yaml
kubectl get ds -n kube-system
两个值得注意的细节:日志收集用 hostPath 直接读宿主机 /var/log(这正是"节点本地"的典型形态);模板里显式加了控制平面节点的容忍度,否则 master 上不会有副本。
Daemon Pod 是如何被调度的
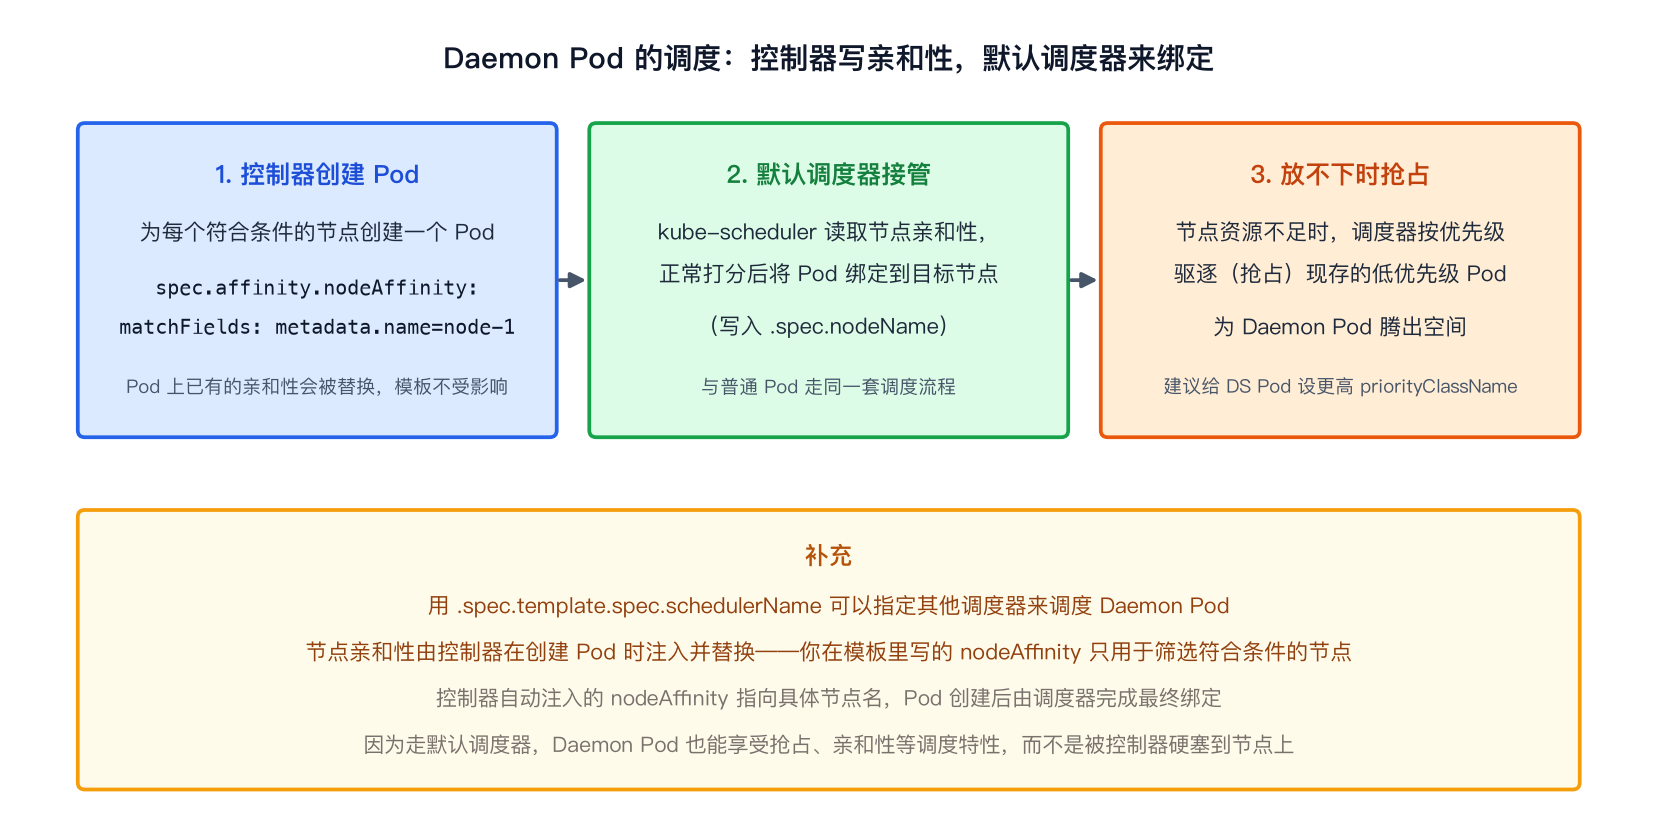
DS Pod 不是被控制器硬塞到节点上的,而是走默认调度器的正规流程:
- 控制器创建 Pod:为每个符合条件的节点创建一个 Pod,并把
spec.affinity.nodeAffinity写成指向具体节点(matchFields: metadata.name=<节点名>)——如果模板里已有节点亲和性,会被替换(模板本身的 nodeAffinity 只用于"筛选符合条件的节点"); - 默认调度器接管:正常打分后把 Pod 绑定到目标节点(写入
.spec.nodeName); - 放不下时抢占:节点资源不足时,调度器按优先级驱逐低优先级 Pod 为它腾空间——所以给节点级关键组件(如网络插件)配一个更高的
priorityClassName是官方推荐做法。
用 .spec.template.spec.schedulerName 可以换用其他调度器。这个设计的好处:抢占、亲和性等调度特性对 Daemon Pod 全部生效。
自动添加的污点容忍
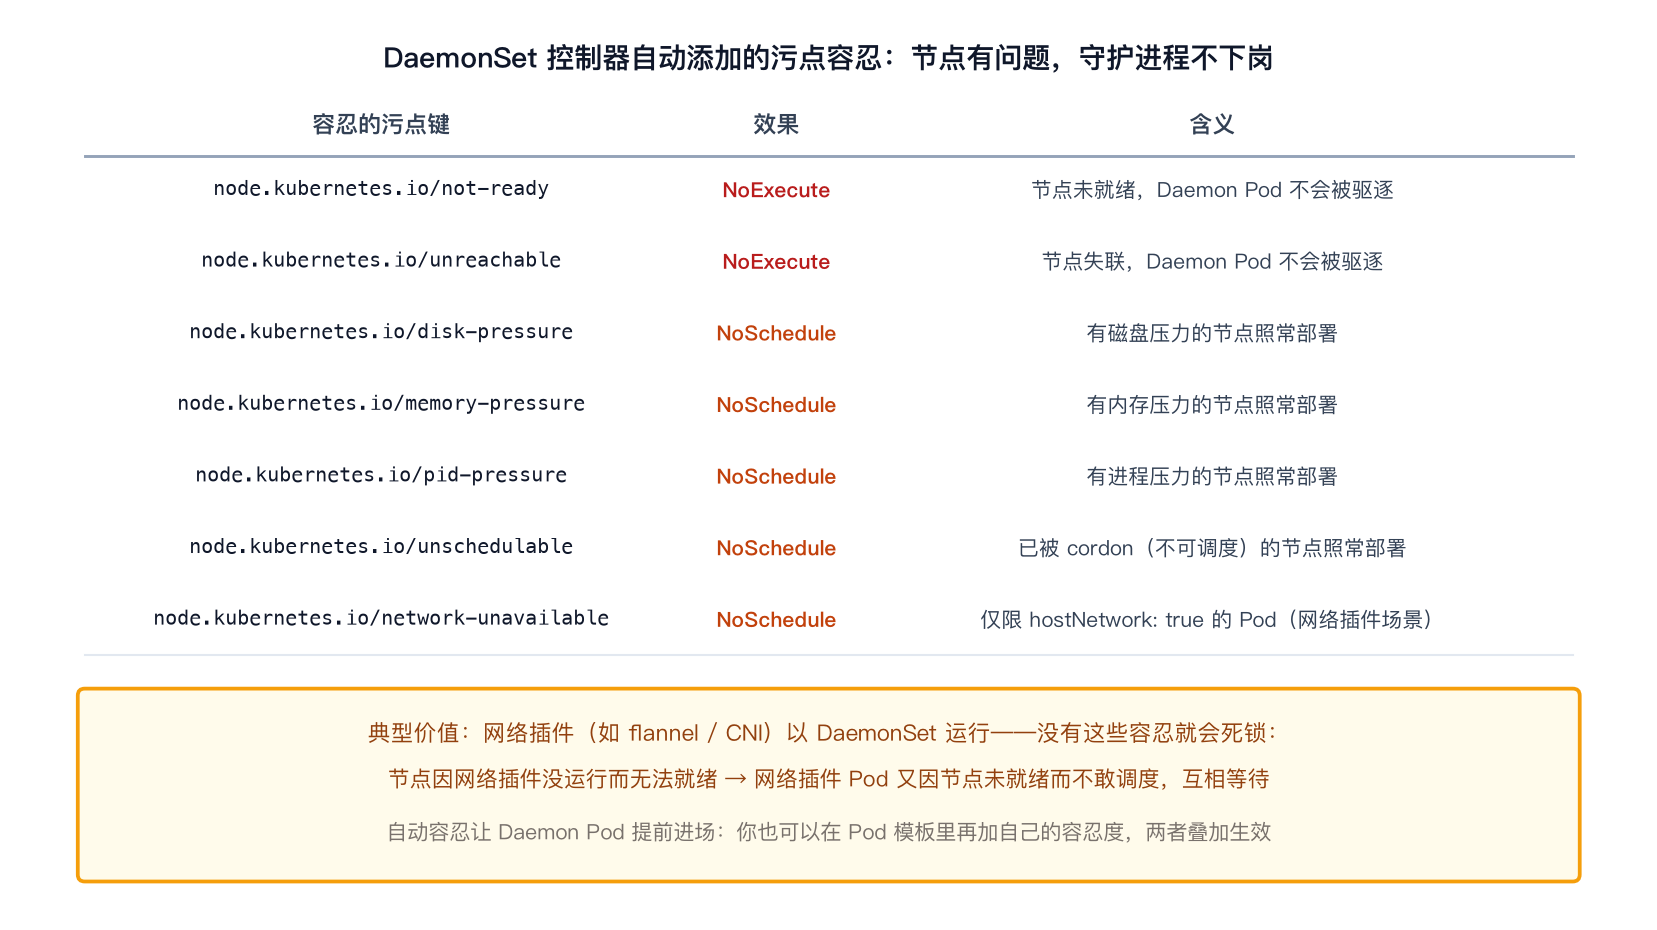
DS 控制器会自动给 Pod 加一组容忍度,效果是节点出问题也不影响守护进程:
| 污点键 | 效果 | 含义 |
|---|---|---|
node.kubernetes.io/not-ready | NoExecute | 节点未就绪,Pod 不被驱逐 |
node.kubernetes.io/unreachable | NoExecute | 节点失联,Pod 不被驱逐 |
node.kubernetes.io/disk-pressure | NoSchedule | 磁盘压力节点照常部署 |
node.kubernetes.io/memory-pressure | NoSchedule | 内存压力节点照常部署 |
node.kubernetes.io/pid-pressure | NoSchedule | 进程压力节点照常部署 |
node.kubernetes.io/unschedulable | NoSchedule | 已 cordon 的节点照常部署 |
node.kubernetes.io/network-unavailable | NoSchedule | 仅限 hostNetwork: true 的 Pod |
以网络插件为例:没有这些容忍就会死锁——节点因网络插件没运行而无法就绪,网络插件 Pod 又因节点未就绪而不敢调度,互相等待。自动容忍让 DS Pod 提前进场,把节点"带起来"。在 Pod 模板里加自己的容忍度会与自动的叠加生效。
与 Daemon Pod 通信的四种模式
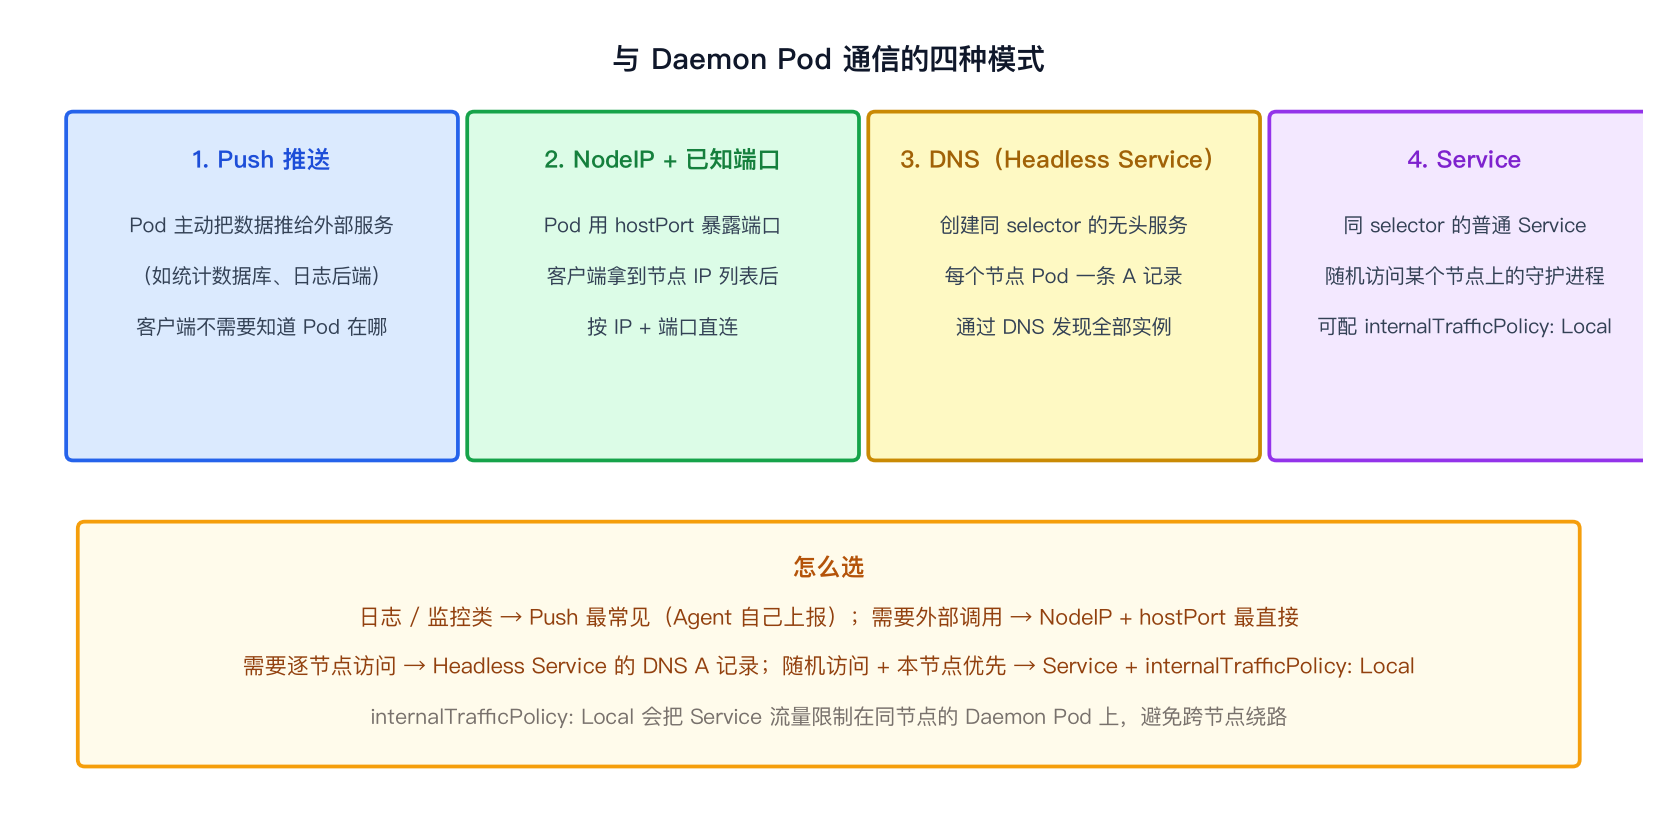
| 模式 | 做法 | 适用 |
|---|---|---|
| Push 推送 | Pod 主动把数据推给外部服务 | 日志 / 监控 Agent(最常见),无客户端 |
| NodeIP + 已知端口 | Pod 用 hostPort,客户端按节点 IP 列表直连 | 需要外部逐节点访问 |
| DNS | 同 selector 的 Headless Service,每个 Pod 一条 A 记录 | 需要发现全部实例 |
| Service | 同 selector 的普通 Service 随机访问 | 配 internalTrafficPolicy: Local 可把流量限制在同节点 |
更新与回滚
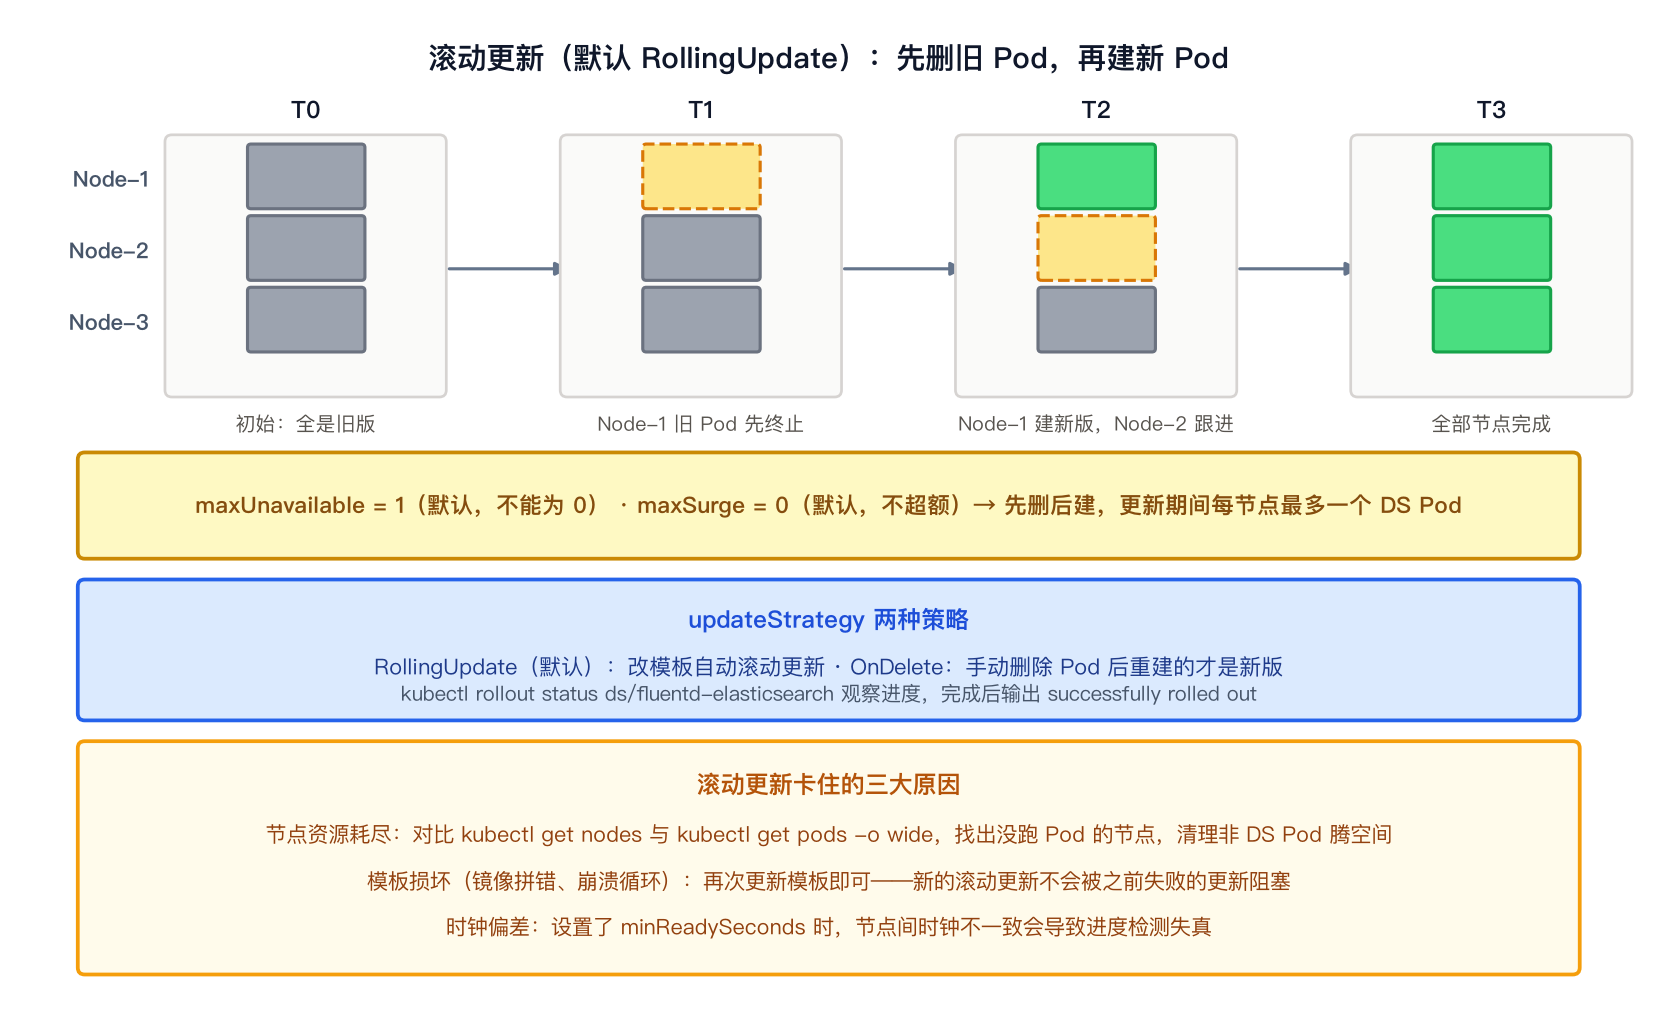
改节点标签立刻生效;改 Pod 模板触发滚动更新(.spec.updateStrategy):
| 策略 | 行为 |
|---|---|
RollingUpdate(默认) | 模板更新后自动滚动;先终止旧 Pod、再创建新 Pod(maxSurge 默认 0),更新期间每个节点上最多只有一个 DS Pod |
OnDelete | 控制器不自动更新,手动删除 Pod 后重建的才是新版 |
RollingUpdate 的旋钮:maxUnavailable(默认 1,不能为 0,绝对数或百分比向下取整)、maxSurge(默认 0)、minReadySeconds(默认 0,新 Pod 稳定就绪多久才算可用)。
kubectl set image ds/fluentd-elasticsearch \
  fluentd-elasticsearch=quay.io/fluentd_elasticsearch/fluentd:v2.6.0 -n kube-system

kubectl rollout status ds/fluentd-elasticsearch -n kube-system
# daemonset "fluentd-elasticsearch" successfully rolled out

kubectl rollout history ds/fluentd-elasticsearch -n kube-system   # 查看修订历史
kubectl rollout undo ds/fluentd-elasticsearch -n kube-system      # 回滚
- 节点资源耗尽:对比
kubectl get nodes和kubectl get pods -o wide找出没跑 Pod 的节点,清理节点上的非 DS Pod 腾空间(注意可能造成服务中断,且不受 PDB 约束); - 模板损坏(镜像拼错、崩溃循环):直接再次更新模板即可——新的滚动更新不会被之前失败的更新阻塞;
- 时钟偏差:设了
minReadySeconds时,主从节点时钟不一致会让进度检测失真。
替代方案对比
| 方案 | 与 DaemonSet 的差异 |
|---|---|
| init 脚本 / systemd | 能跑但缺少统一管理:DS 有 Pod 级监控、日志、与应用一致的配置语言(kubectl / 模板),且容器化带来更好隔离 |
| 裸 Pod(指定 nodeName) | Pod 挂了就没了;DS 会替换因节点故障、维护、内核升级而消失的 Pod |
| 静态 Pod | kubelet 监视目录下的文件创建,不受 kubectl/API 管理,不依赖 API Server——适合集群引导(控制面组件就是这么跑的);官方提示未来可能废弃 |
| Deployment | 类似点:都创建不希望终止的 Pod。无状态、看重扩缩和平滑升级 → Deployment;必须每节点一个、提供节点级功能 → DaemonSet |
避坑清单
.spec.template是.spec唯一必需字段;restartPolicy只能Always;selector 创建后不可变- Headless 类需求别忘了 DS 不创建 Service,通信方式要自己选(Push / hostPort / DNS / Service)
- 想让控制平面节点也跑副本,必须自己加 control-plane 的容忍度(自动容忍不含这个)
- 节点级关键组件建议配更高优先级的
priorityClassName,保证放不下时能抢占 - 滚动更新是先删后建(与 Deployment 相反),
maxSurge默认 0——更新期间节点上没有 Pod 属于正常现象 - 直接指定
.spec.nodeName创建的 Pod 不归 DS 管;--cascade=orphan留下的 Pod 会被新 DS 收养

