VerticalPodAutoscaler详解
VerticalPodAutoscaler(VPA)做垂直扩缩:负载涨了不是多起几个 Pod,而是把现有 Pod 的 CPU / 内存 requests(和 limits)调到与实际用量匹配——也叫 rightsizing。用量降下来时,它会把虚高的资源申请调回去,避免浪费。
HPA 是内置 API(autoscaling/v2),VPA 是 CRD(autoscaling.k8s.io/v1),来自 kubernetes/autoscaler 仓库的 vertical-pod-autoscaler 项目,需要单独安装(会部署 recommender / updater / admission-controller 三个组件和 CRD)。另外它同样依赖 Metrics Server 提供指标。
与 HPA 的本质区别
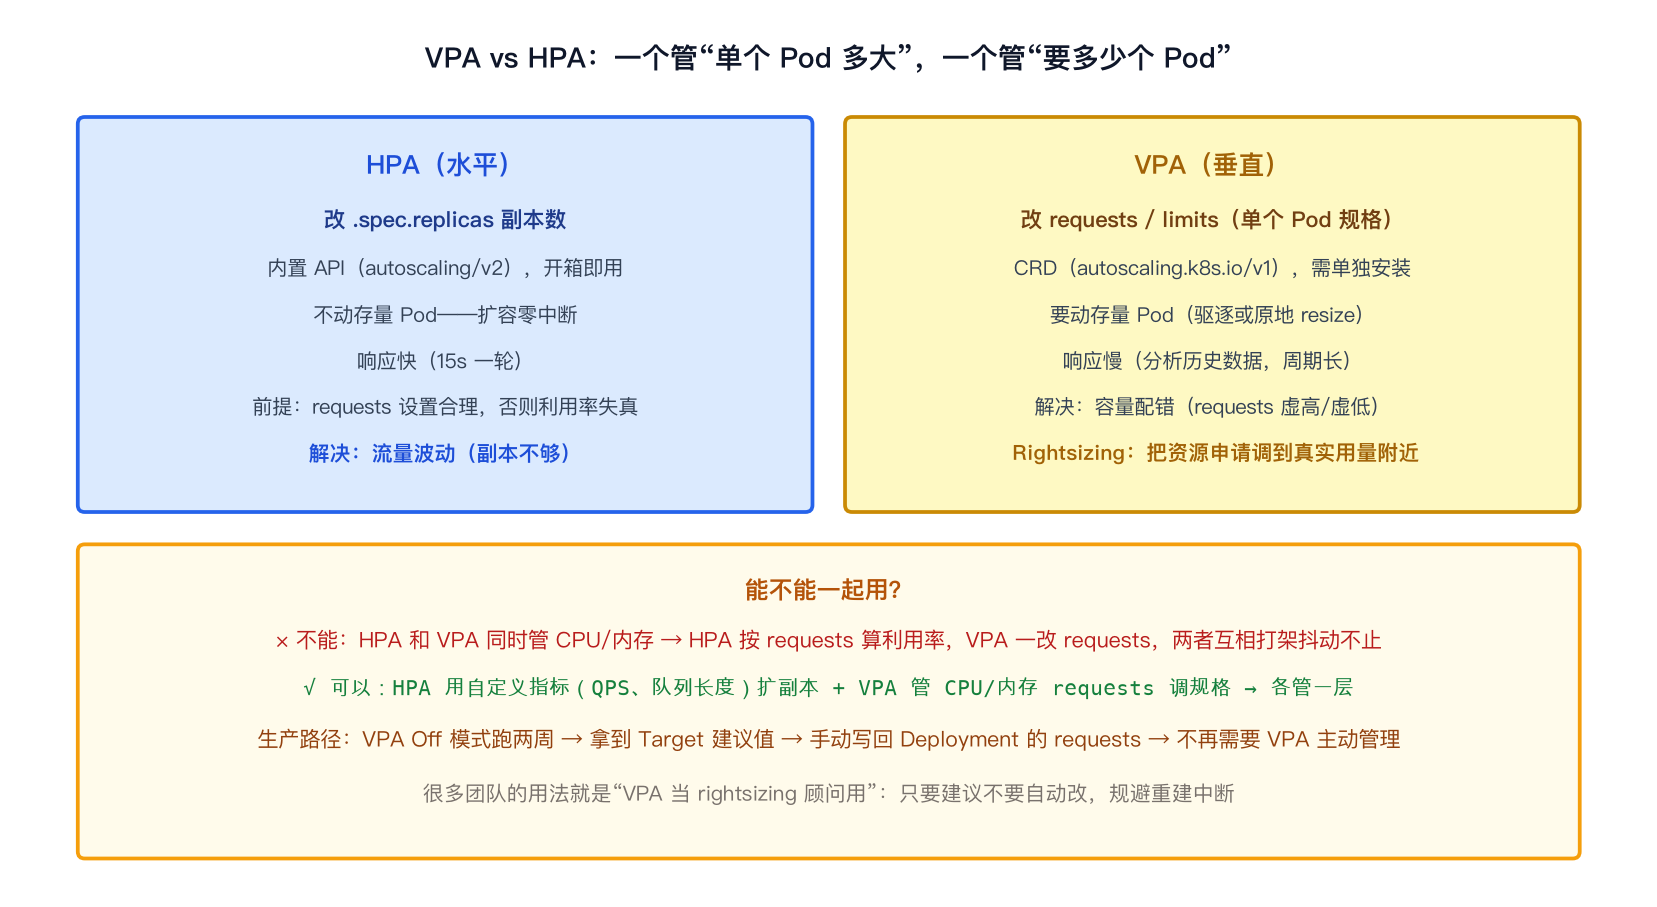
一句话:HPA 管"要多少个 Pod",VPA 管"单个 Pod 多大"。
最关键的行为差异:HPA 扩容只是加副本,存量 Pod 毫发无损;VPA 改 requests 意味着存量 Pod 要重建(驱逐后重建,或原地 resize)——这是它天生比 HPA 激进的地方,也是生产上对它更谨慎的原因。
能不能一起用? 不能同时对 CPU/内存 指标用:HPA 的利用率公式分母是 requests,VPA 一改 requests,HPA 的计算基础就变了,两者互相打架、抖动不止。正确的组合:HPA 用自定义指标(QPS、队列长度)扩副本 + VPA 管 CPU/内存调规格,各管一层。
三个组件如何协作
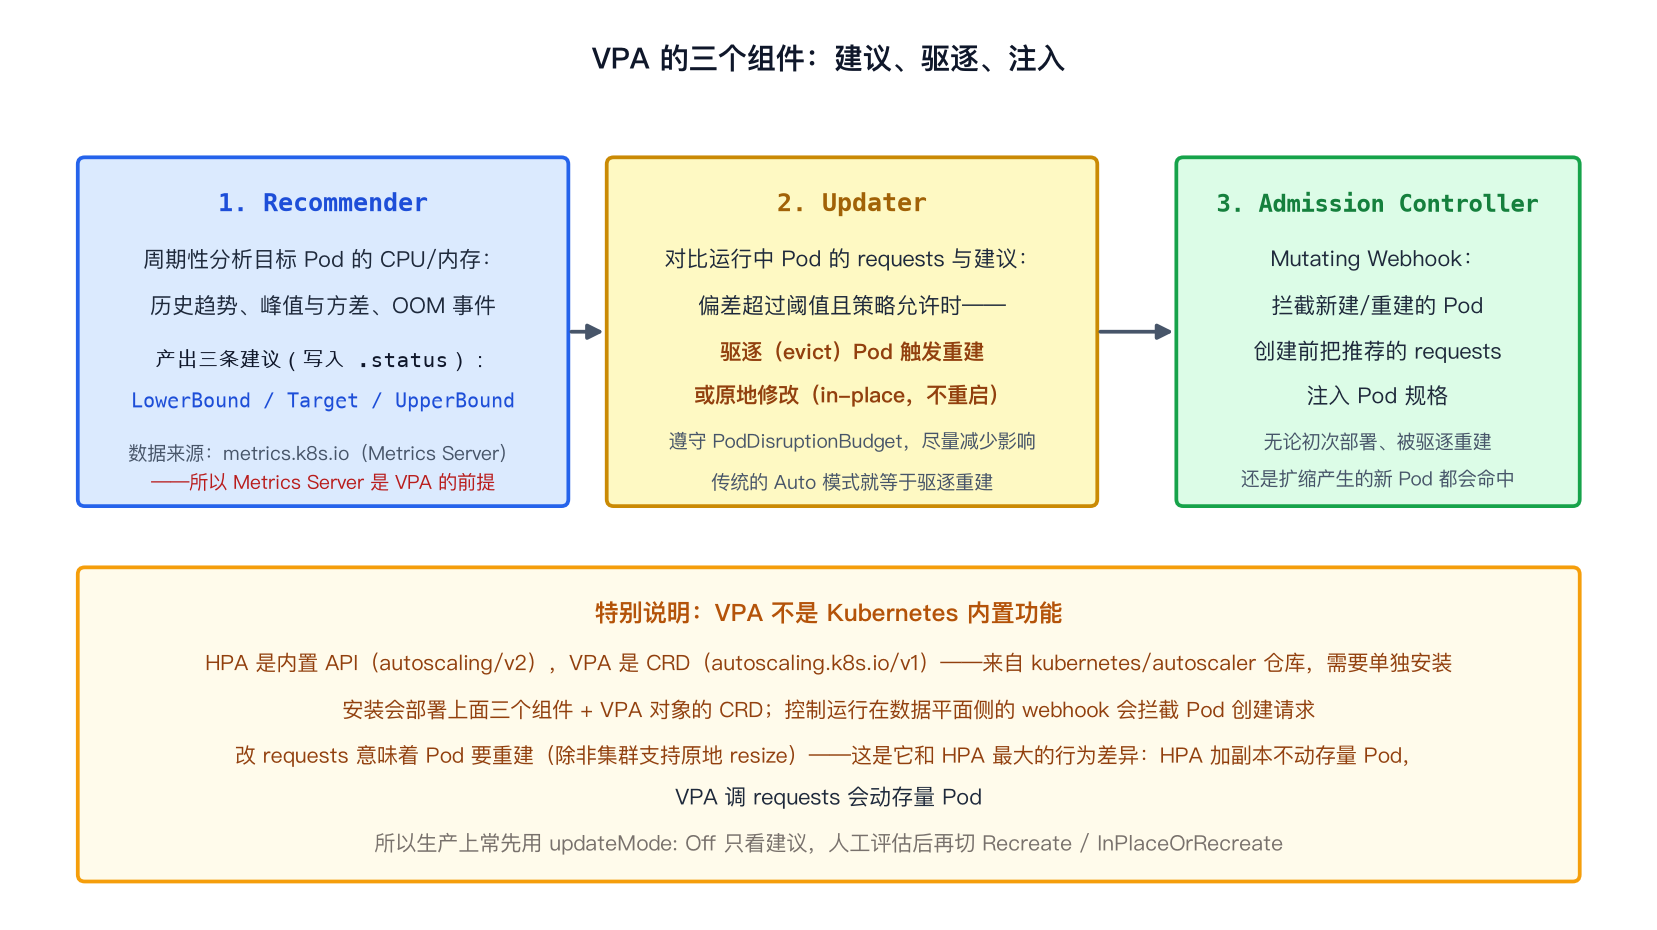
三个组件都是间歇运行的(非连续过程):
- Recommender:按
targetRef找到目标、按 selector 选出 Pod,分析当前 + 历史用量(趋势、峰值与方差、OOM 事件),产出三条建议写入.status.recommendation:LowerBound(最低可行)/ Target(最优)/ UpperBound(上限); - Updater:对比运行中 Pod 的 requests 与建议,偏差超阈值且策略允许时——驱逐 Pod(重建后由工作负载控制器拉起新 Pod)或原地 resize;遵守 PodDisruptionBudget;
- Admission Controller:Mutating Webhook,拦截新建/重建的 Pod,创建前把 Target 建议注入规格——保证每个新 Pod 都按推荐容量启动。
更新模式
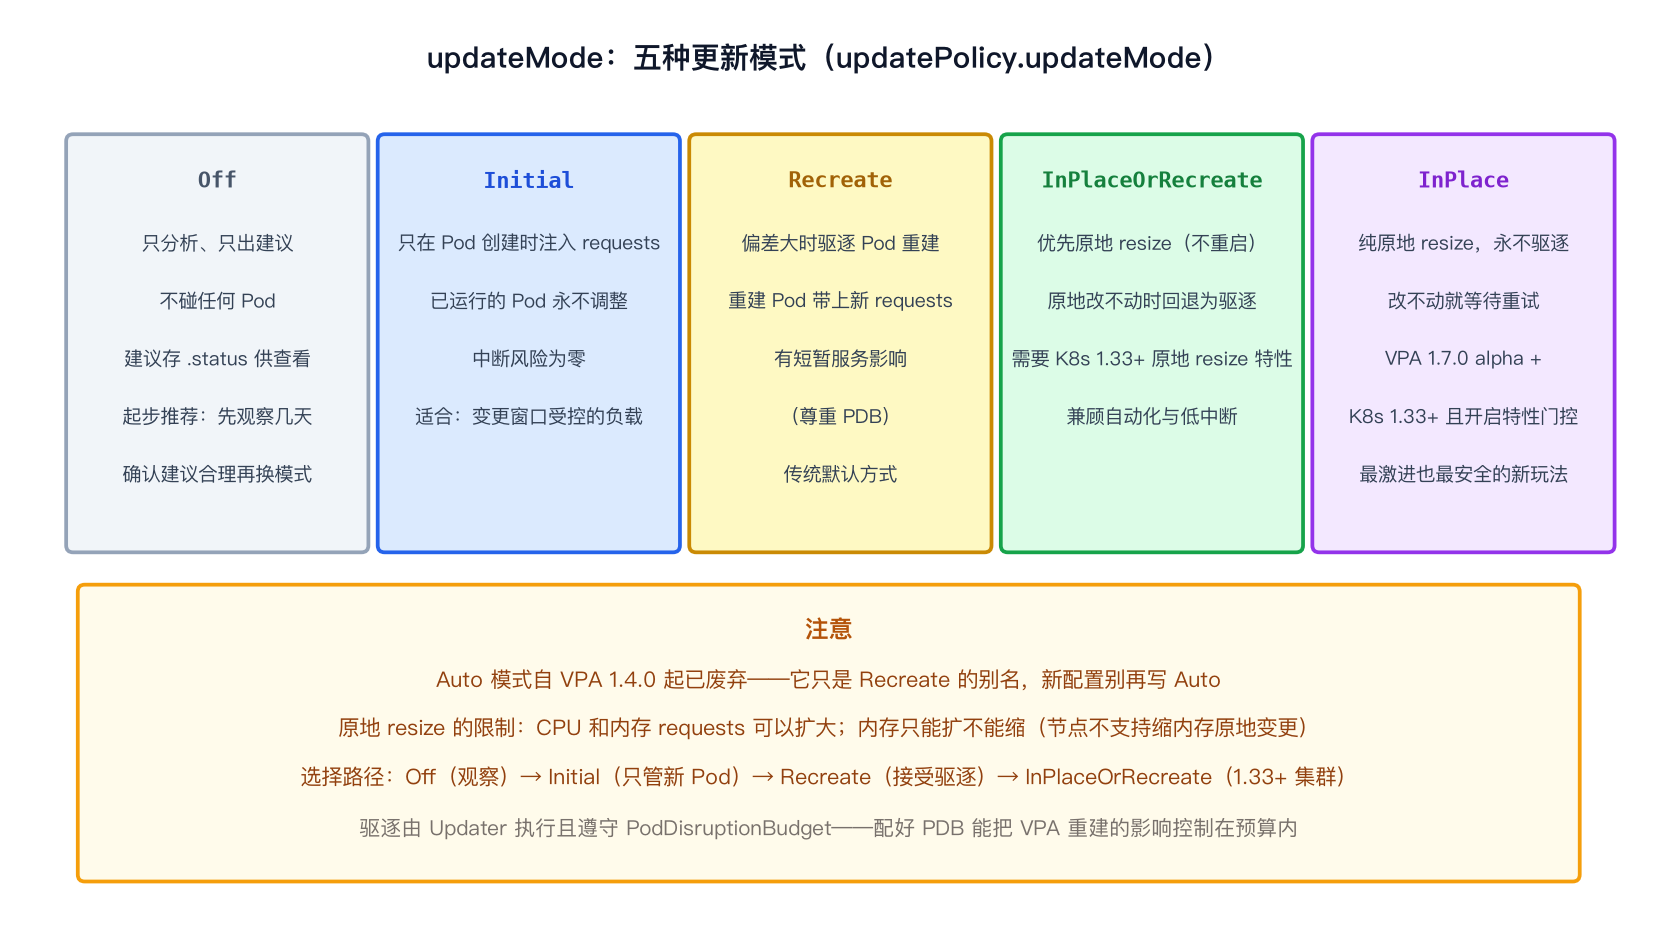
| updateMode | 行为 | 适用 |
|---|---|---|
Off | 只分析出建议,不碰任何 Pod | 起步推荐:先观察建议是否合理 |
Initial | 只在 Pod 创建时注入,已运行的不动 | 变更窗口受控的负载 |
Recreate | 偏差大时驱逐重建 | 接受短暂中断 |
InPlaceOrRecreate | 优先原地 resize,改不动再驱逐 | K8s 1.33+ |
InPlace | 纯原地 resize,永不驱逐,改不动就等 | VPA 1.7.0 alpha + K8s 1.33+ 开特性门控 |
Auto 模式自 VPA 1.4.0 起已废弃——它只是 Recreate 的别名,新配置别再写。原地 resize 的限制:requests 可以扩大,内存不能原地缩小(节点不支持),所以内存缩容始终要走驱逐。
完整示例
cat > vpa.yaml << 'EOF'
apiVersion: autoscaling.k8s.io/v1   # VPA 是 CRD,当前稳定版本
kind: VerticalPodAutoscaler
metadata:
  name: my-app-vpa
spec:
  targetRef:                        # 要给谁出建议/调整:指向工作负载资源
    apiVersion: "apps/v1"
    kind: Deployment
    name: my-app
  updatePolicy:
    updateMode: "Recreate"          # Off / Initial / Recreate / InPlaceOrRecreate / InPlace
                                    # 起步建议先 Off,观察建议后再切换
  resourcePolicy:                  # 可选:约束建议与更新行为
    containerPolicies:
    - containerName: "application" # 针对指定容器;* 表示所有容器
      minAllowed:                  # 建议的下限——即使数据显示更少也不会低于它
        cpu: 100m
        memory: 128Mi
      maxAllowed:                  # 建议的上限——防止一次坏数据把 requests 抬上天
        cpu: 2
        memory: 2Gi
      controlledResources:         # VPA 只管这些资源(默认 cpu + memory 都管)
      - cpu
      - memory
      controlledValues: RequestsAndLimits
      # RequestsAndLimits(默认):requests 和 limits 一起改,limits 按 Pod 清单里的
      #   request:limit 比例等比缩放
      # RequestsOnly:只改 requests,limits 不动——usage 超 limit 仍会被限流/OOM
EOF

kubectl apply -f vpa.yaml
查看建议(Off 模式下这是主要产出):
kubectl describe vpa my-app-vpa
# Status:
#   Recommendation:
#     Container Recommendations:
#       Container Name:  application
#       Lower Bound:     cpu: 250m     memory: 262144k
#       Target:          cpu: 500m     memory: 512Mi      ← 准入控制器注入的就是它
#       Upper Bound:     cpu: 1        memory: 1Gi
与 LimitRange 的关系
Recommender 和 Updater 都会对建议做 LimitRange 后处理:如果建议超出了命名空间 LimitRange 的 max,会被压回 max 值,requests 按比例同步下调以维持清单里的 request:limit 比率。也就是说 LimitRange 是 VPA 建议的硬边界,两者可以配合做命名空间级管控。
我的总结与避坑清单
- 先装 Metrics Server 再装 VPA:recommender 的数据源就是 metrics.k8s.io,没它 VPA 就是瞎子;
- 起步用 Off 模式:跑一两周拿到 Target 建议,先人工评估——很多团队到此为止,把建议值手动写回 Deployment,让 VPA 当"rightsizing 顾问"而非自动驾驶;
- 上 Recreate 前先配好 PDB:驱逐重建会短暂减少副本,PDB 保证影响的可控;
- 别对 CPU/内存同时上 HPA + VPA:requests 是 HPA 公式的分母,VPA 一改就打架;组合方式是 HPA 用自定义指标;
- 内存原地只能扩不能缩:内存缩容永远走驱逐重建,InPlace 模式也不是全能;
- 老配置里的 Auto 换掉:VPA 1.4.0 起废弃,等价于 Recreate;
- minAllowed/maxAllowed 是安全网:坏数据(比如 Pod 被打到 10 倍流量)不会让建议失控,务必设置;
- VPA 与 Cluster Autoscaler 天然互补:VPA 把单个 Pod 变大后可能调度不出去,CA 负责加节点;
- StatefulSet 也能用 VPA(targetRef 指过去即可),但注意有状态应用驱逐重建的成本更高,优先 Off/Initial。

