ReplicationController详解
ReplicationController(缩写 rc,也是 kubectl 的快捷资源名)确保任意时刻都有指定数量的 Pod 副本在运行:多了就终止、少了就补建。它是 ReplicaSet 的前身——旧版 API,已被 Deployment + ReplicaSet 取代,官方明确建议不要在新环境中使用。这里写它,一是存量集群和老清单还会遇到,二是理解了它,RS 和 Deployment 的底层行为就通了。
RC 与 RS 的副本对账逻辑完全一致,差别只在 selector 表达能力和 API 版本;真正的"更新编排"能力是 Deployment 才有的。存量清单迁移方向一律是 Deployment。
工作原理
和 RS 一样,RC 是一个跨多节点的进程监视器:
- Pod 数量超出
replicas→ 终止多余的;不足 → 按模板启动新的; - 由 RC 创建的 Pod 在失败、被删除、节点维护(如内核升级重启)后都会被自动替换——即使只需要一个 Pod,也应该用控制器而不是裸 Pod;
- 它只认标签:selector 匹配的所有 Pod 都归它管,不区分是自己创建的还是别人创建的——这意味着可以随时删掉 RC 再建一个新的接管现有 Pod(selector 相同即可);
- 职责被刻意收窄(官方设计哲学):不做就绪/存活探测、不做自动扩缩、不做调度策略、不校验 Pod 是否与模板一致——它只是个可组合的构建基元,探活归 kubelet、扩缩归 HPA、更新编排归上层。
示例
cat > replication.yaml << 'EOF'
apiVersion: v1                  # 【RC 特征】旧 API 在核心组 v1 下,不像 RS/Deploy 在 apps/v1
kind: ReplicationController
metadata:
  name: nginx
spec:
  replicas: 3                   # 期望副本数,默认 1
  selector:                     # 只支持等值匹配(key=value),这是它和 RS 的核心差距
    app: nginx                  # 指定了模板标签时必须与之相同,否则 API 拒绝;
  template:                     # 不写 selector 则默认取模板标签
    metadata:
      labels:
        app: nginx              # 必须与 selector 匹配
    spec:
      restartPolicy: Always     # 只允许 Always(与 RS 相同的约束)
      containers:
      - name: nginx
        image: nginx
        ports:
        - containerPort: 80
EOF

kubectl apply -f replication.yaml
kubectl describe replicationcontrollers/nginx
describe 输出的关键信息(注意 RC 没有 UP-TO-DATE 列——它根本没有"版本更新"概念):
Selector:    app=nginx
Replicas:    3 current / 3 desired
Pods Status: 3 Running / 0 Waiting / 0 Succeeded / 0 Failed
Events:
  Normal  SuccessfulCreate  ... Created pod: nginx-qrm3m
用 selector 列出它管的 Pod:
pods=$(kubectl get pods --selector=app=nginx \
  --output=jsonpath={.items..metadata.name})
echo $pods
# nginx-3ntk0 nginx-4ok8v nginx-qrm3m
与 RS / Deployment 的核心区别
先说结论:RC 和 RS 的区别只有两条,其余完全一样。
区别 1:selector 表达能力(核心区别)
RC 只支持等值匹配,RS 支持基于集合的匹配:
# RC:只能 key=value
selector:
  app: nginx

# RS:还能用 matchExpressions 写集合条件
selector:
  matchExpressions:
  - key: tier
    operator: In          # 还有 NotIn / Exists / DoesNotExist
    values: [frontend, backend]
这意味着 RS 可以表达"有 tier 标签但值不是 cache 的所有 Pod"这类条件,RC 做不到。这个升级正是 RS 诞生的动机:Deployment 做滚动更新要靠新旧版本 Pod 的标签集合区分流量,等值匹配表达不了。
区别 2:API 版本
RC 在核心组 apiVersion: v1;RS 在 apps/v1。
完全相同的部分(所以说 RS 只是"换了个引擎盖"):
- 副本对账逻辑一模一样:selector 找 Pod、少了按模板建、多了删;
- 都没有更新编排——改了 Pod 模板,已运行的 Pod 原样不动,只影响之后新建的;
restartPolicy都只能Always;- 都会认领标签匹配的"无主 Pod"。
演进关系与 Deployment 的位置:
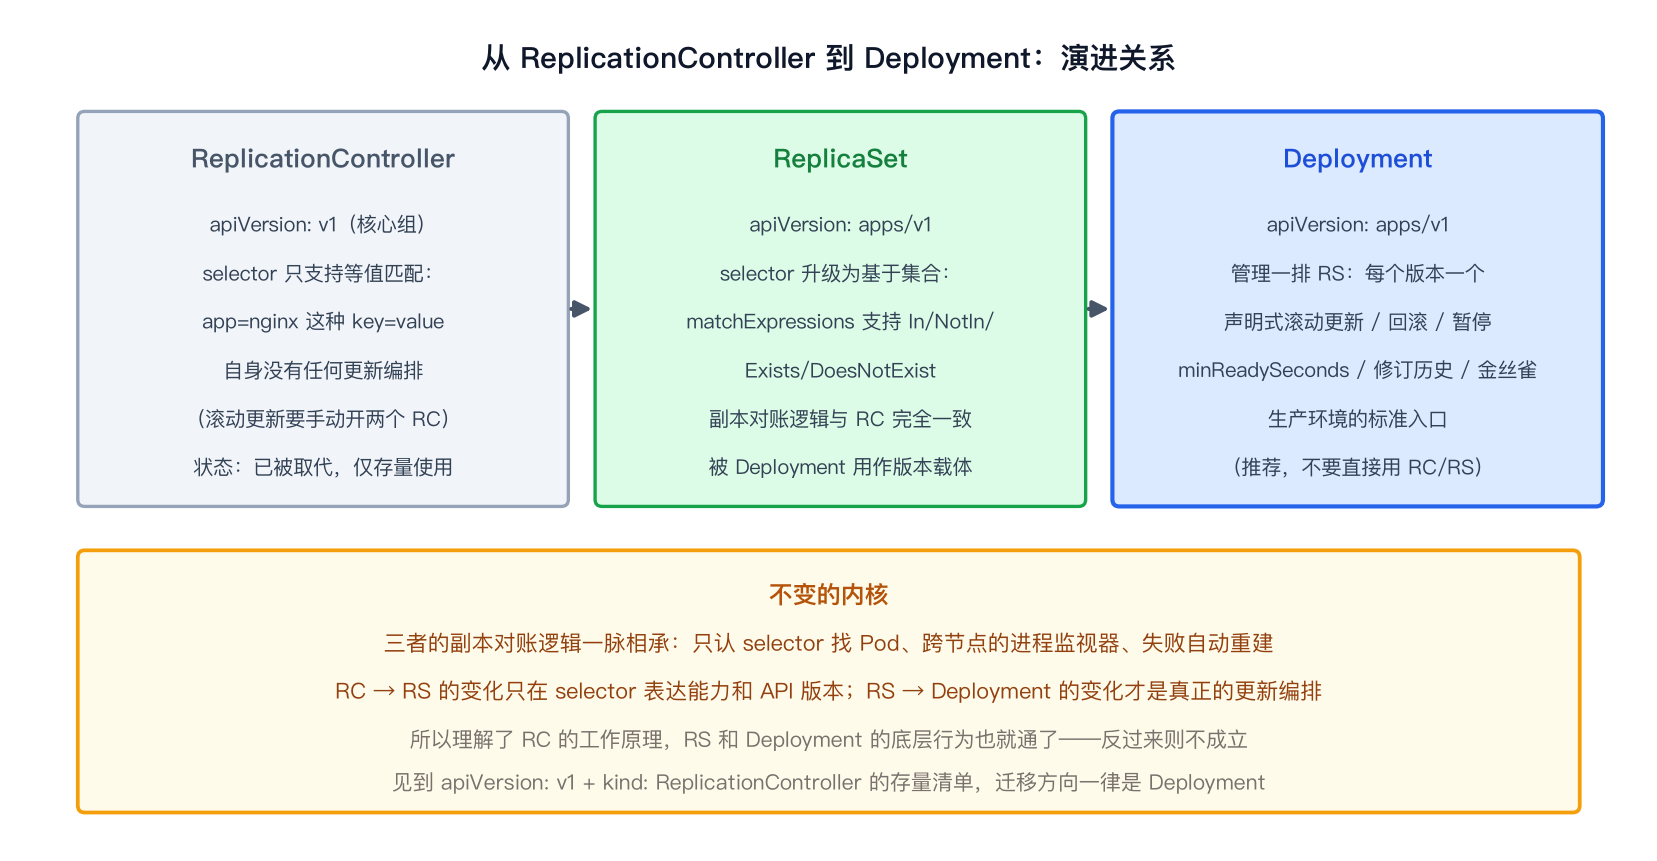
| ReplicationController | ReplicaSet | Deployment | |
|---|---|---|---|
| API 版本 | v1(核心组) | apps/v1 | apps/v1 |
| selector | 只支持等值(app=nginx) | 支持基于集合(In/NotIn/Exists/DoesNotExist) | 同 RS |
| 更新编排 | 没有,要手动开两个 RC 交替扩缩 | 同样没有 | 声明式滚动更新、回滚、暂停 |
| 现状 | 已被取代 | 被 Deployment 用作版本载体 | 推荐 |
一句话总结:RS = RC + 更强的 selector 表达能力,其他没变;两者都不会滚动更新,会更新的是它们头上的 Deployment。 日常直接用 Deployment,RC 和 RS 都不单独碰。
RC 时代的滚动更新(理解 Deployment 价值的最好教材)
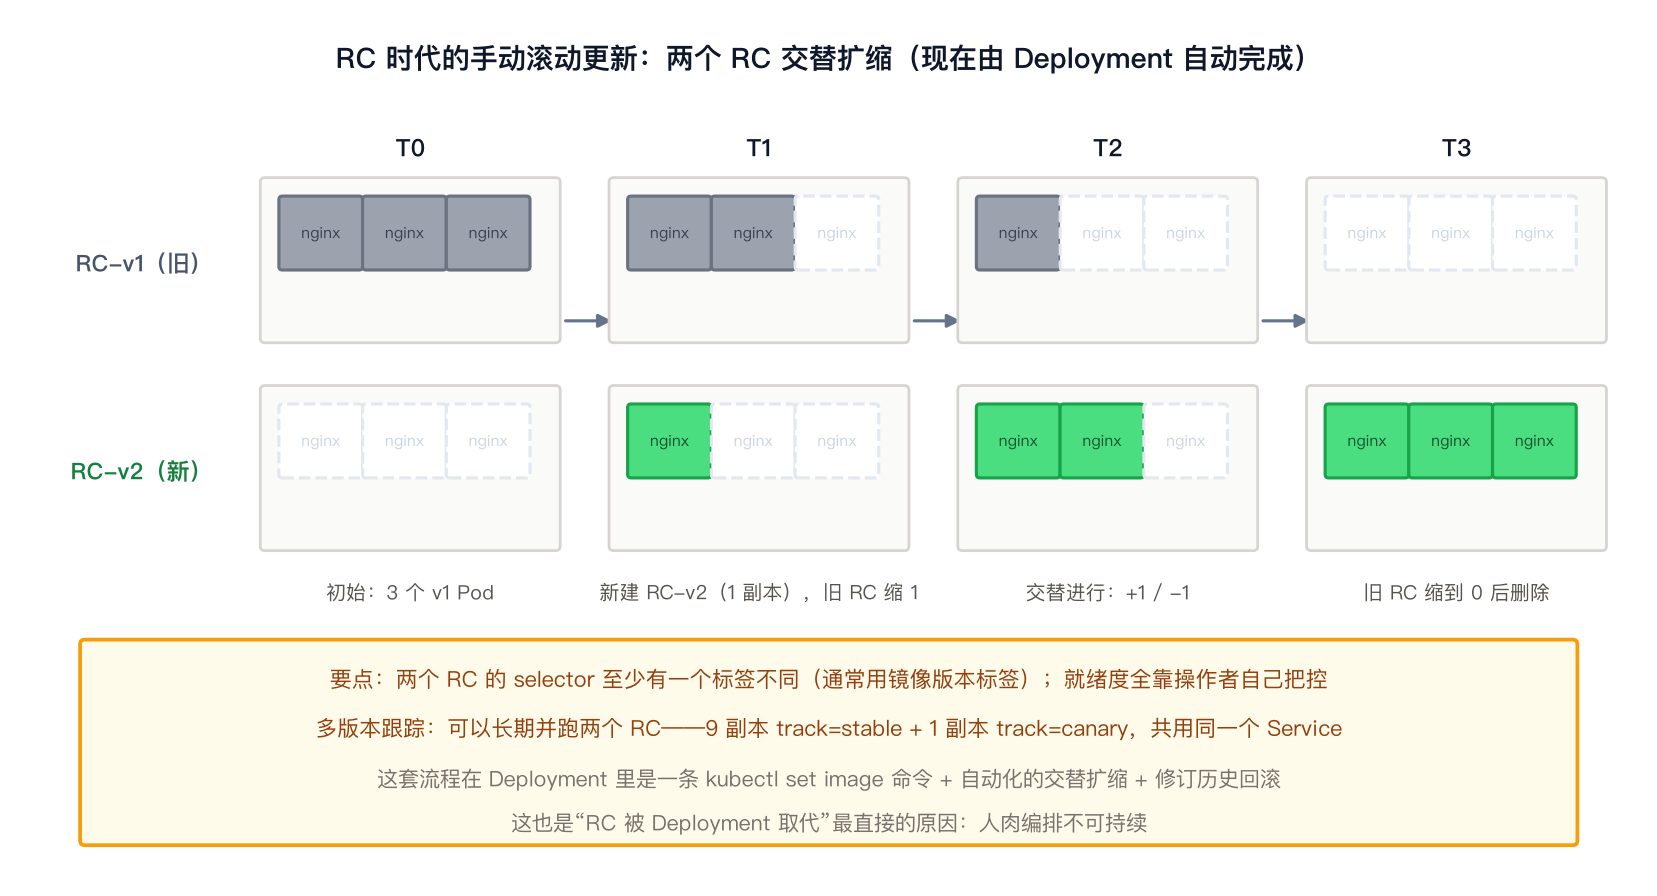
RC 自己不会更新 Pod。官方建议的手动流程:
- 用新模板建一个新的 RC,
replicas: 1(新 RC 的 selector 至少有一个标签不同,通常是镜像版本标签); - 旧 RC 缩 1、新 RC 扩 1,交替进行直到旧 RC 为 0;
- 删除旧 RC。
就绪度把控、失败回退全靠操作者手工完成。这套流程正是 Deployment 自动化的原型——kubectl set image 一条命令背后做的是同样的事(扩新 RS、缩旧 RS),外加修订历史和自动回退。
其他使用模式:
- 多版本跟踪(金丝雀雏形):长期并跑两个 RC——9 副本
track=stable+ 1 副本track=canary,selector 上层公共部分一致(tier=frontend, environment=prod),同一个 Service 同时覆盖两批 Pod,按比例分流; - 重新调度:节点故障后 Pod 在其他节点重建(进程监视器的本职);
- 扩缩容:改
replicas即可,可交给自动扩缩器(后来演化成 HPA)。
删除与 Pod 隔离
kubectl delete rc/nginx                        # 级联:先缩到 0 等 Pod 删完,再删 RC
kubectl delete rc/nginx --cascade=orphan       # 只删 RC,Pod 保留;
                                               # 之后建一个 selector 相同的新 RC 即可收养
把某个 Pod 的标签改掉即可将其隔离出 RC 的管辖(调试、数据恢复场景)——RC 会立刻补一个新 Pod 顶上。
避坑清单
- 新环境一律用 Deployment:RC 只存在于存量清单和老教程里,不要再新建;
- 迁移就是改 kind:
apiVersion: v1 + kind: ReplicationController改为apps/v1 + kind: Deployment,selector 用matchLabels表达同样的等值条件,语义完全兼容; - RC 的 selector 是等值匹配,删不掉、改不动复杂条件——迁移时顺带检查是否有依赖等值限制的场景;
- 两个控制器的 selector 重叠会互相抢 Pod(RC 会认为别人创建的 Pod 是自己的)——这在 RC 时代就存在,至今仍是所有控制器的共同约束;
- 别用 RC 跑批任务(会无限重启正常退出的 Pod)——那是 Job 的事;节点级守护是 DaemonSet 的事。

