HorizontalPodAutoscaler详解
官方文档:Horizontal Pod Autoscaler
HorizontalPodAutoscaler(HPA)根据观测到的指标(CPU、内存、自定义指标)自动增减 Pod 数量。名字里的 Horizontal(水平)是关键词:负载涨了就多起几个 Pod——与之相对的垂直扩缩(VPA)是给现有 Pod 加内存加 CPU,两者不要对同一个指标同时用。
工作原理
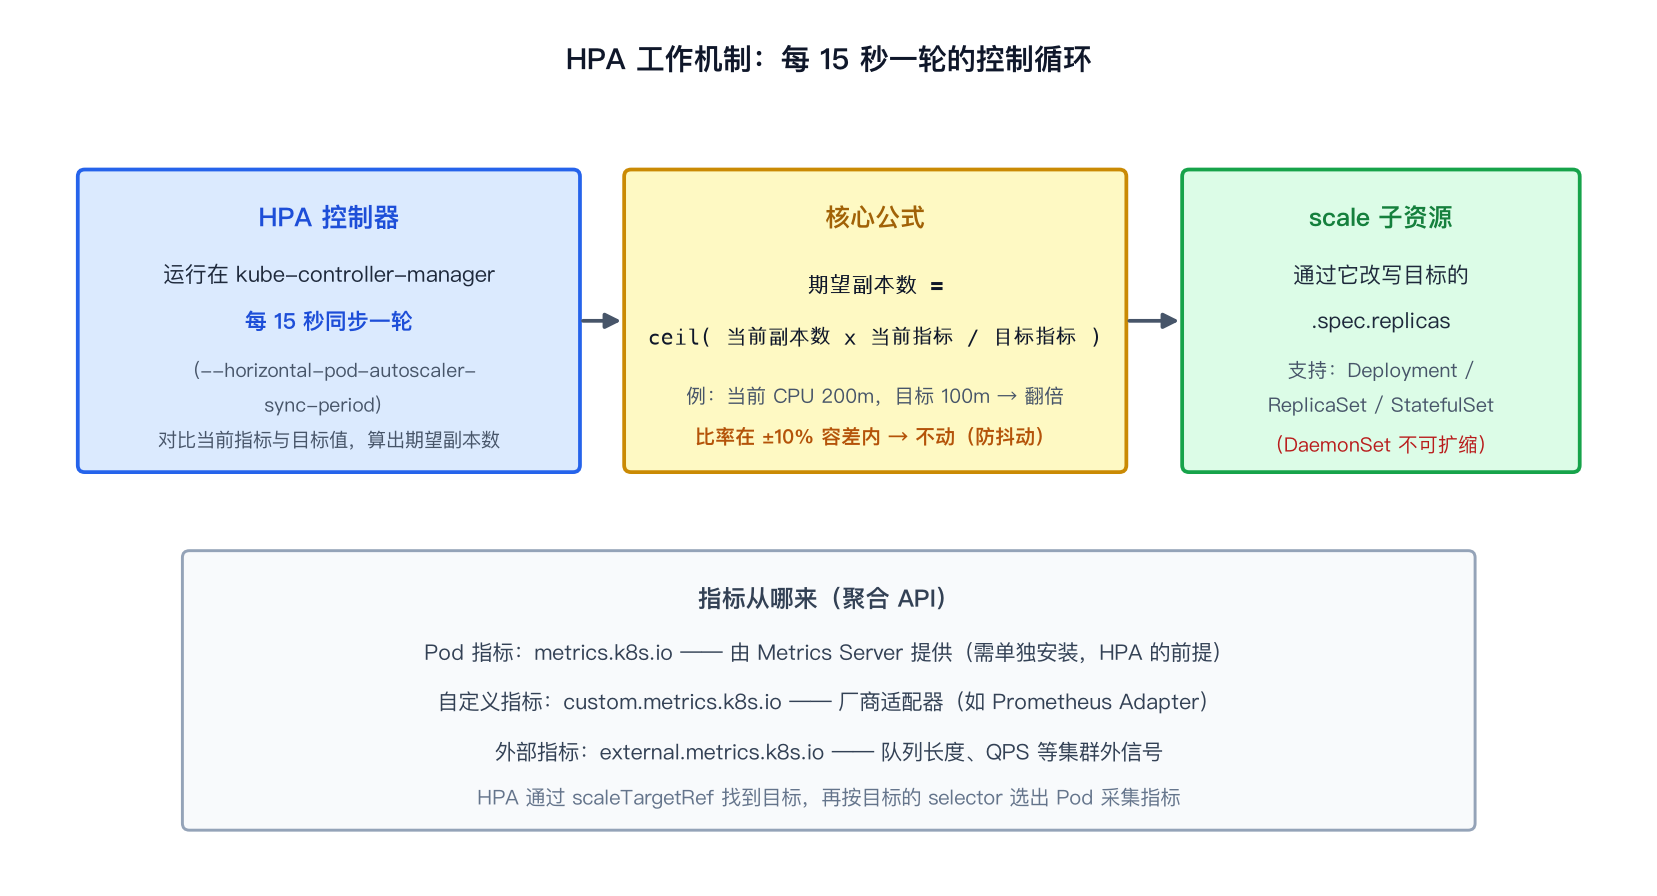
HPA = 一个 API 资源 + 一个跑在 kube-controller-manager 里的控制器。它是间歇运行的控制回路,不是实时响应:默认每 15 秒同步一轮(--horizontal-pod-autoscaler-sync-period),每个周期内:
- 按
scaleTargetRef找到目标(Deployment / ReplicaSet / StatefulSet),再按目标的 selector 选出 Pod; - 从指标 API(Metrics Server 或自定义指标适配器)拉取当前指标;
- 套公式算出期望副本数,通过目标资源的 scale 子资源改写
.spec.replicas。
期望副本数 = ceil( 当前副本数 × 当前指标 / 目标指标 )
例:当前 CPU 200m、目标 100m → 200/100 = 2.0 → 副本翻倍;当前 50m → 0.5 → 减半。比率落在 ±10% 容差内就不动(默认 tolerance 0.1,防抖动;GA v1.37 起可按方向单独设置)。
15 秒一轮 + 指标采集延迟 + Pod 启动时间,意味着从"流量突增"到"新 Pod 就绪"通常要 30 秒以上。扛瞬时尖峰不能只靠 HPA,要靠队列削峰或多副本冗余。
五种指标类型
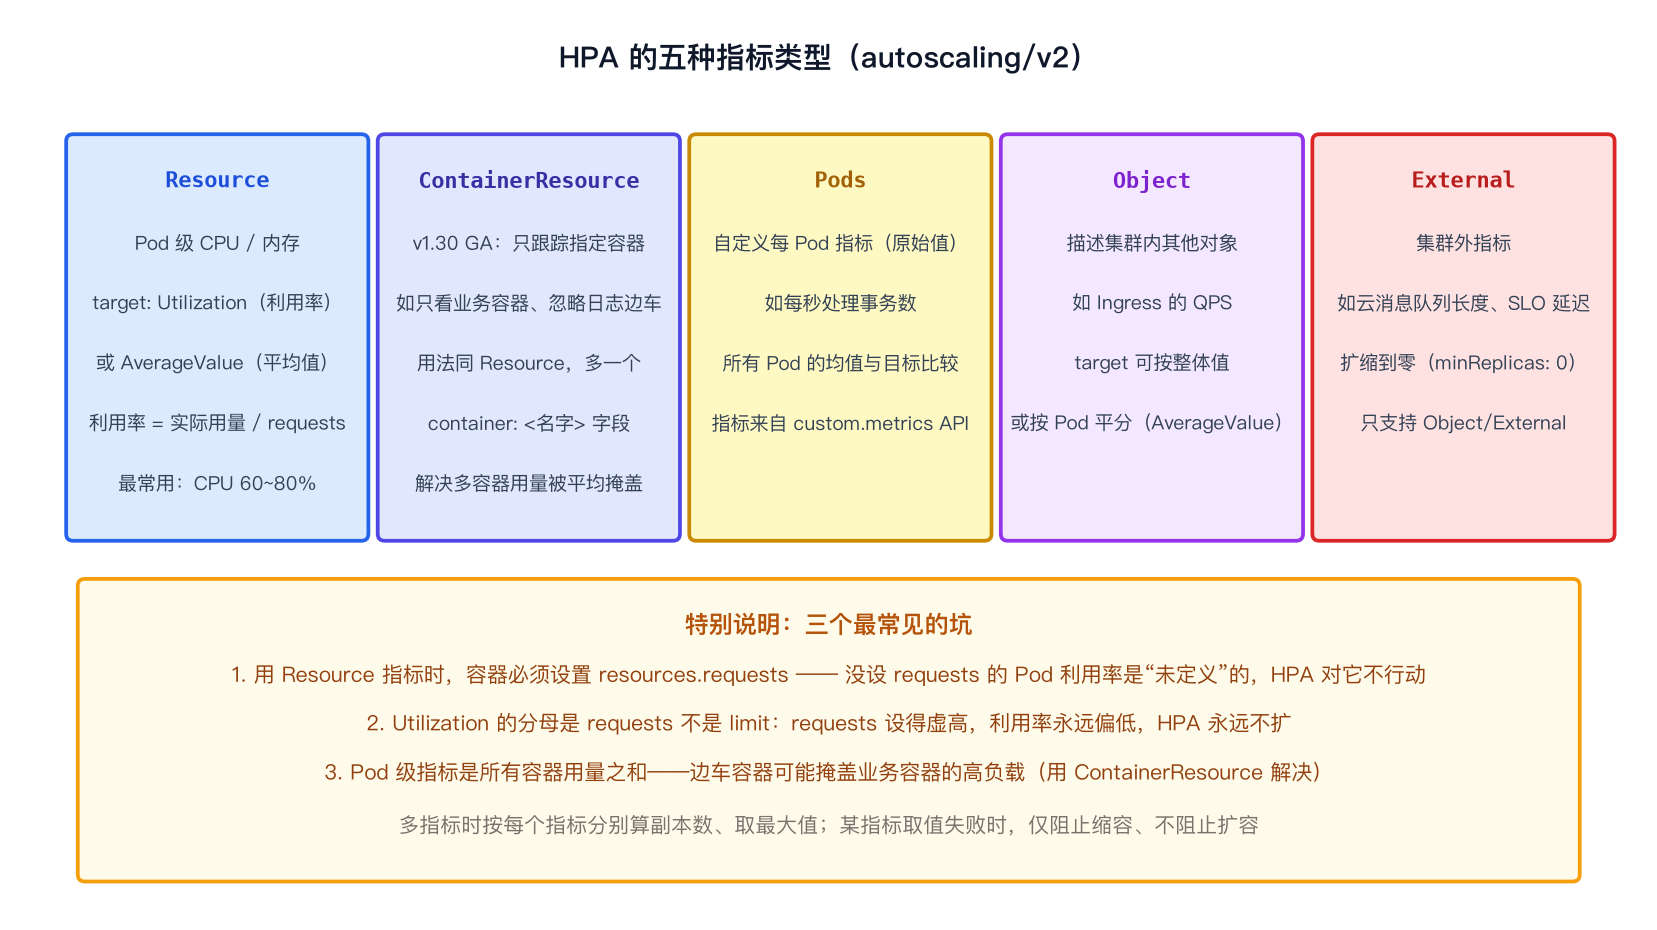
三个最常见的坑(每一个都足以让 HPA "看起来坏了"):
- 容器必须设置
resources.requests:用 Resource 指标时,没设 requests 的 Pod 利用率是"未定义"的,HPA 对它不采取行动; - Utilization 的分母是 requests 不是 limit:requests 设得虚高,利用率永远上不去,HPA 永远不扩;
- Pod 级指标是所有容器之和:日志边车可能把业务容器的高负载"平均"掉——用 ContainerResource(v1.30 GA)只盯业务容器。
完整示例
cat > hpa.yaml << 'EOF'
apiVersion: autoscaling/v2       # 当前稳定版本;v1 下新字段以注解形式保留
kind: HorizontalPodAutoscaler
metadata:
  name: web
spec:
  scaleTargetRef:                # 【必需】要扩缩谁:Deployment / ReplicaSet / StatefulSet
    apiVersion: apps/v1
    kind: Deployment
    name: web
  minReplicas: 2                 # 副本下限(默认 1);缩容不会低于这个数
  maxReplicas: 10                # 副本上限(默认 10);扩容不会超过这个数
  behavior:                      # 【v2 特有】伸缩行为,见下文(不写则用默认策略)
    scaleDown:
      stabilizationWindowSeconds: 300   # 缩容稳定窗口:峰值过后再等 5 分钟才真的缩
  metrics:                       # 【必需】至少一个指标;多个指标时取算出的最大副本数
  - type: Resource
    resource:
      name: cpu
      target:
        type: Utilization        # 利用率:实际用量 / requests;也可用 AverageValue
        averageUtilization: 60   # 全体 Pod 平均 CPU 利用率维持 60%
EOF

kubectl apply -f hpa.yaml
kubectl get hpa web
# NAME   REFERENCE      TARGETS   MINPODS   MAXPODS   REPLICAS
# web    Deployment/web 45%/60%   2         10        4
TARGETS 列 45%/60%:当前利用率 45% / 目标 60%。低于 60% 且超出容差 → 逐步缩容。
伸缩行为 behavior
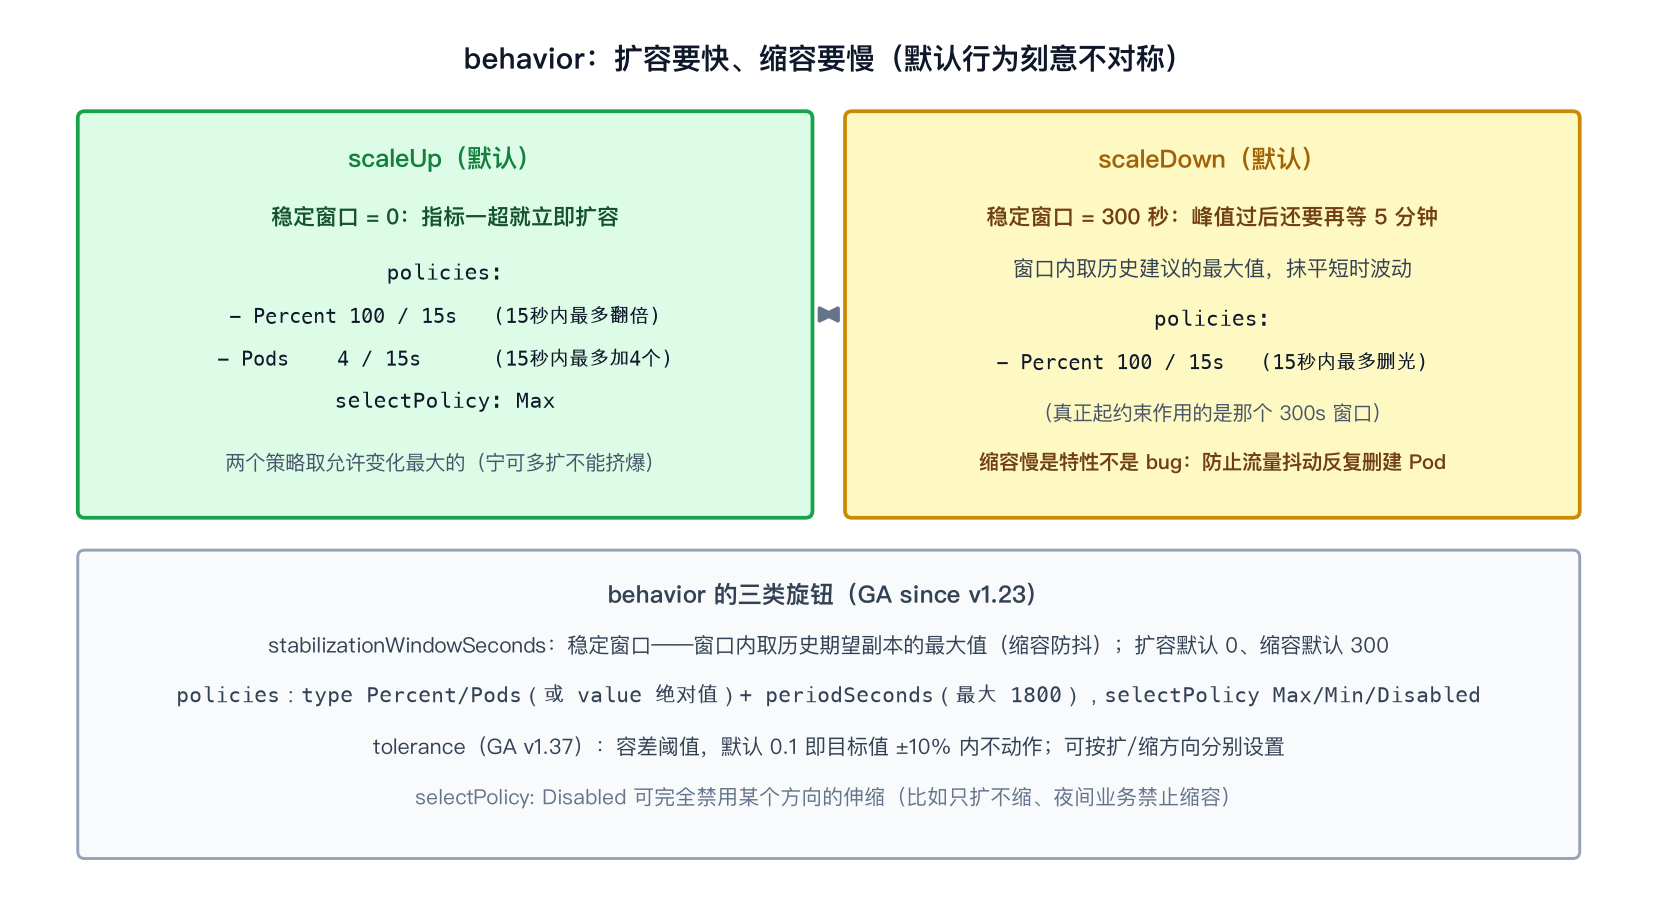
默认行为刻意不对称,这是 HPA 最值得理解的设计:
- 扩容快:稳定窗口 0,指标一超立即扩;每 15 秒最多翻倍或多加 4 个(取 Max);
- 缩容慢:稳定窗口 300 秒——峰值过后还要等 5 分钟,且窗口内取历史建议的最大值,抹平短时波动。
缩容慢是特性不是 bug:防止流量抖动导致反复删建 Pod(flapping)。
三个旋钮(behavior,GA v1.23):
behavior:
  scaleUp:
    tolerance: 0.05              # 扩容容差 5%(GA v1.37;不写用集群默认 10%)
  scaleDown:
    stabilizationWindowSeconds: 60      # 缩容窗口从 300 秒缩短到 1 分钟
    policies:
    - type: Percent
      value: 10                  # 每周期最多缩 10%
      periodSeconds: 60          # "过去 60 秒内"该值成立(最大 1800)
    selectPolicy: Min            # 多个策略取变化最小的(Max/Min/Disabled)
selectPolicy: Disabled 可完全禁用某个方向——比如夜间批处理只允许扩不允许缩。
缺失指标与启动期保护
指标不完整时,HPA 的算法是保守的:
- 正在终止的 Pod、Failed 的 Pod 直接剔除;用 CPU 指标时未就绪 Pod 被搁置;
- 缩容时把缺失指标的 Pod 按消耗目标值的 100% 算,扩容时按 0% 算——宁可少动;
- 重算后若方向反转或落在容差内,本次不伸缩。
启动期保护(容易被忽略,Java 应用尤其要注意):
--horizontal-pod-autoscaler-initial-readiness-delay:默认 30 秒,启动后短暂 Ready 仍算"初始化中",指标被搁置;--horizontal-pod-autoscaler-cpu-initialization-period:默认 5 分钟,窗口内忽略 CPU 指标——防止 JVM 预热期的高 CPU 触发无意义的扩容。
配合手段:给应用配 startupProbe,让"预热完成"(而不是"进程存在")成为 Ready 的标准。
扩缩到零
Beta since v1.37(HPAScaleToZero 默认启用):minReplicas: 0 允许空闲时缩到零、有需求再扩回——只支持 Object / External 指标(CPU/内存只能在运行中的 Pod 上测,设了 0 但没有对象或外部指标会被 API 拒绝)。适合偶发的队列消费者、按需 GPU 作业。缩到零后 HPA 状态会出现 ScaledToZero=True 状况,用于区分"自动缩到零"和"手动停用"。
与滚动更新、手动扩缩的相互作用
- Deployment 的滚动更新由 Deployment 控制器负责(HPA 管它的
replicas,Deployment 再分给各 RS),两者各管一层不打架; - 目标被手动
scale --replicas=0且 minReplicas > 0 时,HPA 会停止调整(ScalingActive=False)——这是"手动停用"的开关,不是故障; - 改节点标签、paused 状态等场景下 HPA 照常工作。
状态条件与故障排查
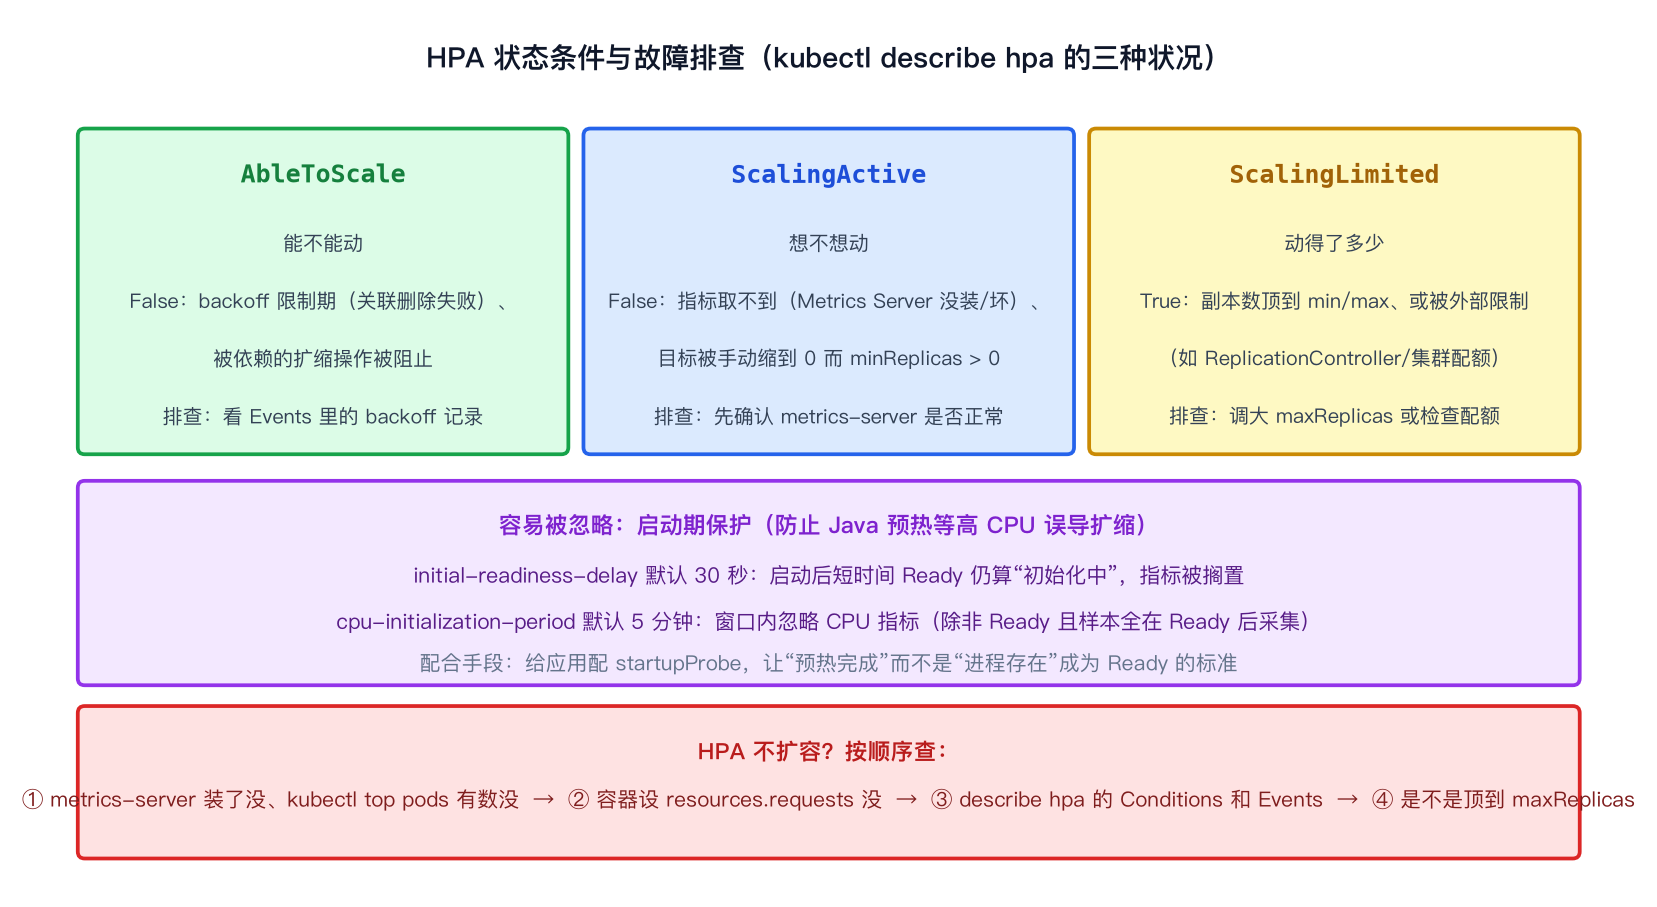
kubectl describe hpa 的 Conditions 回答三个问题:AbleToScale(能不能动)、ScalingActive(想不想动,指标取得到吗)、ScalingLimited(动得了多少,是不是顶到 min/max)。
① Metrics Server 装了没——kubectl top pods 有数没(它需要单独安装,且 HPA 只支持 metrics.k8s.io/v1beta1,不支持 v1);
② 容器设了 resources.requests 没;
③ describe hpa 看 Conditions 和 Events(backoff、指标失败原因都在这);
④ 是不是顶到 maxReplicas 或被资源配额卡住(ScalingLimited=True)。
我的总结与避坑清单
- 三个前提缺一不可:Metrics Server 已安装、容器设了 requests、目标支持 scale 子资源——HPA"不工作"九成是这三样;
- 从清单里删掉
spec.replicas(启用 HPA 后):否则每次 apply 都会把副本数打回清单值,和 HPA 打架。注意直接删可能让副本掉到 1——正确姿势:kubectl apply edit-last-applied先把 live 对象里的该键去掉,再改源码清单; - 缩容慢(5 分钟窗口)不是故障:想调快改
behavior.scaleDown.stabilizationWindowSeconds,但想清楚抖动风险; - HPA 和 VPA 别对同一资源同时用(都是 CPU/内存时互相打架),要组合就用多维度 VPA + 自定义指标 HPA;
- 容差 10% 意味着小波动不伸缩:指标在目标 ±10% 内 HPA 按兵不动,别误判为失灵;
- 负载必须是水平可分的:有状态单点、本地缓存强依赖的 应用不适合 HPA,扩了副本也分不走流量;
- HPA 只管 Pod 数量:节点不够时 Pod 会 Pending——HPA 经常和 Cluster Autoscaler(节点扩缩)配合使用;
- 用
kubectl top pods先验证指标链路,再怀疑 HPA 本身。

