Job详解
Job 表示一次性任务,运行完就会停止:它创建一个或多个 Pod,并持续重试,直到成功终止的 Pod 数量达到要求。与 Deployment/RS 管"永不退出的服务"完全相反——Job 管的 Pod 以终止为成功,控制器一旦把 Pod 拉起来就不会让它常驻。删除 Job 会清除全部 Pod;挂起 Job 会先删掉所有活跃 Pod,恢复后再重跑。
工作原理:三个关键计数器
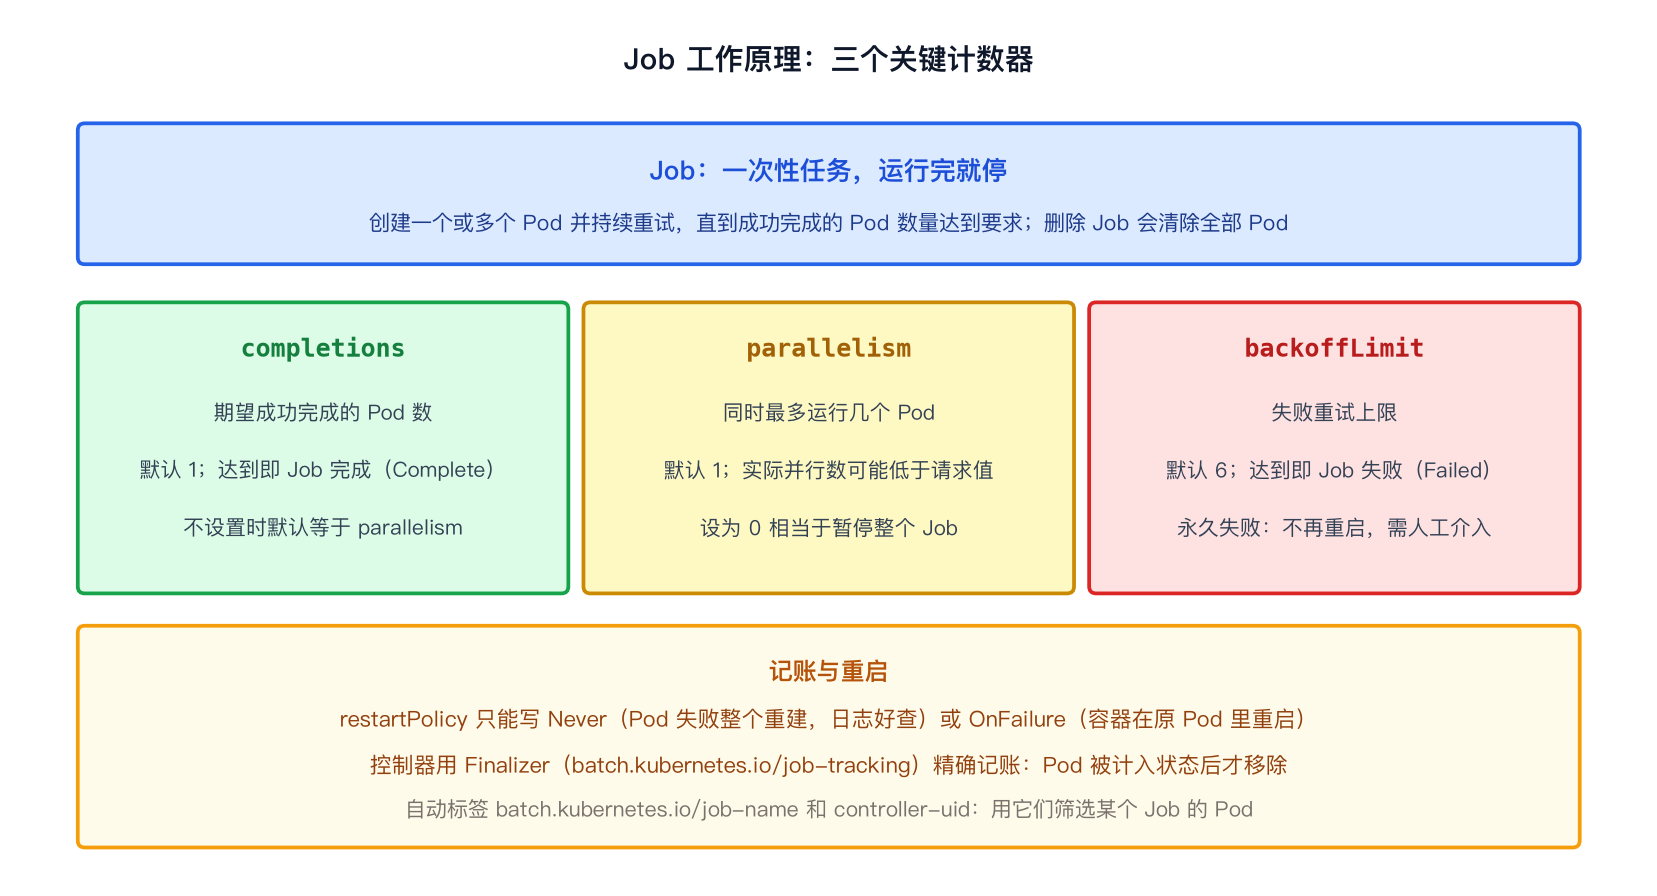
理解 Job 就是理解三个数字的关系:
- completions:要成功完成多少个 Pod(默认 1),达到即 Complete;
- parallelism:同时最多跑几个(默认 1),设 0 相当于暂停;
- backoffLimit:失败重试上限(默认 6),达到即 Failed——永久失败,不再重启,需要人工介入。
两个容易忽略的机制:
- 记账靠 Finalizer:Job 创建的 Pod 带着
batch.kubernetes.io/job-trackingFinalizer,控制器把 Pod 计入状态后才移除它——保证完成计数不重不漏(GA v1.26)。 - restartPolicy 只能是 Never 或 OnFailure:
Always对 Job 不合法(Pod 模板不写时默认值恰是 Always,必须显式改掉)。两者取舍:Never时 Pod 失败整个重建,原 Pod 保留、日志好查;OnFailure时容器在原 Pod 内重启,省对象但达到重试上限时 Pod 被原地终止、难调试。 .spec.selector不需要手动设置,系统会自动填充一个不重叠的选择算符。
快速上手
cat > job.yaml << 'EOF'
apiVersion: batch/v1           # Job/CronJob 属于 batch API 组
kind: Job
metadata:
  name: pi
spec:
  # completions: 10            # 期望成功完成的 Pod 数(默认 1);不设则为工作队列模式
  # parallelism: 3             # 同时最多运行几个 Pod(默认 1);设 0 相当于暂停
  # completionMode: Indexed    # 给每个 Pod 发索引 0~completions-1(默认 NonIndexed)
  template:                    # .spec 中唯一必需的字段:Pod 模板
    spec:
      restartPolicy: Never     # 【Job 特有约束】只能 Never 或 OnFailure,不能 Always
      containers:
      - name: pi
        image: perl:5.34.0
        command: ["perl", "-Mbignum=bpi", "-wle", "print bpi(2000)"]
  backoffLimit: 4              # 失败重试上限(默认 6),超过则 Job 标记 Failed(永久失败)
  # activeDeadlineSeconds: 100 # 整个 Job 的生命期限时;优先级高于 backoffLimit,到点全停
  # ttlSecondsAfterFinished: 100  # Job 结束 100 秒后自动删除(级联清 Pod);建议总是设置
  # suspend: false             # 置 true 挂起:终止所有运行中的 Pod,恢复后 deadline 计时重置
EOF

kubectl apply -f job.yaml
kubectl describe job pi
describe 输出的关键字段:
Parallelism:    1               # 当前并行度
Completions:    1               # 目标成功数
Pods Statuses:  0 Running / 1 Succeeded / 0 Failed
Events:
  Normal  SuccessfulCreate  ... Created pod: pi-xf9p4
  Normal  Completed         ... Job completed
取任务输出(靠自动标签 batch.kubernetes.io/job-name 筛选):
pods=$(kubectl get pods --selector=batch.kubernetes.io/job-name=pi \
  --output=jsonpath='{.items[*].metadata.name}')
kubectl logs $pods
# 3.14159265358979323846...
三种并行模式
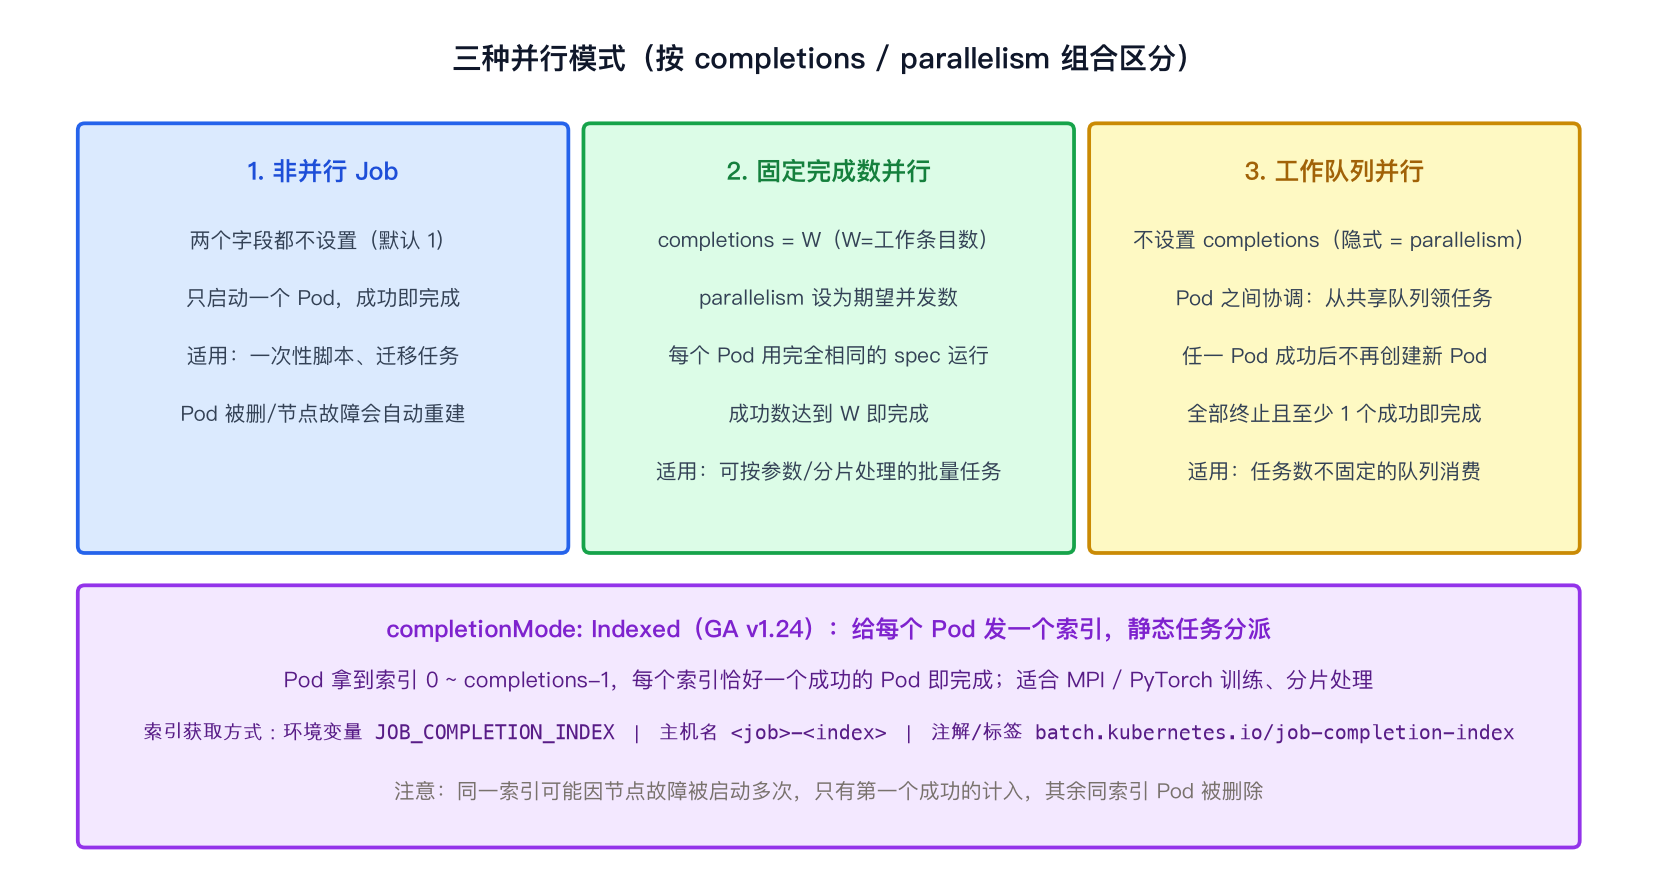
| 模式 | completions | parallelism | 适用 |
|---|---|---|---|
| 非并行 | 不设置(=1) | 不设置(=1) | 一次性脚本、迁移 |
| 固定完成数并行 | W(工作条目数) | 期望并发数 | 可分片的批量任务 |
| 工作队列并行 | 不设置(=parallelism) | 任意 | 任务数不定的队列消费 |
Indexed 模式(completionMode: Indexed,GA v1.24)值得单独记:每个 Pod 拿到 0 ~ completions-1 的索引,每个索引恰好一个成功的 Pod 即完成。索引通过环境变量 JOB_COMPLETION_INDEX、主机名 <job>-<index>(配 Service 可互相寻址)、注解/标签获取——MPI、PyTorch 分布式训练、静态任务分派都靠它。注意同一索引可能因节点故障被启动多次,只有第一个成功的计入,其余同索引 Pod 会被删掉。
失败处理:重试、限时、止损、清理
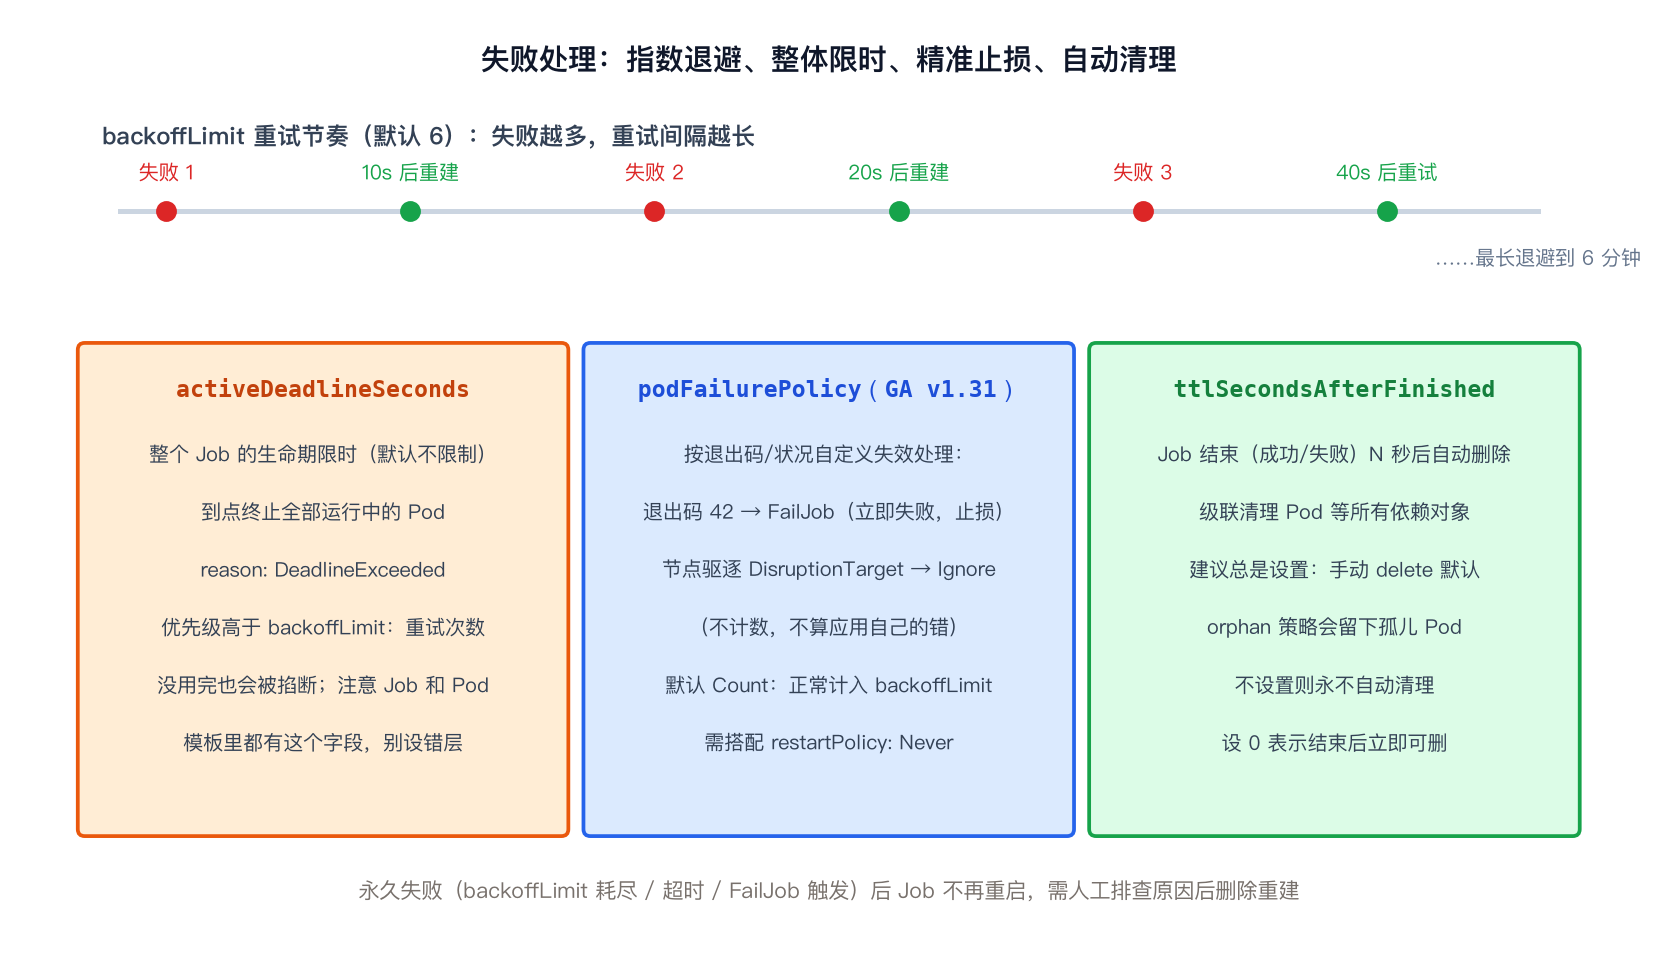
四个维度各管一件事,组合起来才是完整的失败策略:
- backoffLimit(默认 6):重试间隔指数增长(10s → 20s → 40s,封顶 6 分钟)。计数规则:
restartPolicy: Never数 Failed 的 Pod 数;OnFailure数容器重启次数。 - activeDeadlineSeconds:整个 Job 的生命期限时,优先级高于 backoffLimit——重试次数没用完也会被掐断(reason: DeadlineExceeded)。注意 Job 的 spec 和 Pod 模板的 spec 都有这个字段,语义不同,别设错层。
- podFailurePolicy(GA v1.31):按退出码/状况精准处置,必须配
restartPolicy: Never:
cat > job-failure-policy.yaml << 'EOF'
apiVersion: batch/v1
kind: Job
metadata:
  name: job-pod-failure-policy
spec:
  completions: 12
  parallelism: 3
  backoffLimit: 6
  podFailurePolicy:            # 【Job 特有】按退出码/状况定义失效如何处理;规则按序匹配
    rules:
    - action: FailJob          # 退出码 42 → 立即让整个 Job 失败,不再无意义重试
      onExitCodes:
        containerName: main    # 可选;不写则适用于所有容器
        operator: In           # In / NotIn
        values: [42]
    - action: Ignore           # 节点驱逐等干扰(DisruptionTarget 状况)→ 不计入 backoffLimit
      onPodConditions:
      - type: DisruptionTarget
    # action 还有 Count(默认,正常计数)和 FailIndex(配合逐索引回退)
  template:
    spec:
      restartPolicy: Never     # 使用 podFailurePolicy 的硬性要求
      containers:
      - name: main
        image: docker.io/library/bash:5
        command: ["bash"]
        args: ["-c", "echo Hello world! && sleep 5 && exit 42"]
EOF
- ttlSecondsAfterFinished(GA v1.23):Job 结束 N 秒后自动删除(级联清 Pod)。建议总是设置:手动
kubectl delete job默认是 orphan 策略,会留下孤儿 Pod 拖垮集群性能。
backoffLimit 耗尽、超过 activeDeadlineSeconds、命中 FailJob 规则——这三种失败都是终态,Job 不会自己恢复。先看日志找原因(这也是 restartPolicy: Never 更受推荐的原因:失败现场保留),再删除重建。
暂停与恢复
kubectl patch job/myjob --type=strategic --patch '{"spec":{"suspend":true}}'
kubectl patch job/myjob --type=strategic --patch '{"spec":{"suspend":false}}'
挂起会终止所有运行中的 Pod(这些 Pod 不计入 completions);恢复后 .status.startTime 被重置,所以 activeDeadlineSeconds 的计时在挂起期间停止、恢复时重新计算。parallelism 设 0 也能达到类似暂停效果。
其他实用特性速查
| 特性 | 说明 |
|---|---|
backoffLimitPerIndex + maxFailedIndexes(GA v1.33) | Indexed Job 每个索引独立计失败次数;失败索引记入 .status.failedIndexes,不中断其他索引 |
successPolicy | Indexed Job 提前宣告成功:如"索引 0,2-3 中任一成功即算成功"(领导者-工作者模式,MPI/PyTorch 只看 leader) |
podReplacementPolicy: Failed(GA v1.34) | 等 Pod 完全 Failed 才建替代 Pod(默认发现终止就建,运行数可能瞬时超过 parallelism);.status.terminating 可看终止中的数量 |
| 弹性 Indexed Job(GA v1.31) | 可同时改 parallelism 和 completions 扩缩(保持相等),适合 MPI/Ray 训练 |
| 可变调度指令(GA v1.27) | 暂停中的 Job 可改 nodeAffinity/tolerations/labels,恢复后生效——给队列控制器留的钩子 |
manualSelector: true | 手动指定 selector:删除旧 Job 留 Pod(--cascade=orphan)后,新 Job 接管现有 Pod |
managedBy(GA v1.35) | 把 Job 托管给外部控制器(如 Kueue/JobSet) |
我的总结与避坑清单
- 任务代码必须幂等:即使 parallelism=1、completions=1,同一程序仍可能被启动两次(Pod 失败重建、节点驱逐)——程序要能处理"新 Pod 中有旧 Pod 的残留"(临时文件、锁、不完整输出)。
- 宁要 Never,不要 OnFailure:调试期尤其如此。OnFailure 达到上限会原地终止 Pod,现场都没了;Never 保留失败 Pod 供查日志。
- ttlSecondsAfterFinished 建议总是设:否则手动清理时会留孤儿 Pod。
- 想"限时重试"就两个都用:backoffLimit 管次数、activeDeadlineSeconds 管总时长,别指望一个字段搞定。
- 裸 Pod 别拿来跑批:节点重启/失败时裸 Pod 不重建;哪怕只跑一个 Pod 也用 Job(Job 还会重试)。
- 完成 ≠ 删除:Job 完成后 Pod 保留(供查日志),Job 对象也保留——定期清理靠 ttl 或 CronJob 的 history limit。
- 并行数可能达不到请求值:受剩余完成数、配额、退避压制、体面终止耗时等影响,监控时以 Succeeded/Failed 计数为准,不要盯着瞬时 Pod 数。
替代方案
| 方案 | 差异 |
|---|---|
| 裸 Pod | 节点故障后不重建;Job 会重建并重试 |
| Deployment / RS | 管"不希望终止"的服务;Job 管"以终止为成功"的批任务 |
| 单 Job + 控制器 Pod | Job 只起一个"总控" Pod 去拉起其他 Pod——灵活但复杂,一般不需要 |
| CronJob | 需要按时间排期反复运行时用 |

