ReplicaSet 详解
ReplicaSet(简称 RS)的作用是维持任意时刻都有一组稳定数量的 Pod 副本在运行。它定义了三样东西:识别 Pod 的选择算符(selector)、期望的副本数量(replicas)、以及创建新 Pod 时要用的 Pod 模板(template)——当实际运行的 Pod 数量与期望不符时,RS 自动创建或删除 Pod 来对齐。
实际生产中你几乎不会直接操作 ReplicaSet——通常定义一个 Deployment,由它自动创建和管理 RS。RS 存在的价值是给 Deployment 当"副本维持器",除非你需要自定义更新流程或根本不需要更新,否则请直接用 Deployment。
工作原理
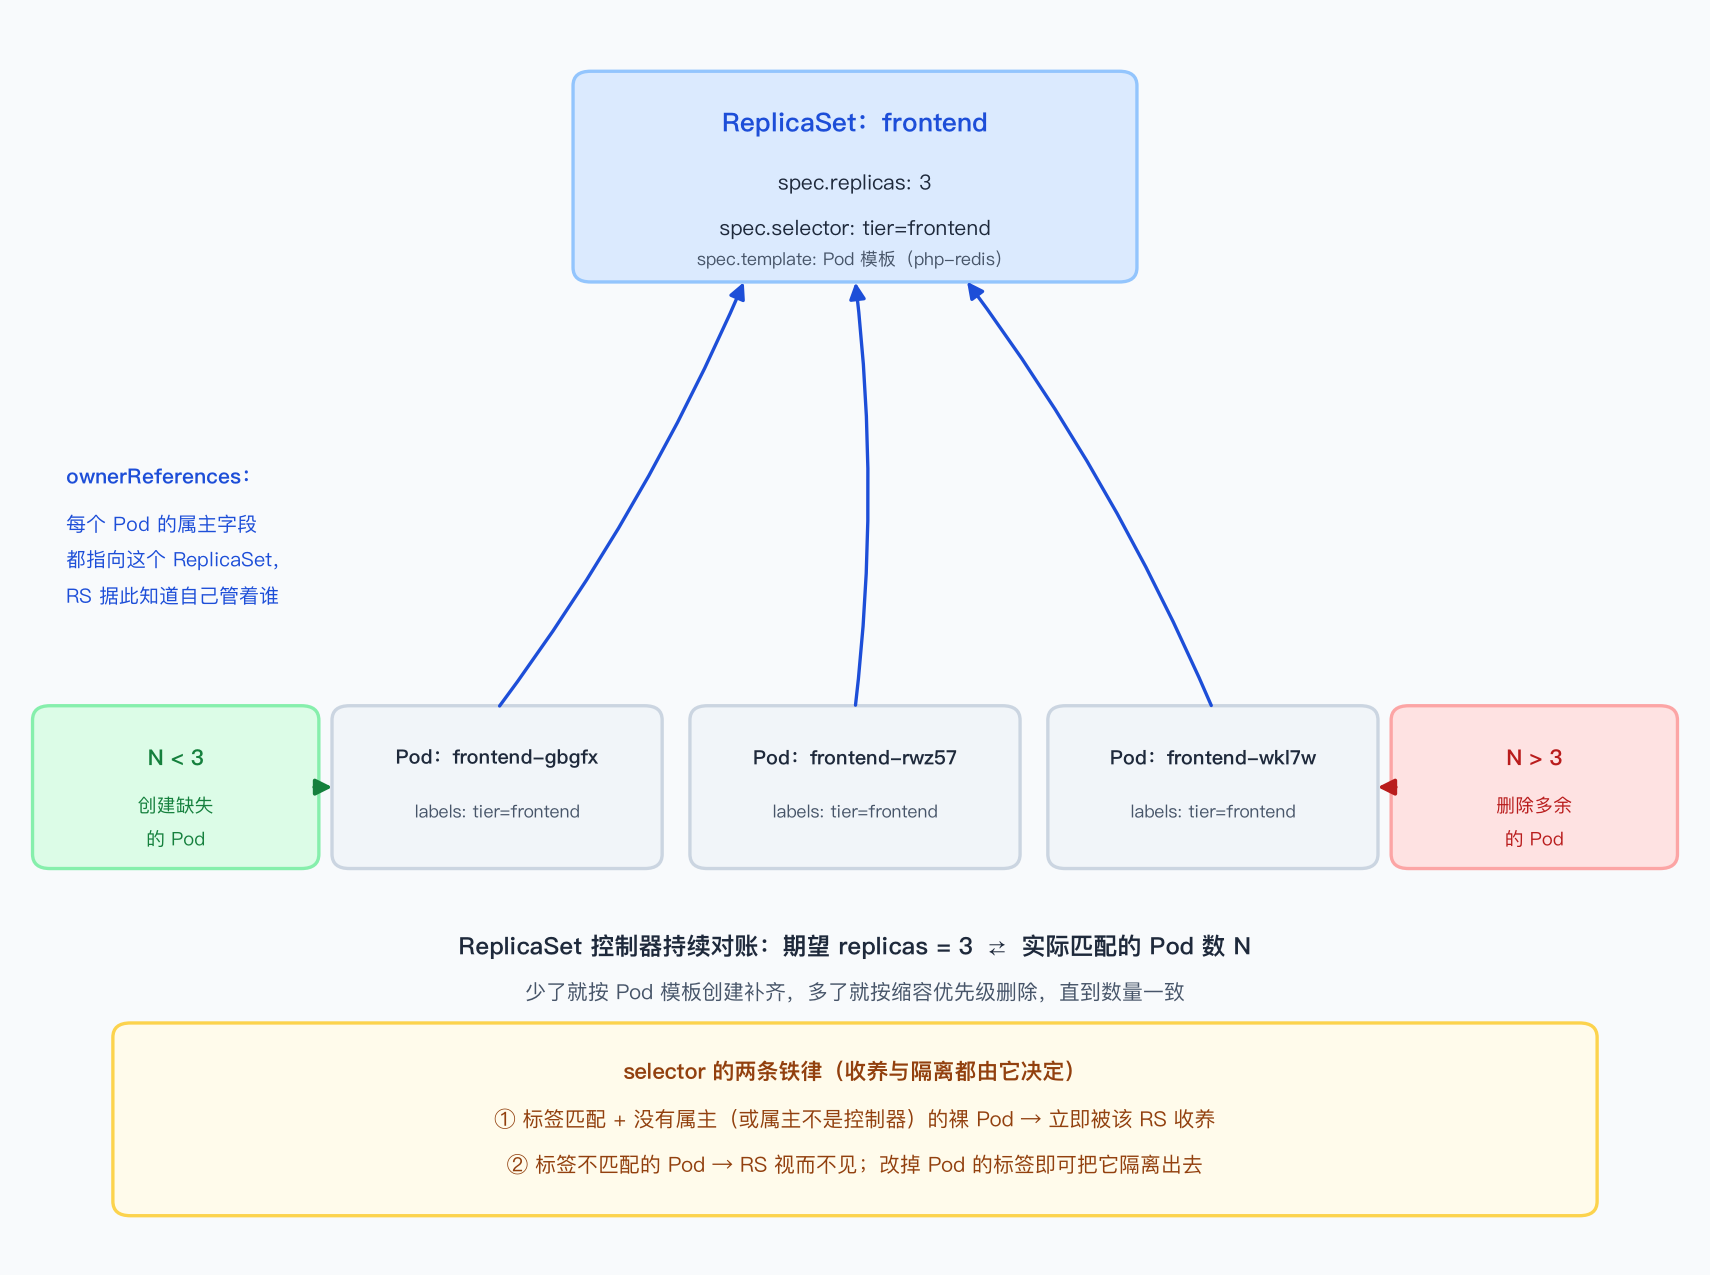
RS 与 Pod 之间靠两条纽带协作:
- selector(选择算符):RS 用它筛选自己管的 Pod。只要 Pod 的标签匹配 selector,就进入这个 RS 的管辖范围。
- ownerReferences(属主引用):Pod 的
metadata.ownerReferences字段记录它的属主是谁。RS 创建的 Pod、以及被 RS 收养的 Pod,这个字段里都会写入对应 RS 的信息——这是 RS 知道"哪些 Pod 归我"的权威依据。
控制器持续对账:实际 Pod 数少于 replicas 就按模板创建,多了就按缩容优先级删除。特别的是,RS 不限于管自己创建的 Pod——如果某个 Pod 没有属主(或属主不是控制器),且标签匹配某 RS 的 selector,它会立即被这个 RS 收养。
快速上手示例
cat > frontend.yaml << 'EOF'
apiVersion: apps/v1              # RS 属于 apps/v1 API 组(工作负载类资源统一在这组下)
kind: ReplicaSet
metadata:
  name: frontend
  labels:
    app: guestbook
    tier: frontend               # 这是 RS 自身的标签,仅用于管理,与下面的 selector 无关
spec:
  replicas: 3                    # 期望副本数,默认 1;实际数量随时被控制器对齐到这个值
  selector:                      # 【RS 的核心】识别"哪些 Pod 归它管"——只认标签不认名字
    matchLabels:
      tier: frontend             # 必须与 template.metadata.labels 匹配,否则 API 直接拒绝
    # 也可用 matchExpressions 写复杂条件(In/NotIn/Exists/DoesNotExist);
    # 与 matchLabels 同时指定时按 AND 组合
  template:                      # Pod 模板:语法与 Pod 清单相同,但不含 apiVersion/kind
    metadata:
      labels:
        tier: frontend           # 必须与上面的 selector 匹配
    spec:
      restartPolicy: Always      # RS 只允许 Always(默认值),写别的会被拒绝
      containers:
      - name: php-redis
        image: uhub.service.ucloud.cn/996.icu/gb-frontend:v3
  # 注意:RS 没有 strategy 字段!它不会滚动更新——修改模板只影响之后新建的 Pod,
  # 已运行的 Pod 原样不动(这正是要用 Deployment 包一层的原因,见"与 Deployment 的关系"一节)
  # terminationGracePeriodSeconds、resources 等通用 Pod 层字段照常在 template.spec 里配
EOF

kubectl apply -f frontend.yaml
查看创建结果:
kubectl get rs
# NAME       DESIRED   CURRENT   READY   AGE
# frontend   3         3         3       39s

kubectl get pods
# NAME             READY   STATUS    RESTARTS   AGE
# frontend-6778b   1/1     Running   0          50s
# frontend-dxbtc   1/1     Running   0          50s
# frontend-fbwfv   1/1     Running   0          50s
查看 RS 详情和事件(能看到 replicaset-controller 逐个创建 Pod 的记录):
kubectl describe rs/frontend
验证属主关系——取任一 Pod 的 YAML,metadata.ownerReferences 中写的就是这个 RS:
kubectl get pods frontend-6778b -o yaml
apiVersion: v1
kind: Pod
metadata:
  generateName: frontend-
  labels:
    tier: frontend
  name: frontend-6778b
  ownerReferences:
  - apiVersion: apps/v1
    blockOwnerDeletion: true
    controller: true
    kind: ReplicaSet
    name: frontend
    uid: f33c0445-3139-42f7-a0b0-2617b22b57cb
非模板 Pod 的收养与终止
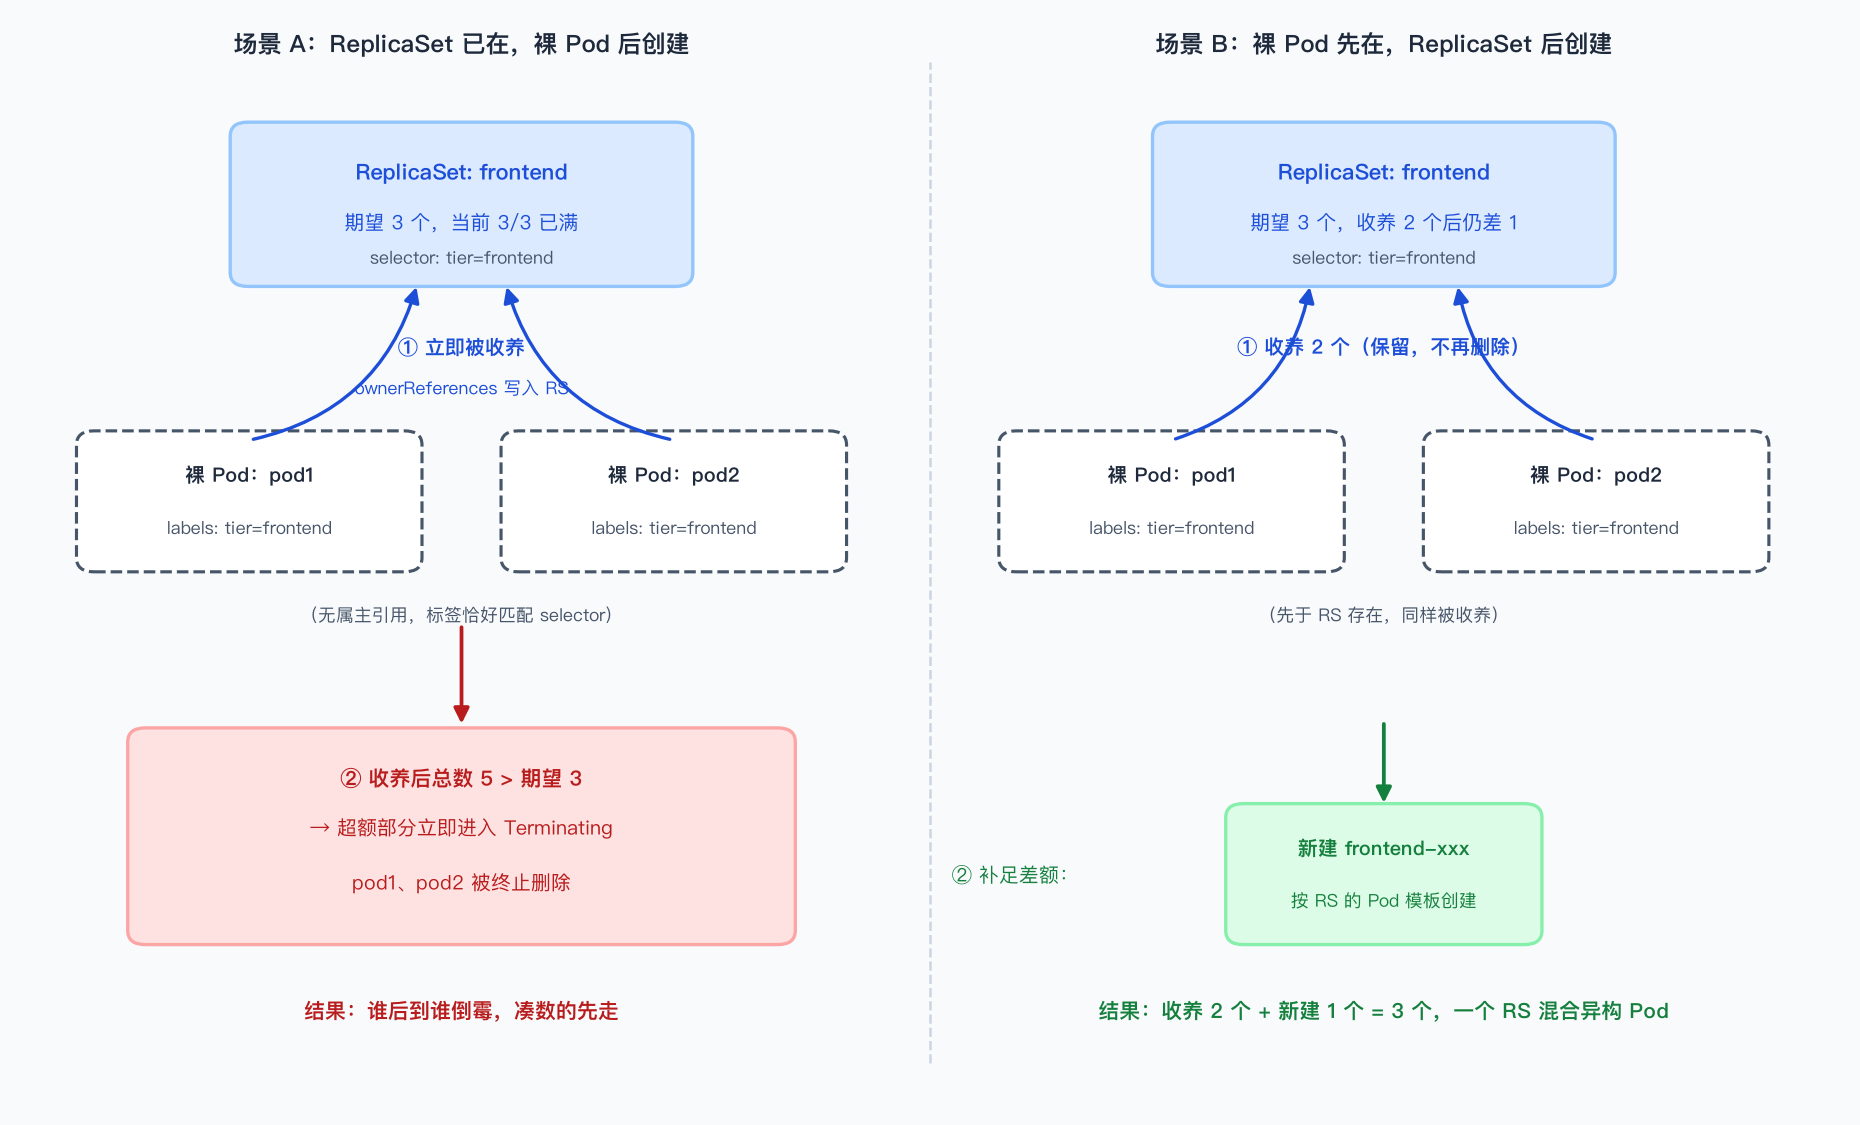
RS 并不只管自己创建的 Pod。创建一个与 selector 匹配的裸 Pod(无属主引用),它会立即被 RS 收养——收养之后发生什么,取决于 RS 当时缺不缺人:
两个实验对应的 YAML(两个裸 Pod,标签恰好是 tier: frontend):
cat > pod-rs.yaml << 'EOF'
apiVersion: v1
kind: Pod
metadata:
  name: pod1
  labels:
    tier: frontend
spec:
  containers:
  - name: hello1
    image: uhub.service.ucloud.cn/996.icu/hello-app:2.0
---
apiVersion: v1
kind: Pod
metadata:
  name: pod2
  labels:
    tier: frontend
spec:
  containers:
  - name: hello2
    image: uhub.service.ucloud.cn/996.icu/hello-app:1.0
EOF
RS 已 3/3 满员时 kubectl apply -f pod-rs.yaml,pod1/pod2 被收养后总数变 5,超出期望,立即进入 Terminating 被删除:
NAME             READY   STATUS        RESTARTS   AGE
frontend-6778b   1/1     Running       0          14m
frontend-dxbtc   1/1     Running       0          14m
frontend-fbwfv   1/1     Running       0          14m
pod1             0/1     Terminating   0          6s
pod2             0/1     Terminating   0          6s
先 apply pod-rs.yaml,再 apply frontend.yaml:新 RS 收养这两个 Pod(不删除),只按模板补 1 个新 Pod 凑够 3 个。于是这个 RS 里同时有 2 个"来历不同"的 Pod + 1 个模板新建的 Pod——一个 RS 可以包含异构的 Pod 集合:
NAME             READY   STATUS    RESTARTS   AGE
frontend-7dcnt   1/1     Running   0          8s
pod1             1/1     Running   0          35s
pod2             1/1     Running   0          35s
直接创建裸 Pod 时,务必确保它的标签不会匹配任何已存在 RS 的 selector——否则收养机制会把你的 Pod 无声无息地管起来甚至删掉。这也解释了为什么生产环境建议所有 Pod 都交给工作负载资源管理,不要裸建。
编写 ReplicaSet 清单的规范
apiVersion: apps/v1、kind: ReplicaSet、metadata、.spec 四部分缺一不可。三个关键字段:
Pod 模板(.spec.template)
- 必须设置标签,且
.spec.template.metadata.labels必须与.spec.selector匹配,否则 API 直接拒绝创建; - 模板标签不要与其他控制器(Deployment/StatefulSet 等)的 selector 重叠,否则会被别的控制器抢收养;
.spec.template.spec.restartPolicy唯一允许的值是Always(也是默认值),写别的直接报错。
选择算符(.spec.selector)
.spec.selector 是标签选择算符,决定 RS 管辖哪些 Pod。支持 matchLabels(精确匹配)和 matchExpressions(基于集合的表达式)两种写法。
两个 RS 设置了相同的 .spec.selector、但模板不同——它们互不接管对方创建的 Pod,各自只管自己创建的。唯一的例外是无属主的裸 Pod(谁匹配谁收养)。
副本数(.spec.replicas)
期望同时运行的 Pod 数量,RS 创建/删除 Pod 向它对齐。不指定时默认为 1。
另外,RS 的 .metadata.name 必须是合法的 DNS 子域名;由于它会被用作 Pod 名的前缀(generateName: <RS名>-),建议按更严格的 DNS 标签规则命名。
日常操作
删除:级联删除与孤儿 Pod
# 默认:删除 RS + 级联删除它所有的 Pod(垃圾收集器负责)
kubectl delete rs frontend

# 只删 RS,把 Pod 留下来(ownerReferences 被清空,Pod 变成无主孤儿)
kubectl delete rs frontend --cascade=orphan
通过 REST API / client-go 删除时必须显式设置 propagationPolicy(Background / Foreground / Orphan):
kubectl proxy --port=8080
curl -X DELETE 'localhost:8080/apis/apps/v1/namespaces/default/replicasets/frontend' \
  -d '{"kind":"DeleteOptions","apiVersion":"v1","propagationPolicy":"Foreground"}' \
  -H "Content-Type: application/json"
--cascade=orphan 的经典用法:删掉旧 RS 后,创建一个 selector 相同的新 RS,孤儿 Pod 会被新 RS 收养——但注意新 RS 只会补足数量,不会把已有 Pod 改造成新模板。想要可控地更新 Pod,请用 Deployment(RS 不支持滚动更新)。
隔离 Pod
改掉 Pod 的标签(不再匹配 selector),它就被"隔离"出 RS,RS 会自动补一个新 Pod 顶上。适合把故障 Pod 摘出来排错、做数据恢复:
kubectl label pod frontend-6778b tier- # 删除 tier 标签,触发隔离
扩缩容
修改 .spec.replicas 即可,kubectl 层面三种方式等价:
kubectl scale rs frontend --replicas=5    # 命令行直改
kubectl edit rs frontend                  # 在线编辑
kubectl apply -f frontend.yaml            # 改 yaml 重新声明
缩容时删谁有讲究,控制器按以下优先级排序选择被删的 Pod:
- 优先删除悬决(Pending 且不可调度)的 Pod;
- 设置了
controller.kubernetes.io/pod-deletion-cost注解的,注解值小的优先删; - 所在节点上副本数较多的 Pod 优先于较少的(让 Pod 分布更均匀);
- 创建时间越晚的优先删(
LogarithmicScaleDown特性门控启用时按整数幂级分组)。
以上全部相同时,随机选择。
Pod 删除开销注解(v1.22 beta)
controller.kubernetes.io/pod-deletion-cost 注解让你对"缩容先删谁"表达偏好,设置在 Pod 上,取值范围 [-2147483648, 2147483647],未设置默认 0,可以是负数;非法值会被 API 拒绝:
# 缩容时尽量保住这个 Pod(开销设得高)
kubectl annotate pod frontend-6778b controller.kubernetes.io/pod-deletion-cost=1000
- 该机制尽力而为,不保证删除顺序;
- 不要频繁更新注解值(比如跟着某个监控指标实时变),会给 API 服务器制造大量 Pod 更新请求。典型用法是应用在缩容前一次性设置好——例如 Spark 的 driver Pod 设高开销、executor 设低开销,缩容时优先回收 executor。
作为 HPA 的扩缩目标
RS 可以直接作为 HorizontalPodAutoscaler 的目标,按 CPU 利用率自动扩缩:
cat > hpa-rs.yaml << 'EOF'
apiVersion: autoscaling/v1
kind: HorizontalPodAutoscaler
metadata:
  name: frontend-scaler
spec:
  scaleTargetRef:
    kind: ReplicaSet
    name: frontend
  minReplicas: 3
  maxReplicas: 10
  targetCPUUtilizationPercentage: 50
EOF

kubectl apply -f hpa-rs.yaml
或者一条命令等价完成:
kubectl autoscale rs frontend --min=3 --max=10 --cpu-percent=50
注意:HPA 与手动 scale 冲突——HPA 管着副本数时不要再手动改 replicas。
终止中的 Pod(v1.35 beta)
删除或缩容产生的 Pod 可能因优雅终止耗时较长而迟迟不退出,期间 Pod 总数会暂时超过 replicas。启用 DeploymentReplicaSetTerminatingReplicas 特性门控(API 服务器与 kube-controller-manager)后,可通过 .status.terminatingReplicas 字段观测这些"正在退场"的 Pod。
替代方案:什么场景用什么
| 场景 | 用什么 | 原因 |
|---|---|---|
| 无状态应用、需要滚动更新 | Deployment(推荐) | 管理 RS 并提供声明式滚动更新、回滚、暂停恢复 |
| 只跑一个 Pod 的应用 | Deployment / RS | 节点故障时能自动重建;裸 Pod 挂了就没了 |
| 跑完就退出的任务 | Job | Pod 期望自行终止,RS 会把正常退出的 Pod 又拉起来 |
| 每个节点都要跑一个 | DaemonSet | 主机级功能(监控、日志收集),Pod 生命周期与节点绑定 |
| 老古董(不推荐) | ReplicationController | RS 的前身,不支持基于集合的 selector,已被取代 |
RS 会替换因节点故障、内核升级等被删除/终止的 Pod——把它想象成一个跨节点的进程监视器:本地容器重启委托给 kubelet,跨节点重建委托给 RS。哪怕只需要一个 Pod,也应该用 Deployment 或 RS 而不是裸 Pod。
与 Deployment 的关系:为什么中间要夹一层 RS
很多人第一次看控制器体系都会问:Deployment 已经能管副本数了,为什么不让它直接管 Pod,中间非要夹一层 RS?
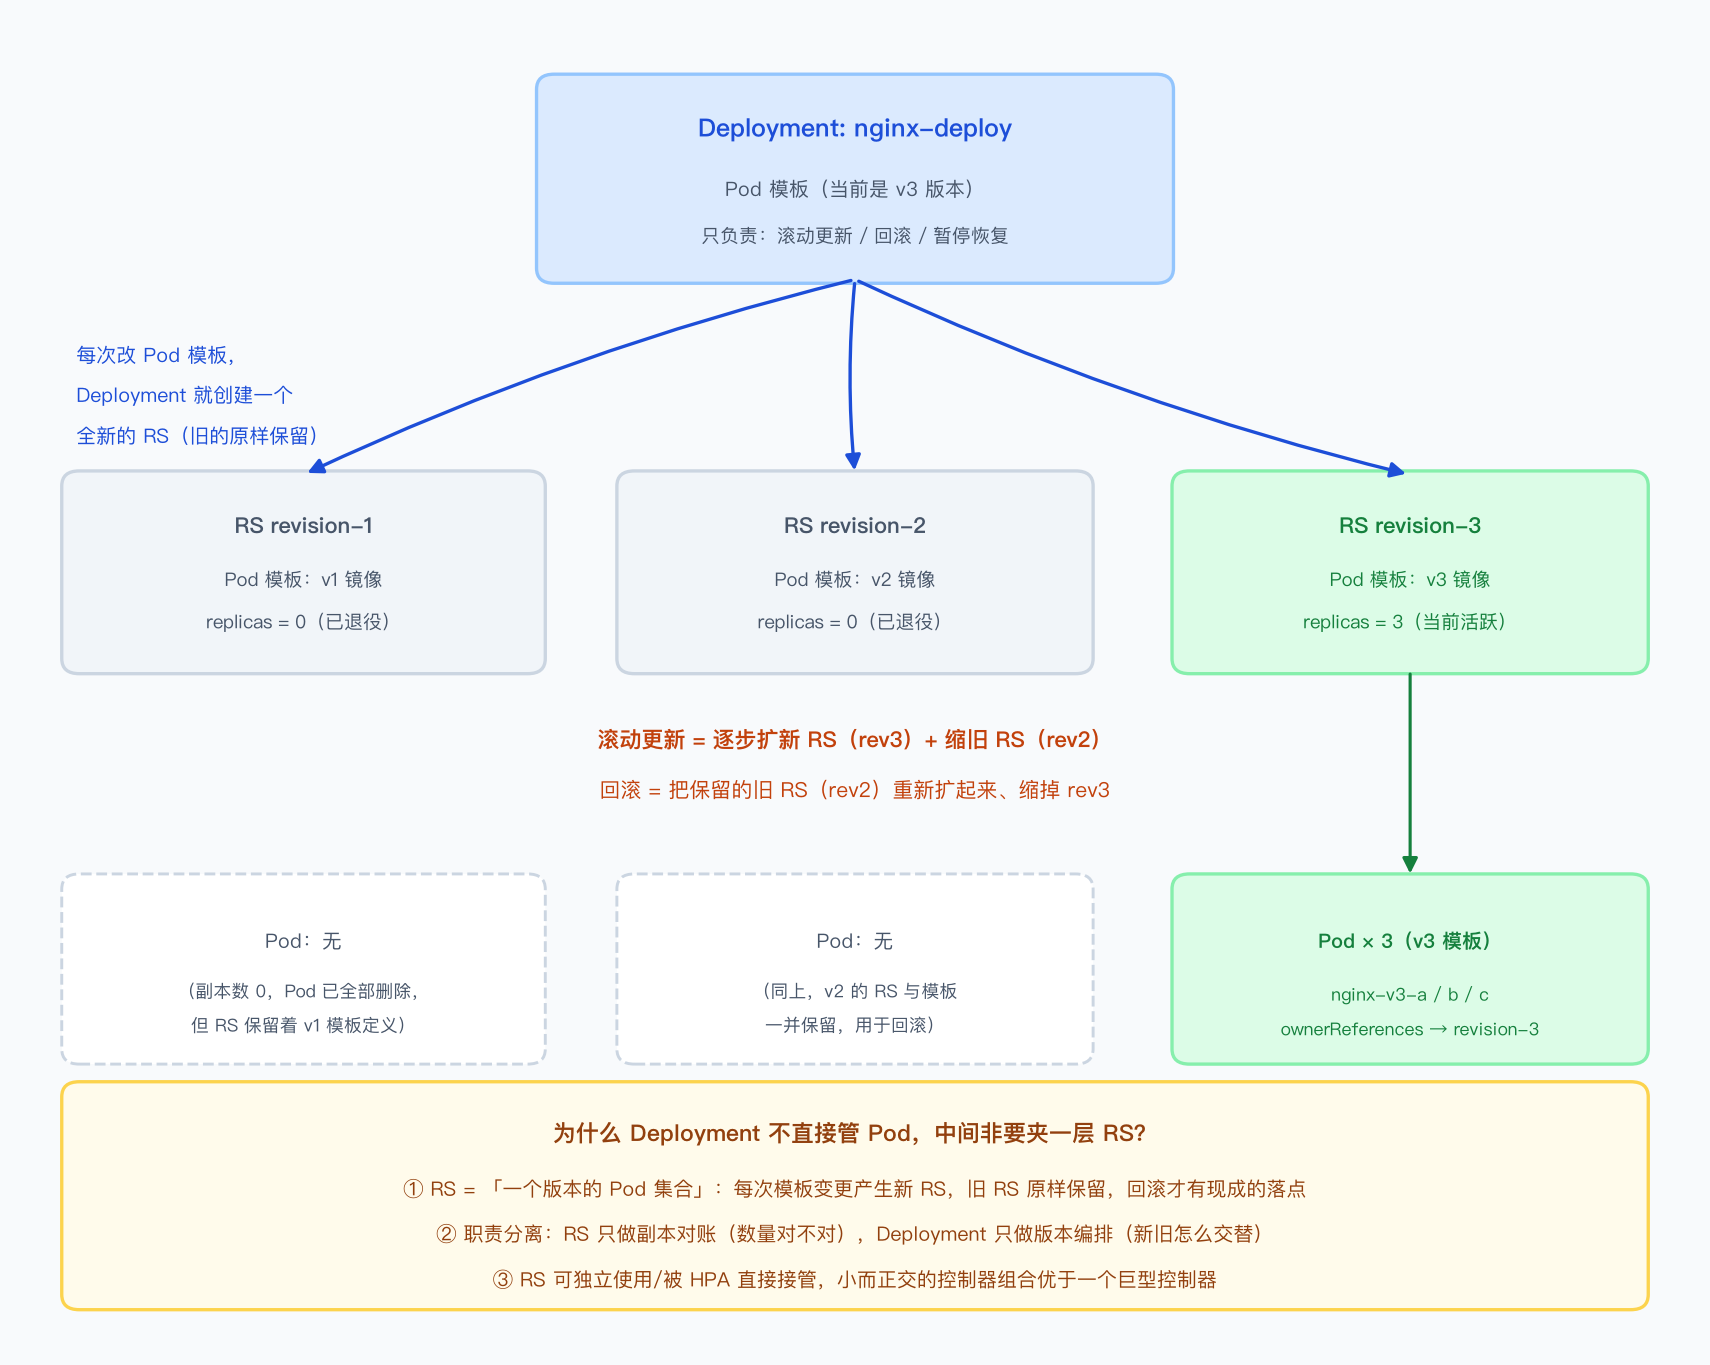
答案是:RS 是"一个版本的 Pod 集合"的具象化,Deployment 是"版本之间怎么切换"的编排者。两者各管一件事:
| ReplicaSet | Deployment | |
|---|---|---|
| 职责 | 让当前版本的 Pod 副本数始终等于 replicas | 管理多个版本的 RS,编排新旧交替 |
| 关心的问题 | "够不够 3 个 v3 Pod?" | "怎么从 v2 平滑滚到 v3?想回滚怎么办?" |
| Pod 模板变更 | 无能为力(它只认 selector,不会替换既有 Pod) | 创建一个全新的 RS,旧 RS 原样保留 |
| 回滚能力 | 没有 | rollout undo 直接把旧 RS 重新扩起来 |
分开之后,几个关键机制就顺理成章了:
kubectl rollout history的每个 revision,本质就是一个 RS。Deployment 每次修改 Pod 模板都会创建一个新 RS,旧 RS 连同它的模板原封不动留着——这就是"版本快照",回滚才有现成的落点。- 滚动更新 = 逐步扩新 RS + 缩旧 RS;回滚 = 把保留的旧 RS 重新扩起来、缩掉现在的 RS。如果 Deployment 直接管 Pod,每次更新它就得自己把"旧 Pod 集合"记在某个私有状态里,等于重新发明一遍 RS。
- 职责分离让每个控制器小而正交:RS 的对账循环只做一件事(数量对不对),Deployment 只做版本切换。HPA 也可以绕过 Deployment 直接对 RS 扩缩容,两层互不干扰。
日常不需要直接操作 RS,交给 Deployment 即可;但排查滚动更新问题时要清楚 kubectl get rs 看到的每个 RS 就是一个历史版本——replicas=0 的旧 RS 不是垃圾,删掉它们回滚就没了依据(revisionHistoryLimit 默认只保留 10 个)。

