Pod 资源请求、限制与 QoS
[toc]
引言
你是否遇到过这些问题:明明节点内存还很充裕,Pod 却被杀掉了;某个"失控"的应用把整台节点的 CPU 吃光,拖垮了同节点所有服务;或者节点一有压力,你最重要的业务 Pod 反而最先被驱逐?这些问题的根源都指向同一个机制——Pod 的资源请求(requests)、资源限制(limits)与服务质量类(QoS Class)。
本文面向刚接触 Kubernetes 的读者,从零讲清三件事:
- requests 与 limits 各自管什么——一个是"调度依据",一个是"运行上限",混淆它们是新手最常见的误区;
- CPU 和内存超限的后果为什么完全不同——CPU 超限只是被"掐流量"(throttle),内存超限会被内核直接 OOMKill;
- QoS 类如何决定节点压力时谁先被驱逐——BestEffort 先死、Guaranteed 活到最后。
读完本文,你应该能为自己的工作负载写出合理的资源配置,并明白每一行 resources 配置背后的运行时行为。Pod 的整体背景知识见 pod简介 与 Pod创建流程详解;运行期间的探针行为见 pod健康检查,生命周期各阶段见 pod生命周期。
官方文档参考
以上链接均为 Kubernetes 中文官网地址,已逐一验证有效。
1. requests 与 limits:一字之差,语义完全不同
每个容器的 CPU 和内存都可以配置两个值:
apiVersion: v1
kind: Pod
metadata:
  name: resources-demo
spec:
  containers:
    - name: app
      image: nginx:1.27
      resources:
        requests:          # 资源请求:调度依据 + 运行时的"保底承诺"
          cpu: "250m"
          memory: "128Mi"
        limits:            # 资源限制:运行时的"天花板"
          cpu: "500m"
          memory: "256Mi"
| 对比项 | requests(请求) | limits(限制) |
|---|---|---|
| 决策者 | kube-scheduler(调度时) | kubelet / 内核 cgroup(运行时) |
| 语义 | 调度器保证:只有节点的"可分配资源"大于等于 Pod 所有容器 requests 之和,才会把 Pod 放上去 | 容器运行时能消耗的资源上限 |
| CPU 超限后果 | —— | 被 CFS 限流(throttle),变慢但不死 |
| 内存超限后果 | —— | 被内核 OOMKill 杀掉容器 |
| 影响 QoS 类 | 是 | 是 |
一句话总结(对应官方文档原文):
我们保障容器拥有它请求数量的内存,但不允许使用超过限制数量的内存。
官方在 CPU 资源任务页中的表述是:"如果系统有空闲的 CPU 时间,则可以保证给容器分配其所请求数量的 CPU 资源",而"容器使用的 CPU 不能超过所配置的限制"。
requests 决定"你能不能上这个节点"(调度准入),limits 决定"上去之后你最多能吃多少"(运行约束)。Pod 的 requests 等于其中所有容器 requests 之和,limits 同理——调度器看的是总和。
1.1 只写一个值会怎样
- 只写 limits 不写 requests:Kubernetes 自动把 requests 设为与 limits 相同的值(官方任务页明确说明此行为)。
- 只写 requests 不写 limits:CPU 无上限(可用光节点空闲 CPU);内存无上限,甚至可能触发节点级 OOM Killer。
- 都不写:Pod 变成 BestEffort 类,风险见下文 BestEffort 陷阱。
2. 单位:CPU 的"毫核"与内存的字节后缀
2.1 CPU 单位
Kubernetes 中 1 个 CPU 等同于:
- 1 个 AWS vCPU
- 1 个 GCP 核心
- 1 个 Azure vCore
- 裸机上具有超线程能力的英特尔处理器上的 1 个超线程
CPU 允许使用小数,后缀 m 表示"毫"(milli,千分之一):
| 写法 | 含义 |
|---|---|
1 或 "1" | 1 个完整 CPU |
0.5 | 半个 CPU |
500m | 500 毫核,等于 0.5 CPU |
100m | 100 毫核,等于 0.1 CPU |
精度不能超过 1m。注意 CPU 请求是绝对数量而不是相对数量:0.1 CPU 在单核机器和 48 核机器上是同一个值。
2.2 内存单位
内存的基本单位是字节(byte),可用后缀:E、P、T、G、M、K(十进制)与 Ei、Pi、Ti、Gi、Mi、Ki(二进制,1024 进制)。
128974848, 129e6, 129M, 123Mi # 官方文档给出的近似相等示例
1M = 1000 x 1000 字节,1Mi = 1024 x 1024 字节,相差约 4.9%。生产环境建议统一使用 Mi/Gi 系列二进制后缀,避免"明明申请了 1G 却只有 953Mi"的困惑。
3. CPU 超限被限流(throttle),内存超限被 OOMKill
这是 requests/limits 机制中最重要、也最容易踩坑的区别。
3.1 CPU:超了只是"慢"
CPU 是可压缩资源。容器实际用量超过 CPU limit 时,内核通过 CFS 带宽控制把该 cgroup 的进程"掐"住——每个调度周期内只允许它使用 limit 对应的时间片,用完就得等下一个周期。表现为:
- 应用延迟升高、吞吐下降;
- Pod 不会被杀死,
kubectl get pod状态一切正常; - 监控上能看到
container_cpu_cfs_throttled_periods_total等限流指标上升。
官方实验很直观:创建一个 CPU limit 为 1、但参数要求用 2 个 CPU 的压力容器,kubectl top pod 显示用量被封顶在 974m 左右(略低于 1 CPU),Pod 继续正常运行。
3.2 内存:超了就要死
内存是不可压缩资源——已分配的内存没法像 CPU 时间片那样"收回来"。容器分配的内存超过 limit 后,会成为被终止的候选;若继续消耗超出限制,就会被内核 OOM Killer 杀掉,容器状态显示 OOMKilled(退出码 137):
kubectl get pod memory-demo-2
# NAME            READY     STATUS      RESTARTS   AGE
# memory-demo-2   0/1       OOMKilled   1          24s
如果容器可以被重启,kubelet 会像处理其他运行时失败一样重启它——于是你会看到"OOMKilled 与 Running 反复交替、RESTARTS 不断上涨"的典型现象。被 OOMKill 的是单个容器,Pod 内其他容器不受影响(这一点官方在 QoS 文档"某些行为独立于 QoS 类"一节明确说明)。
Java、Go 等运行时的堆外内存、页缓存都计入 cgroup 内存。如果 limit 等于压测峰值内存,生产流量稍一波动就会 OOMKill。常见做法是 limit 预留 20%~30% 余量,或为应用显式配置堆大小上限(如 Java 的 -XX:MaxRAMPercentage)。
3.3 两者对照表
| 维度 | CPU 超限 | 内存超限 |
|---|---|---|
| 资源类型 | 可压缩(compressible) | 不可压缩(incompressible) |
| 执行者 | 内核 CFS 带宽控制 | 内核 OOM Killer |
| 后果 | 限流(throttle),性能下降 | 容器被杀(OOMKilled,退出码 137) |
| Pod 状态 | 正常 Running | 反复 OOMKilled / 重启 |
| 是否进入驱逐流程 | 否 | 否(超 limit 的 OOMKill 不等于节点压力驱逐) |
4. 三大 QoS 类:Kubernetes 怎么给 Pod 分等级
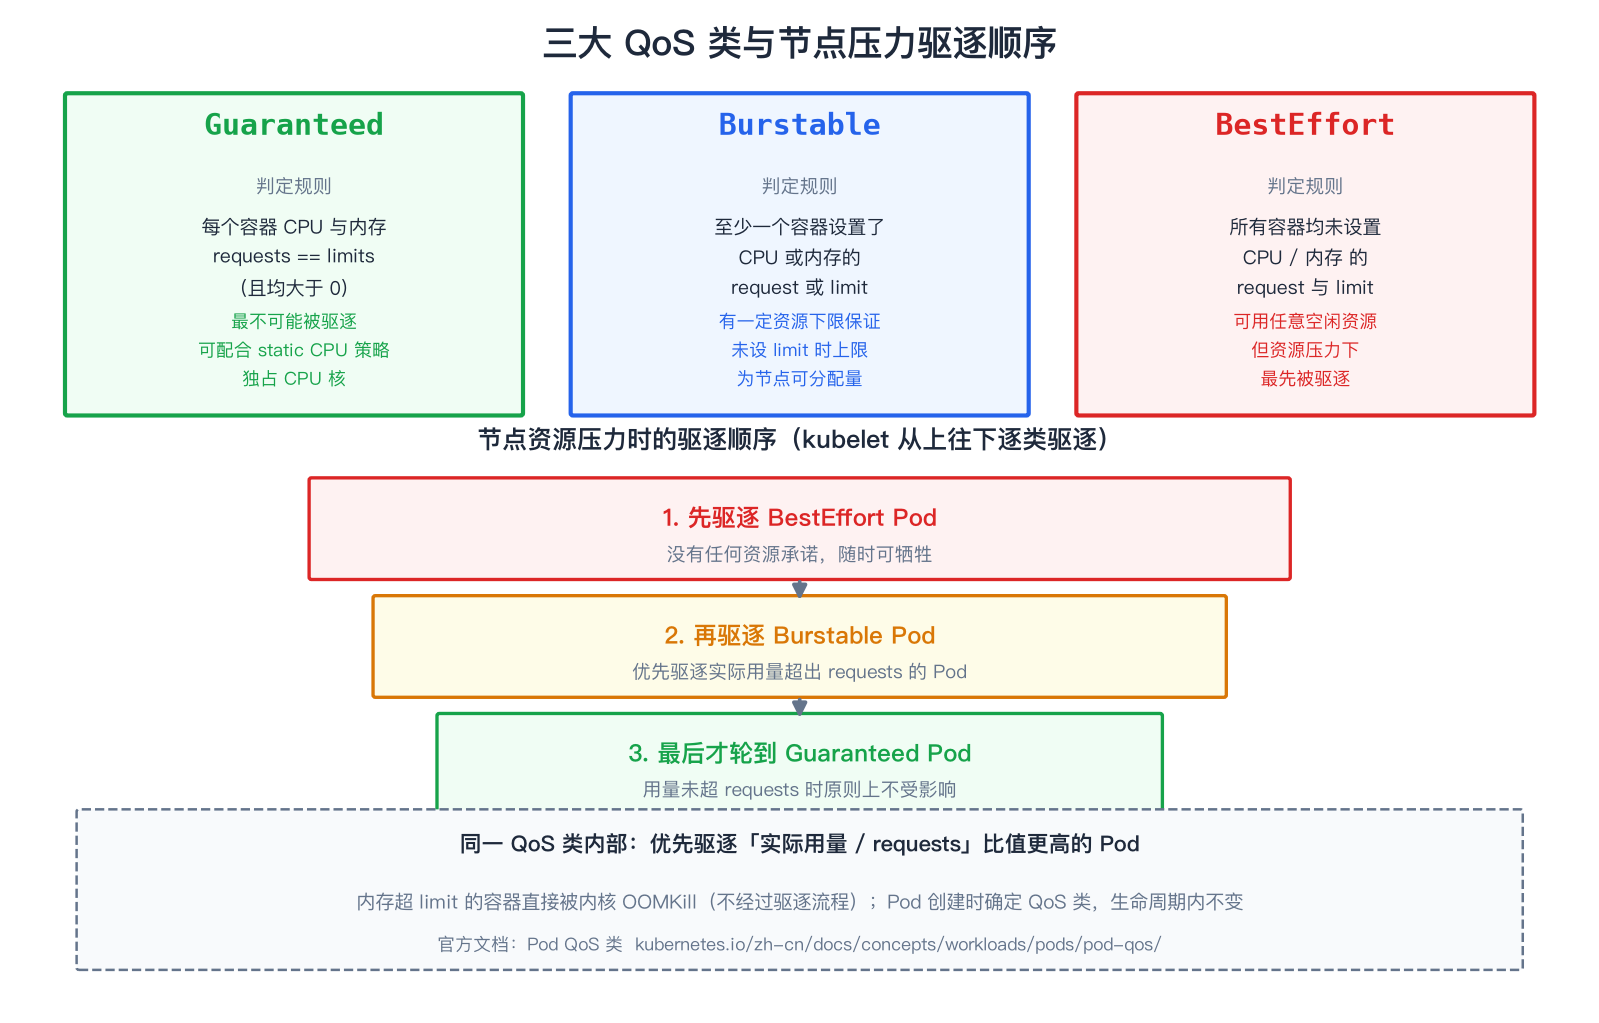
Kubernetes 依据 Pod 中每个容器的 requests/limits 配置,把 Pod 分为三个 QoS(Quality of Service,服务质量)类:Guaranteed、Burstable、BestEffort。QoS 类在 Pod 创建时确定,整个生命周期内不变。
4.1 Guaranteed(有保障)
官方判定规则原文(逐条):
- Pod 中的每个容器必须有内存 limit 和内存 request,两者都必须大于零;
- 对于 Pod 中的每个容器,内存 limit 必须等于内存 request;
- Pod 中的每个容器必须有 CPU limit 和 CPU request,两者都必须大于零;
- 对于 Pod 中的每个容器,CPU limit 必须等于 CPU request。
注意是"每个容器"都要满足,缺一个容器不满足就整体降级。最简单的写法是只设 limits(requests 会被自动设成相同值):
resources:
  limits:
    cpu: "500m"
    memory: "256Mi"
  # requests 自动等于 limits,仍是 Guaranteed
4.2 Burstable(突发)
官方判定规则:
- Pod 不满足 Guaranteed 的判据;
- Pod 中至少一个容器有内存或 CPU 的 request 或 limit,或者 Pod 本身设置了 Pod 级别的内存或 CPU 的 request 或 limit。
Burstable Pod 有基于 request 的资源下限保证;未设置 limit 时,默认其 limit 等于节点容量——资源空闲时可以"突发"使用任意量,这是它得名的原因。
4.3 BestEffort(尽力而为)
官方判定规则:
如果 Pod 不满足 Guaranteed 或 Burstable 的判据,则它的 QoS 类为 BestEffort。换言之,只有当 Pod 中的所有容器没有内存 limit 或内存 request,也没有 CPU limit 或 CPU request,且 Pod 本身也没有设置任何 Pod 级别的内存或 CPU 的 limit 或 request 时,Pod 才是 BestEffort。
即:完全不配置 resources 字段。
5. BestEffort 陷阱:不写 resources 的真实代价
很多新手觉得"不写 resources 少占资源、调度更容易",实际上这是给自己埋雷:
- 节点压力时最先被驱逐。官方原文:"当一个 Node 耗尽资源时,Kubernetes 将首先驱逐在该 Node 上运行的 BestEffort Pod,然后是 Burstable Pod,最后是 Guaranteed Pod。"
- 发生 OOM 时优先被杀。没有资源限制的容器"被杀掉的可行性更大"(内存任务页原文)。
- 毫无资源承诺。节点一旦繁忙,它拿到的 CPU 时间片没有任何下限,性能完全随缘。
生产集群中不应存在任何 BestEffort Pod。哪怕业务很小,也至少写一个保守的 requests(例如 cpu: 50m / memory: 64Mi),让调度器知道它的存在,并在 QoS 体系中给它留一席之地。
5.1 QoS 如何影响节点压力驱逐顺序
当节点出现内存、磁盘等资源压力时,kubelet 执行节点压力驱逐(官方文档:https://kubernetes.io/zh-cn/docs/concepts/scheduling-eviction/node-pressure-eviction/ ),QoS 类是排序的核心依据之一(驱逐顺序示意见上文第 4 节配图):
同一 QoS 类内部,kubelet 优先驱逐"实际资源用量超出 requests"更多的 Pod——官方原文:"当这种驱逐是由于资源压力时,只有超出资源请求的 Pod 才是被驱逐的候选对象。" 这也解释了为什么 requests 要如实反映日常用量:虚报 requests 可以在驱逐排序中"伪装"成低风险,但会浪费调度资源;少报 requests 则让自己的 Pod 在压力下率先出局。
5.2 oom_score_adj:内核层面的生死排序
QoS 不只是 kubelet 里的一个标签,它会被落到 Linux 内核的 oom_score_adj 上。kubelet 在启动容器时按 QoS 类设置该值:
| QoS 类 | 典型 oom_score_adj | 含义 |
|---|---|---|
| Guaranteed | -997 | 几乎不可能被内核 OOM Killer 选中 |
| Burstable | 1000 - (1000 x memoryRequest) / 节点可分配内存,再减 2 之类的动态公式 | request 越小,分值越高,越容易被选 |
| BestEffort | 1000 | OOM Killer 的头号目标(分值最高最先被杀) |
你可以在节点上验证:cat /proc/<容器主进程pid>/oom_score_adj。这意味着即使还没轮到 kubelet 驱逐,只要节点内存真正耗尽触发内核 OOM Killer,BestEffort Pod 也会第一个"顶包"。
6. 用 kubectl 查看 Pod 的 QoS 类
kubectl get pod 的默认输出不显示 QoS,查看方式有三种:
# 方式一:JSONPath 直接取 qosClass 字段
kubectl get pod <pod名> -o jsonpath='{.status.qosClass}'

# 方式二:自定义列,一次看多个
kubectl get pods -o custom-columns=NAME:.metadata.name,QOS:.status.qosClass

# 方式三:查全集群所有 BestEffort Pod(排查安全隐患时常用)
kubectl get pods -A -o json |
  jq -r '.items[] | select(.status.qosClass=="BestEffort") |
         "\(.metadata.namespace)/\(.metadata.name)"'
7. LimitRange:给"忘了写 resources"的 Pod 兜底
如果整个命名空间的 Pod 都不写 resources,管理员可以用 LimitRange 为命名空间配置默认值:新建 Pod 若未指定 requests/limits,会被自动注入默认值(通常注入后 Pod 会变成 Burstable 而不是 BestEffort)。LimitRange 还能设置最小/最大限制约束和单个容器/PVC 的比例约束。
LimitRange 的完整用法(默认值、min/max 约束、与 ResourceQuota 配额的配合)建议在熟悉本文后进一步阅读官方任务文档"为命名空间配置默认的内存请求和限制":https://kubernetes.io/zh-cn/docs/tasks/administer-cluster/manage-resources/memory-default-namespace/
8. 实践建议小结
- 所有生产 Pod 都显式设置 requests 与 limits,requests 如实反映日常用量;
- CPU limit 谨慎设置:对延迟敏感型应用,过小的 CPU limit 会造成限流抖动,可考虑只设 requests 不设 CPU limit;
- 内存 limit 必须设,并留足余量,防止 OOMKill 循环;
- 核心业务用 Guaranteed(requests == limits),换取最强的节点压力存活能力;
- 上线前用
kubectl get pod -o custom-columns=NAME:.metadata.name,QOS:.status.qosClass抽查 QoS 类是否符合预期; - 集群管理员配合 LimitRange + ResourceQuota 兜底,杜绝 BestEffort。
相关笔记
- pod简介——Pod 基础概念
- Pod创建流程详解——调度器在创建流程中的位置
- pod生命周期——Pod 从创建到终结的全过程
- pod健康检查——探针与容器重启的关系
- infra容器pause详解——Pod 内看不见的基础容器

