原生边车容器
[toc]
你的应用容器已经在日志文件里写了一整天的日志,边车里的 filebeat 也在老老实实地收集——直到你要下线这个 Pod:应用容器早就退出了,日志边车却还活着,Pod 卡在 Terminating 上迟迟删不掉;更难受的是 Job:任务脚本跑完了,日志收集边车还在 tail -F,整个 Job 永远停在 Running。这就是传统边车容器的老大难问题。Kubernetes v1.29 起引入的**原生边车容器(Sidecar Containers)**用一个极简的设计回答了它:边车就是 init 容器加一行 restartPolicy: Always。本文讲清楚它的原理、生命周期和典型用法,适合已经理解 Pod 与容器生命周期的读者。
相关笔记:init容器(原生边车的实现基础,强烈建议先读)、pod生命周期(启动/终止时序)、pod健康检查(边车支持的探针)、infra容器pause详解(Pod 里另一个隐藏容器)。
官方文档参考
1. 传统边车的实现与问题
Kubernetes 早期没有"边车"这个一等公民概念。想要边车,只能把它写在 spec.containers 里,和业务容器并排:
# 传统边车写法:日志收集容器与业务容器并列在 containers 中
apiVersion: v1
kind: Pod
metadata:
  name: legacy-sidecar
spec:
  containers:
  - name: app                        # 业务容器
    image: alpine:3.19
    command: ["sh", "-c", "while true; do echo logging >> /opt/logs.txt; sleep 1; done"]
    volumeMounts:
    - name: data
      mountPath: /opt
  - name: logshipper                 # "边车":只是恰好也放在 containers 里的普通容器
    image: alpine:3.19
    command: ["sh", "-c", "tail -F /opt/logs.txt"]
    volumeMounts:
    - name: data
      mountPath: /opt
  volumes:
  - name: data
    emptyDir: {}
这种写法有两个结构性缺陷:
缺陷一:没有启动顺序保证。 containers 里的所有容器是并行启动的,无法表达"边车先就绪、业务再启动"。对 service mesh 这类场景是致命的——业务容器可能抢在 envoy 代理就绪之前发出第一批请求,流量没经过代理直接绕过 mesh;反过来 Pod 终止时业务容器已经退出了,代理却先被杀,尾延迟请求的响应再也没人转发了。社区为此发明了 postStart 睡眠、istio-proxy 的 holdApplicationUntilProxyStarts 等各种 workaround。
缺陷二:生命周期不独立,终止时序失控。 普通 containers 里所有容器的地位完全平等,Kubernetes 不区分谁是业务谁是边车。于是出现两个经典故障:
- Pod 无法终止:
kubectl delete pod时,kubelet 并行给所有容器发 SIGTERM。业务容器很快退出,但日志边车是个tail -F,对 SIGTERM 不敏感或者故意优雅退出得慢。只要还有一个容器在跑,Pod 就不算终止。结果应用早停了,Pod 却要傻等terminationGracePeriodSeconds(默认 30s)被强杀,在反复滚动发布时拖慢整个节奏。 - Job 永不完成:Pod 的完成条件是"所有容器成功退出",边车容器天然不退出,于是 Job 里的任务脚本跑完了、结果也写好了,Pod 却永远显示 Running,Job 一直不结束。
2. 原生边车:initContainers + restartPolicy: Always
v1.29 引入的原生边车没有新增任何容器类型字段,而是做了一道减法:在 initContainers 里声明的容器,只要设置了 restartPolicy: Always,就是边车容器。
# 官方示例 deployment-sidecar.yaml:边车定义为 initContainer + restartPolicy: Always
apiVersion: apps/v1
kind: Deployment
metadata:
  name: myapp
  labels:
    app: myapp
spec:
  replicas: 1
  selector:
    matchLabels:
      app: myapp
  template:
    metadata:
      labels:
        app: myapp
    spec:
      containers:
      - name: myapp                      # 业务容器
        image: alpine:latest
        command: ['sh', '-c', 'while true; do echo "logging" >> /opt/logs.txt; sleep 1; done']
        volumeMounts:
        - name: data
          mountPath: /opt
      initContainers:
      - name: logshipper                 # 边车容器:注意它写在 initContainers 里
        image: alpine:latest
        restartPolicy: Always            # 这一行的存在使它从"常规 init 容器"变成"边车容器"
        command: ['sh', '-c', 'tail -F /opt/logs.txt']
        volumeMounts:
        - name: data
          mountPath: /opt
      volumes:
      - name: data
        emptyDir: {}
理解要点:restartPolicy: Always 只能出现在 initContainers 中。写在这里的含义不是"崩了重启"(普通容器的 restartPolicy 才是这个语义),而是"这个 init 容器完成任务后不要退出,在整个 Pod 生命周期里持续运行"。Kubernetes 借用 init 容器现成的串行启动顺序解决了缺陷一,又用"边车不算进完成条件"解决了缺陷二——不引入新概念,全部复用既有机制。
看到 initContainers 里有 restartPolicy: Always,它就是边车;没有这行,就是"常规 init 容器",跑完即退。同一个 Pod 里两者可以混用,按书写顺序串行启动。
3. 生命周期:最先启动,最后停止
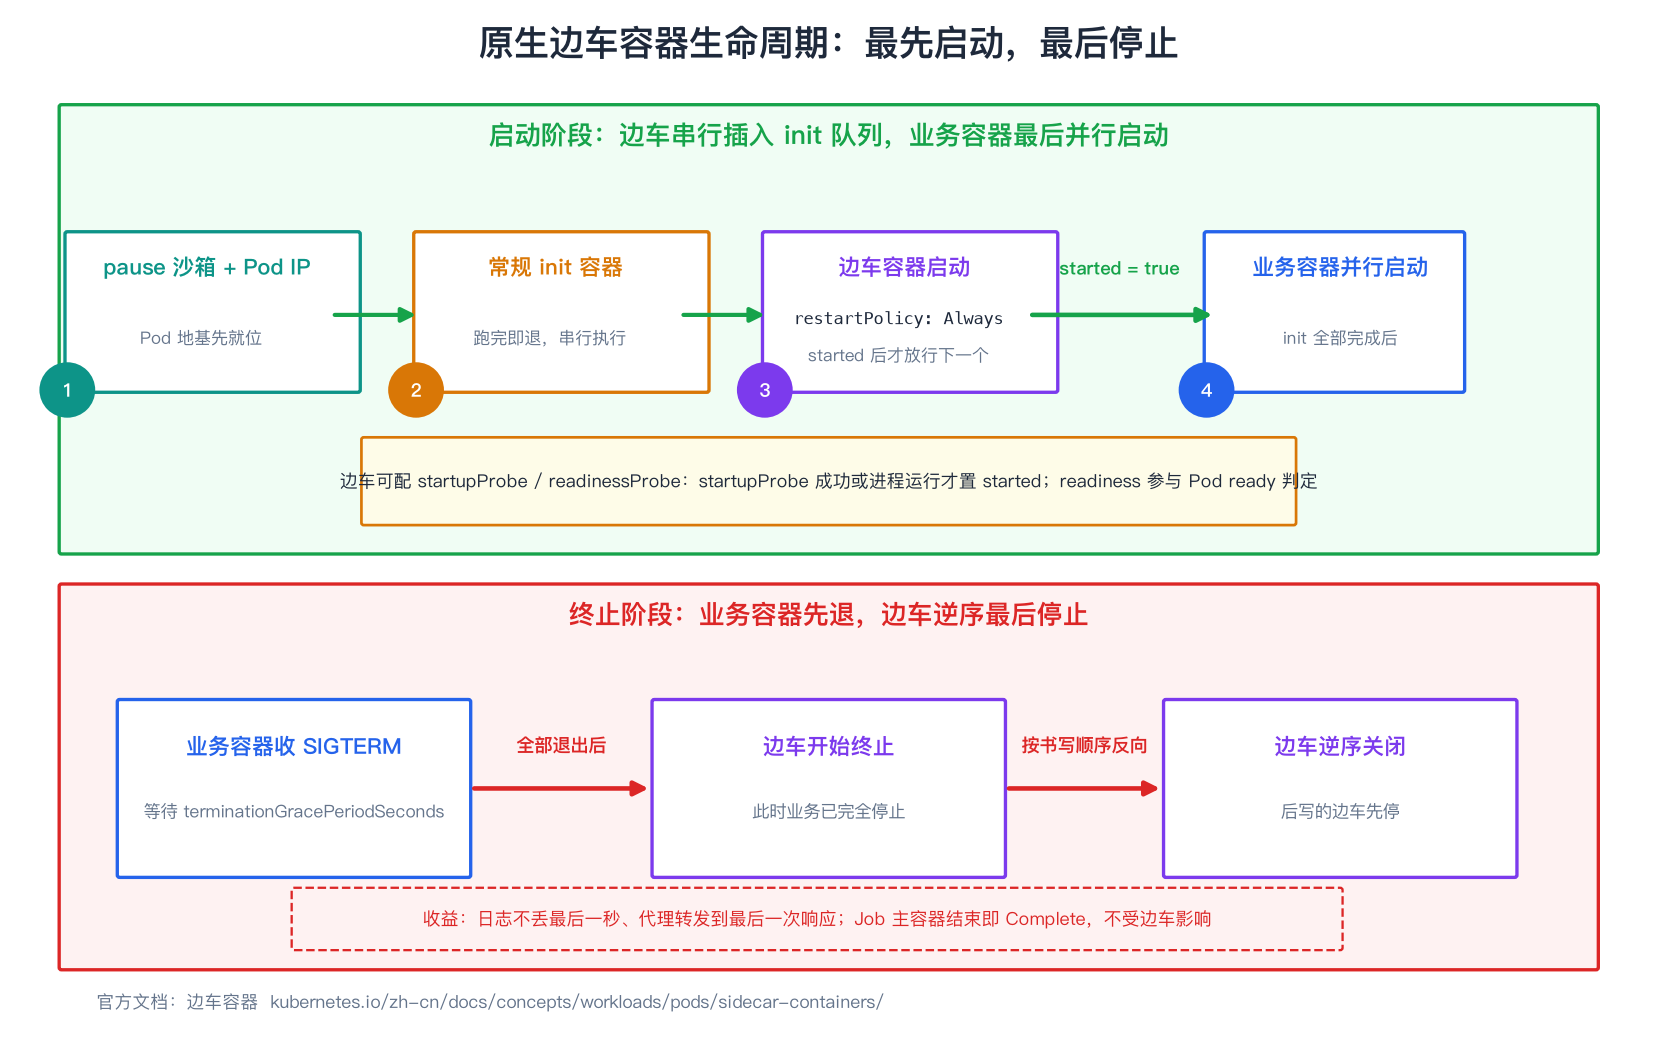
边车容器之所以能根治传统边车的两个缺陷,靠的是它两侧特殊的位置:
3.1 启动阶段:串行插入,先于业务容器
启动顺序是(配合 pod生命周期 的整体时序阅读):
- pause 沙箱启动,CNI 分配 Pod IP(见 infra容器pause详解)
initContainers按书写顺序逐个启动:边车容器启动且变为 started 状态后,kubelet 才启动列表中的下一个 init 容器- 所有 init 容器(含边车)处理完毕后,
containers里的业务容器并行启动
关键细节是 started 状态的判定:边车容器有进程在运行且未定义启动探针,或者 startupProbe 探测成功,kubelet 才把它置为 started、放行下一个 init 容器。如果给边车配了 readinessProbe,其结果还会用于计算 Pod 的 ready 状态。这意味着你可以让 envoy 边车就绪之后业务容器才启动——不用任何 hack,这就是一等公民的时序保证。
3.2 终止阶段:业务容器先退,边车逆序最后停
Pod 终止时(kubectl delete pod 或节点下线),kubelet 的处理顺序是:
- 主应用容器先进入体面终止流程:发 SIGTERM,等待
terminationGracePeriodSeconds - 所有主应用容器完全停止后,kubelet 才开始终止边车容器
- 边车按 Pod 规约中出现的相反顺序依次关闭
这个顺序保证在业务进程还活着的最后一毫秒,日志边车、代理边车都还在岗——日志不会因为边车先死而丢失最后一秒,代理也不会在业务还有响应要转发时提前下线。
由于终止时边车往往还停在"服务中"的状态,等业务容器耗尽体面终止时间后才被叫停,边车会收到 SIGTERM 后紧接 SIGKILL,退出码常常不是 0。官方文档明确说明这是正常的,外部监控工具应该忽略边车容器的非 0 退出码。
4. 典型场景
4.1 Job 中的边车
传统边车在 Job 里的死结——任务完成了边车还活着——被原生边车直接解开:Job 判定完成的条件只看主容器,边车不影响。
# 官方示例 job-sidecar.yaml:任务退出后边车自动结束,Job 正常 Complete
apiVersion: batch/v1
kind: Job
metadata:
  name: myjob
spec:
  template:
    spec:
      restartPolicy: Never              # Pod 级重启策略
      containers:
      - name: myjob                     # 任务容器:写一行日志就退出
        image: alpine:latest
        command: ['sh', '-c', 'echo "logging" > /opt/logs.txt']
        volumeMounts:
        - name: data
          mountPath: /opt
      initContainers:
      - name: logshipper                # 日志收集边车
        image: alpine:latest
        restartPolicy: Always           # 标记为边车:主容器结束后由 kubelet 直接收走
        command: ['sh', '-c', 'tail -F /opt/logs.txt']
        volumeMounts:
        - name: data
          mountPath: /opt
      volumes:
      - name: data
        emptyDir: {}
4.2 Service Mesh 代理
istio、linkerd 等把 envoy 作为边车注入每个业务 Pod。原生边车出现前,"代理先就绪、业务后启动,业务先退出、代理后停止"要靠注入器配合各类 hack 实现;现在 envoy 直接声明为边车即可获得严格的时序保证。日志收集类边车(filebeat、fluent-bit)同理:挂载 emptyDir 收集业务容器写出的日志,业务停止后边车把最后一批日志发完再被终止,天然契合第 3 节的终止时序。
5. 版本演进
| 版本 | 状态 | 说明 |
|---|---|---|
| v1.28 | alpha | 需手动开启特性门控 SidecarContainers |
| v1.29 | beta,默认开启 | 无需任何配置即可使用 |
| v1.33 | GA(稳定) | 特性已锁定,SidecarContainers 门控设置被忽略 |
所以现在的主流集群(v1.29+)都开箱即用,唯一要留意的是集群里的 YAML 模板兼容性:老版本 kubelet 遇到 restartPolicy: Always 的 init 容器会直接校验报错,混版本集群滚动升级期间要小心。
6. 三种容器对比
| 维度 | 常规 init 容器 | 边车容器 | 普通容器(业务) |
|---|---|---|---|
| 声明位置 | initContainers | initContainers + restartPolicy: Always | containers |
| 运行时段 | 启动前,跑完即退 | 整个 Pod 生命周期 | 整个 Pod 生命周期 |
| 启动顺序 | 严格串行,前一个成功才启动下一个 | 串行插入 init 队列,started 后放行下一个 | 全部并行启动 |
| 探针支持 | 不支持 livenessProbe/readinessProbe/startupProbe/lifecycle | 全部支持,readiness 参与 Pod ready 判定 | 全部支持 |
| 完成判定(Job) | 需成功完成 | 不影响 Job 完成 | 退出方式决定 Job 结果 |
| 终止顺序 | 不适用(早已退出) | 业务容器完全停止后,逆序最后终止 | 先于边车终止 |
| 与业务容器交互 | 单向(共享卷写数据) | 实时双向(共享网络 + 可选共享卷) | — |
| 修改镜像字段 | 不触发 Pod 重启 | 不触发 Pod 重启,触发该容器重启 | 触发 Pod 重建(受控器管理时) |
对普通业务容器修改 image 字段时, Deployment 管理的 Pod 会被重建;而变更边车容器的镜像不会导致 Pod 重启,只会触发边车容器本身重启——这是边车独立生命周期特性的直接体现。
7. 小结
- 原生边车 =
initContainers里的restartPolicy: Always,v1.29 beta 默认开启、v1.33 GA - 生命周期两头占优:先于业务容器启动(started 才放行后续 init 容器与业务容器)、业务容器完全停止后逆序最后终止
- 根治了传统边车的两大顽疾:滚动发布时 Pod 卡 Terminating、Job 永不 Complete
- 与 init 容器、普通容器的本质差异在运行时段、探针支持与终止时序;混用时记住一条判断标准即可

