pod健康检查
pod健康检查官方文档(configure-liveness-readiness-startup-probes) Pod 生命周期与容器探针概念文档
健康检查(探针,Probe)是 kubelet 对容器执行的定期诊断:kubelet 按探针配置周期性地检测容器状态,根据检测结果决定重启容器、还是把 Pod 从 Service 后端摘除。没有探针的容器,进程假死时 kubelet 毫无感知,服务会一直把流量发给一个"活着但不好使"的实例。
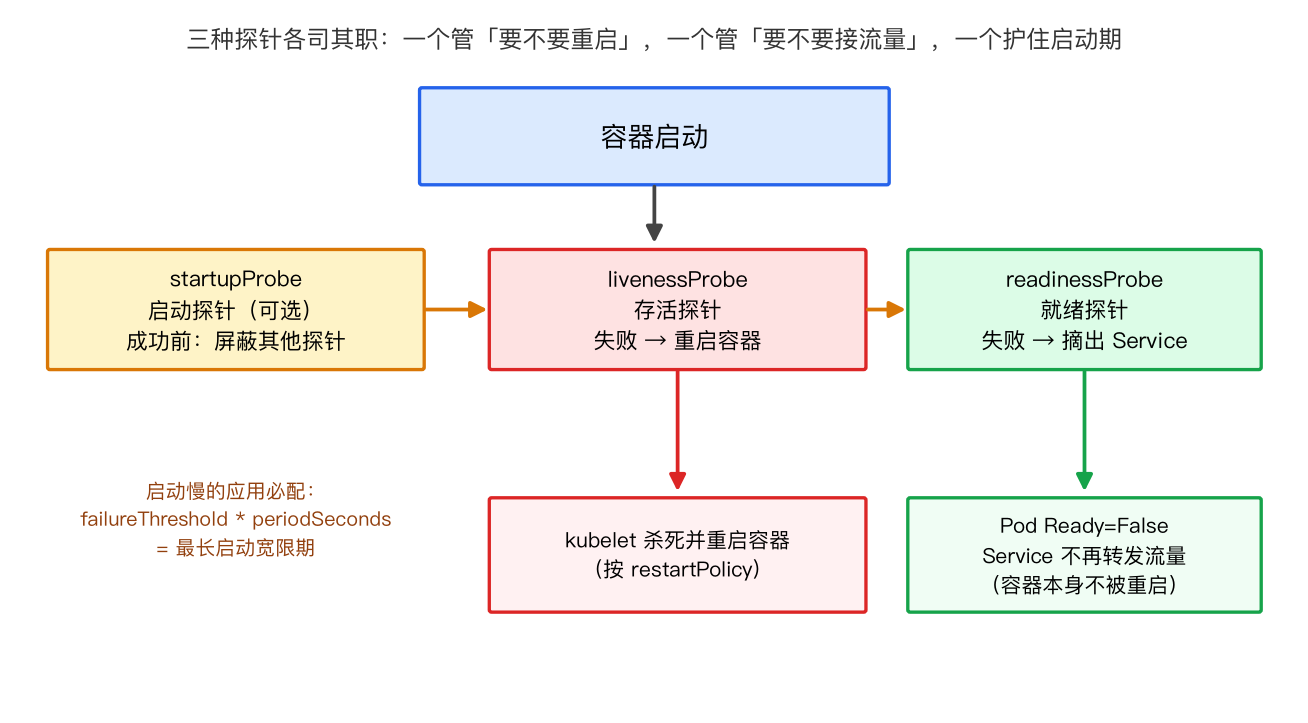
三种探针各管一件事
livenessProbe 存活探针
判定容器是否需要被重启。探针失败(连续 failureThreshold 次)时,kubelet 杀死容器并按 restartPolicy 重建。典型场景:应用死锁——进程还在,但永远不会再处理请求,只有重启才能恢复。
readinessProbe 就绪探针
判定容器是否可以接收流量。探针失败时 Pod 的 Ready 条件变为 False,从 Service 的 Endpoints 中摘除,不再有新请求进来——但容器本身不会被重启。典型场景:应用启动时要加载数据、临时依赖某个后端不可用。就绪探针在容器整个生命周期内持续运行。
startupProbe 启动探针
保护启动慢的应用。启动探针成功之前,kubelet 会屏蔽其他探针(liveness/readiness 都不生效),避免应用还在初始化就被存活探针判死。启动探针失败则重启容器。启动慢的应用(大 JVM、预热缓存、迁移数据库)强烈建议配置。
liveness 与 readiness 是并行独立的:liveness 探针不会等 readiness 先成功。如果希望"应用启动完成之前不要执行存活探测",应该用 initialDelaySeconds 或 startupProbe,而不是指望 readiness。
四种检查机制
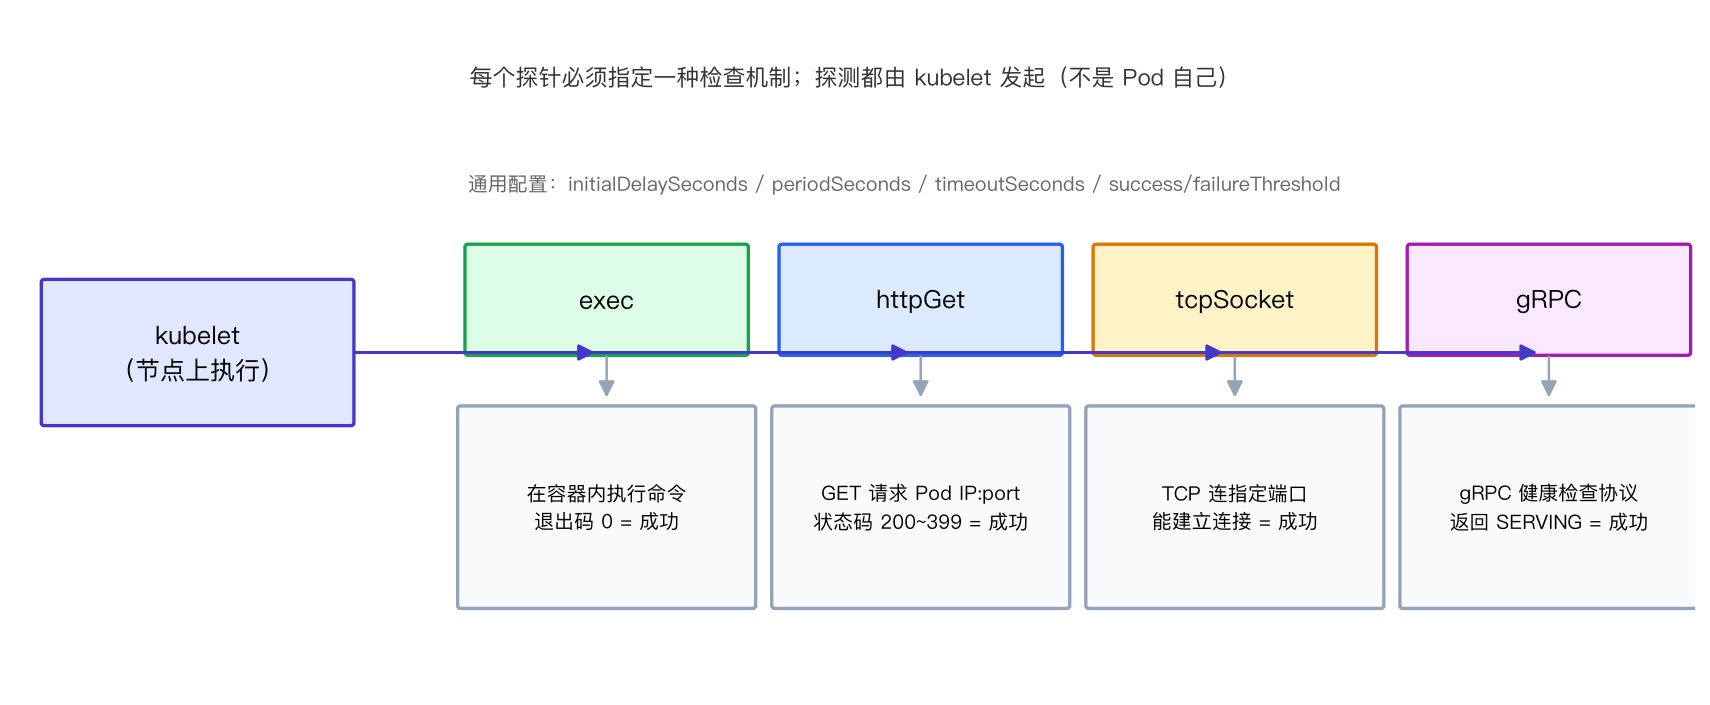
每种探针(liveness/readiness/startup)都必须指定以下四种机制之一:
| 机制 | 原理 | 成功判定 |
|---|---|---|
exec | 在容器内执行一条命令 | 退出码为 0 |
httpGet | 对 Pod IP:port/path 发 HTTP GET 请求 | 状态码 ≥ 200 且 < 400 |
tcpSocket | 对 Pod IP:port 建立 TCP 连接 | 连接能建立(连上后立即被关闭也算健康) |
gRPC | 使用 gRPC 健康检查协议 远程调用 | 响应状态为 SERVING |
gRPC 探针自 Kubernetes v1.24 起为 beta 特性并默认启用(更早的 v1.23 才需要手动开启 GRPCContainerProbe 特性门控,网上旧文章提到的这一步现在不需要了)。注意 gRPC 探针不支持命名端口,也不支持任何认证参数(如 TLS);port 为必填,健康检查端点不在默认服务上时还需配 service。
探针参数详解
| 参数 | 含义 | 默认值 |
|---|---|---|
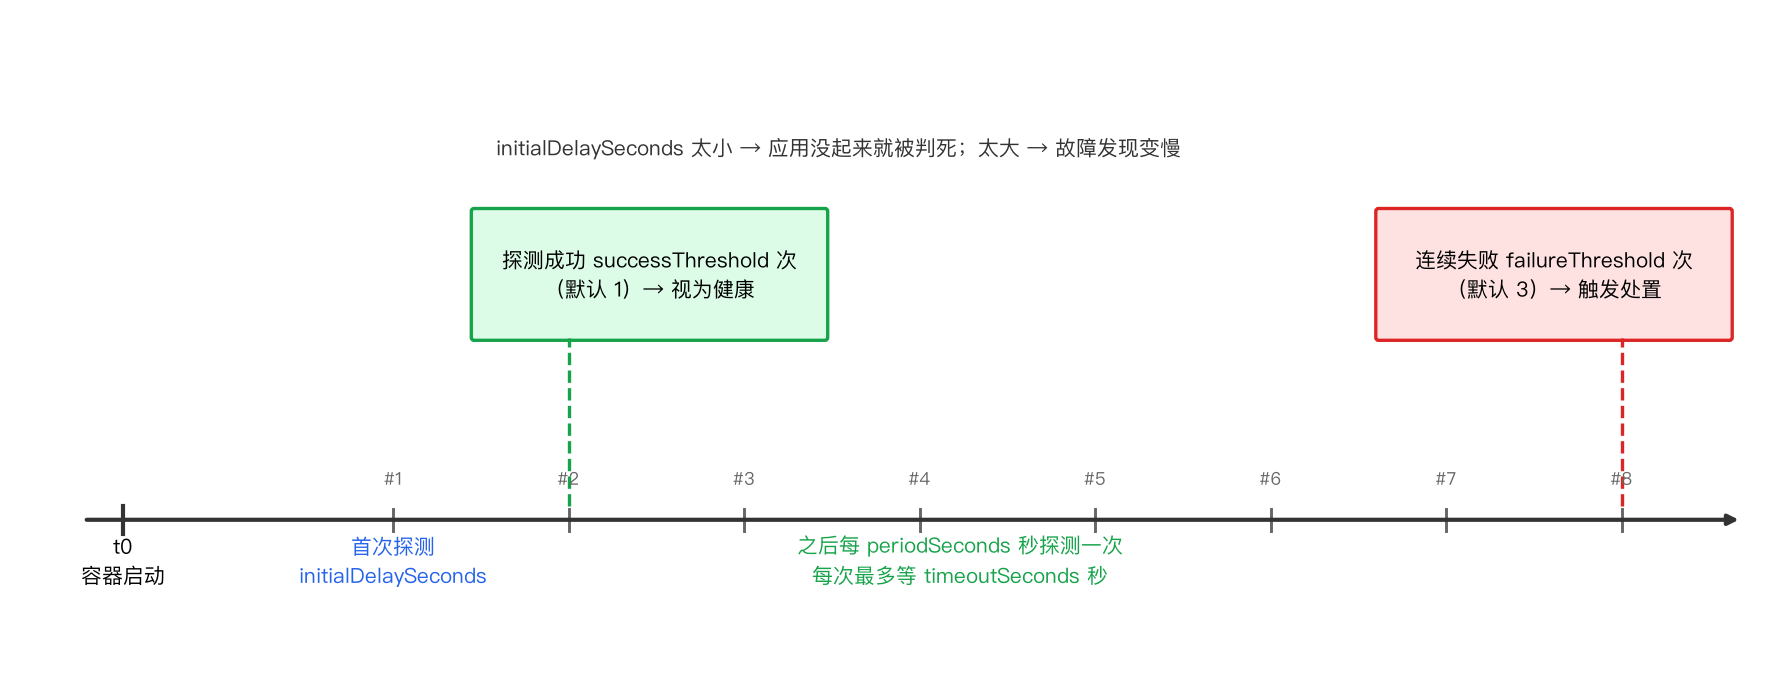
initialDelaySeconds | 容器启动后等待多少秒才开始第一次探测 | 0 |
periodSeconds | 探测执行间隔(秒) | 10 |
timeoutSeconds | 单次探测的超时时间(秒) | 1 |
successThreshold | 失败后重新判定为健康的最小连续成功次数 | 1(liveness/startup 必须为 1) |
failureThreshold | 连续失败多少次才判定探针失败 | 3 |
terminationGracePeriodSeconds | 探针失败后杀死容器的宽限期(探针级,1.25+ 默认启用,优先于 Pod 级同名参数) | 继承 Pod 级设置 |
参数之间的理解重点:
- 故障发现时间 ≈
failureThreshold × periodSeconds。默认 3 × 10 = 最快 30 秒才发现容器不健康,对敏感业务要调小periodSeconds initialDelaySeconds的两难:设小了应用还没起来就被判死(没配 startupProbe 时尤其致命);设大了正常故障的发现也被拖慢。这个两难的正式解法就是startupProbetimeoutSeconds默认只有 1 秒,exec 探针里跑个稍微慢点的脚本就会超时失败。Kubernetes v1.20 之前 exec 探针曾忽略该参数(无限等待),v1.20 起严格生效——老集群升级后如果 exec 探针突然开始超时失败,先检查这个值
就绪探针失败不会重启容器,如果探针逻辑本身会在容器里拉起子进程(比如每次 exec 都触发一个重量级检查脚本)且实现不当,失败重试会让容器内进程数持续上涨,最终资源耗尽。
实操示例
以下示例镜像均为官方 registry.k8s.io 地址,国内网络拉取失败时,可替换为可用的镜像仓库地址(或给 containerd 配置镜像加速),以实际能拉到为准。旧资料里的 mirrorgooglecontainers/* 镜像已年久失修,不建议再用。
exec 存活探针(官方经典示例)
cat > exec-liveness.yaml <<'EOF'
apiVersion: v1
kind: Pod
metadata:
  labels:
    test: liveness
  name: liveness-exec
spec:
  containers:
  - name: liveness
    image: registry.k8s.io/busybox
    args:
    - /bin/sh
    - -c
    - touch /tmp/healthy; sleep 30; rm -f /tmp/healthy; sleep 600
    livenessProbe:
      exec:
        command:
        - cat
        - /tmp/healthy
      initialDelaySeconds: 5   # 启动后等 5 秒再开始第一次探测
      periodSeconds: 5         # 每 5 秒探测一次
EOF
kubectl apply -f exec-liveness.yaml
容器生命的前 30 秒 /tmp/healthy 存在,cat 返回 0(健康);30 秒后文件被删,cat 返回非 0,连续失败 3 次后 kubelet 杀死并重启容器:
Warning  Unhealthy  25s (x3 over 35s)  kubelet  Liveness probe failed: cat: can't open '/tmp/healthy': No such file or directory
Normal   Killing    25s                kubelet  Container liveness failed liveness probe, will be restarted
反复重启多次后,Pod 会进入 CrashLoopBackOff(这是"探针配置和应用行为不匹配"的典型症状,不是集群故障):
NAME            READY   STATUS             RESTARTS      AGE
liveness-exec   0/1     CrashLoopBackOff   9 (3m34s ago) 24m
httpGet 存活探针
cat > http-liveness.yaml <<'EOF'
apiVersion: v1
kind: Pod
metadata:
  labels:
    test: liveness
  name: liveness-http
spec:
  containers:
  - name: liveness
    image: registry.k8s.io/agnhost:2.53
    args:
    - liveness
    livenessProbe:
      httpGet:
        path: /healthz
        port: 8080
        httpHeaders:
        - name: Custom-Header
          value: Awesome
      initialDelaySeconds: 3   # 启动后等 3 秒再开始第一次探测
      periodSeconds: 3         # 每 3 秒探测一次
EOF
kubectl apply -f http-liveness.yaml
agnhost 的 /liveness 服务在容器启动后前 10 秒返回 200,之后返回 500。因此 10 秒后探针开始失败:
Warning Unhealthy 1s kubelet Liveness probe failed: HTTP probe failed with statuscode: 500
tcpSocket 就绪 + 存活探针并存
cat > tcp-liveness-readiness.yaml <<'EOF'
apiVersion: v1
kind: Pod
metadata:
  name: goproxy
  labels:
    app: goproxy
spec:
  containers:
  - name: goproxy
    image: registry.k8s.io/goproxy:0.1
    ports:
    - containerPort: 8080
    readinessProbe:
      tcpSocket:
        port: 8080
      initialDelaySeconds: 5
      periodSeconds: 10
    livenessProbe:
      tcpSocket:
        port: 8080
      initialDelaySeconds: 15
      periodSeconds: 20
EOF
kubectl apply -f tcp-liveness-readiness.yaml
就绪和存活探针可以在同一个容器上并行使用:流量不会发给未就绪的容器(readiness),探测失败时容器会被重启(liveness),两者互补。
gRPC 存活探针
cat > grpc-liveness.yaml <<'EOF'
apiVersion: v1
kind: Pod
metadata:
  name: etcd-with-grpc
spec:
  containers:
  - name: etcd
    image: registry.k8s.io/etcd:3.5.14-0
    command: [ "/usr/local/bin/etcd",
               "--data-dir", "/var/lib/etcd",
               "--listen-client-urls", "http://0.0.0.0:2379",
               "--advertise-client-urls", "http://127.0.0.1:2379" ]
    ports:
    - containerPort: 2379
    livenessProbe:
      grpc:
        port: 2379          # 必填;健康端点在非默认服务上时还要配 service
      initialDelaySeconds: 10
EOF
kubectl apply -f grpc-liveness.yaml
- 探针针对的是 Pod IP(不像旧工具 grpc-health-probe 默认打 127.0.0.1),应用必须监听在 Pod IP 可达的地址上
- 不支持认证参数(如 TLS 相关),且一切错误(包括配置错误)都算探测失败
- HTTP/2 明文(h2c)探针:
httpGet.protocol: HTTP2,需要 kube-apiserver 与 kubelet 同时开启H2CContainerProbe特性门控;不支持与scheme: HTTPS或host字段组合,门控禁用时该字段会被 apiserver 移除 - gRPC TLS 探针:
grpc.mode: TLS,需要GRPCContainerProbeTLS特性门控;使用InsecureSkipVerify不校验服务端证书(与 HTTPS 探针行为一致),门控禁用时 kube-apiserver 会移除该字段
使用命名端口
HTTP 和 TCP 探针的 port 支持命名端口(gRPC 不支持),改端口时只改 containerPort 一处:
ports:
- name: liveness-port
  containerPort: 8080

livenessProbe:
  httpGet:
    path: /healthz
    port: liveness-port
启动探针保护慢启动容器
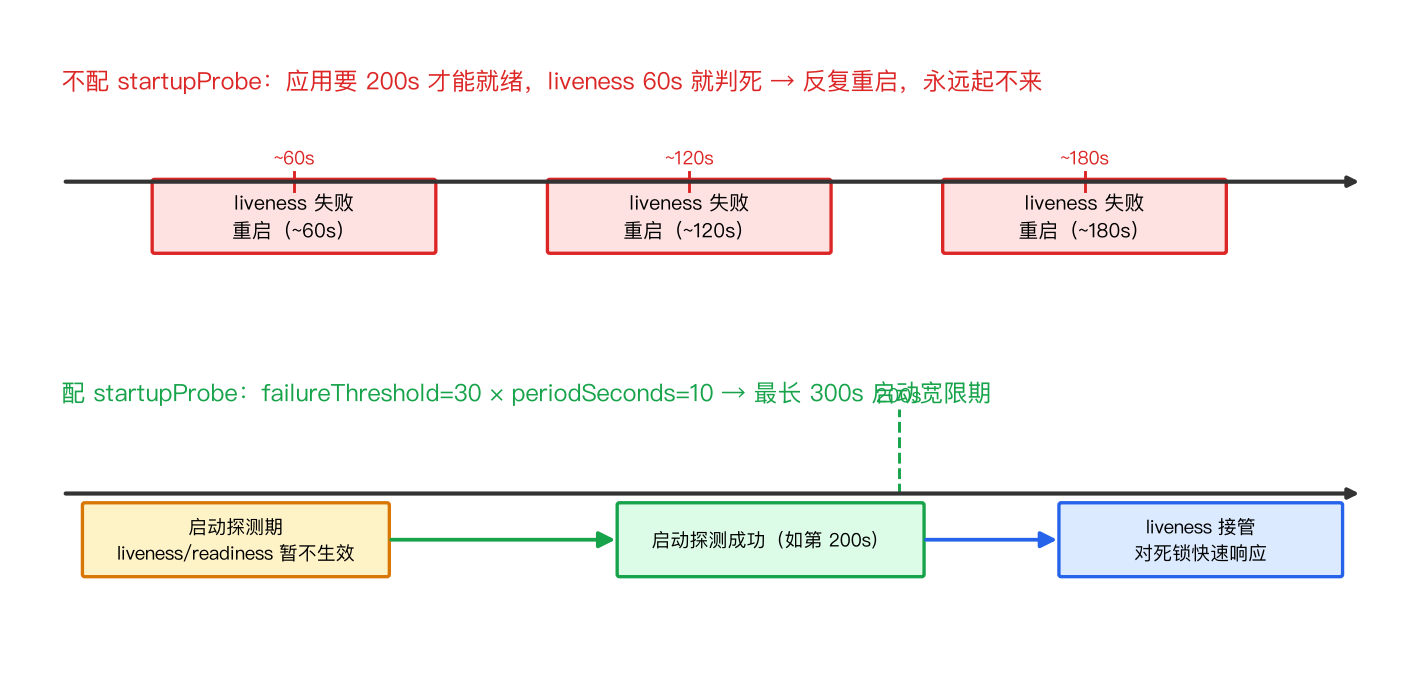
假设应用需要 200 秒才能完成初始化,而存活探针的故障发现窗口只有 60 秒——不配启动探针的话,应用永远活不到 200 秒,陷入无限重启。把 failureThreshold * periodSeconds 调大到覆盖最慢的启动时间(如 30 × 10 = 300 秒),就能同时保住两件事:
- 启动期间 liveness 不生效,应用有充足时间初始化
- 一旦 startupProbe 首次成功,liveness 立刻接管,对运行期死锁依旧快速响应
ports:
- name: liveness-port
  containerPort: 8080

livenessProbe:
  httpGet:
    path: /healthz
    port: liveness-port
  failureThreshold: 1      # 运行期容忍度低:失败 1 次就重启
  periodSeconds: 10

startupProbe:
  httpGet:
    path: /healthz
    port: liveness-port
  failureThreshold: 30     # 30 × 10s = 300s 的启动宽限期
  periodSeconds: 10
有人想用"readiness 探针 + initialDelaySeconds 拖时间"来保护慢启动应用,但 liveness 不会因此等待,照样把未启动完的容器杀掉。慢启动的正确解法只有 startupProbe(或把 liveness 的 initialDelaySeconds 设得足够大,但那样故障发现也会被拖慢)。
HTTP 探测的细节
httpGet 支持的额外字段(API 参考:Probe):
host:默认请求 Pod IP,一般不用设。需要设置的场景:容器监听 127.0.0.1 且 Pod 使用hostNetwork: true时,host应设为 127.0.0.1;应用依赖虚拟主机(vhost)路由时不要设host,改在httpHeaders里加Host头scheme:HTTP(默认)或 HTTPS(跳过证书校验)path:默认/httpHeaders:自定义请求头,可重复;把值设为空字符串可移除默认头
kubelet 发出的探测请求默认带 User-Agent: kube-probe/<版本> 和 Accept: */* 两个头(应用可借此识别并区分探测流量与真实流量),均可通过 httpHeaders 覆盖:
livenessProbe:
  httpGet:
    httpHeaders:
      - name: Accept
        value: application/json

startupProbe:
  httpGet:
    httpHeaders:
      - name: User-Agent
        value: MyUserAgent
TCP 探测的细节
TCP 探测由 kubelet 在节点上发起(不是在 Pod 里),所以 host 参数不能填服务名——kubelet 不解析集群内的服务名称。也因此 tcpSocket 只能证明"端口开着",不能证明业务逻辑正常:端口通了但应用内部已经假死的情况,要靠 httpGet/exec 探针兜底。
探针级 terminationGracePeriodSeconds
特性状态: Kubernetes v1.25 [beta](默认启用)
探针失败后 kubelet 杀容器前会留出优雅终止宽限期。v1.21 之前只有 Pod 级的 terminationGracePeriodSeconds,Pod 设得长会导致探针失败的容器迟迟不能重启。v1.25 起可以在探针级别单独设置,且优先于 Pod 级:
spec:
  terminationGracePeriodSeconds: 3600  # Pod 级别:正常停止流程给足 1 小时
  containers:
  - name: test
    image: registry.k8s.io/agnhost:2.53
    ports:
    - name: liveness-port
      containerPort: 8080
    livenessProbe:
      httpGet:
        path: /healthz
        port: liveness-port
      failureThreshold: 1
      periodSeconds: 60
      terminationGracePeriodSeconds: 60  # 探针失败走快速通道:60 秒内必须退出
实战建议
- liveness 宁可宽松,不要敏感:误杀正在处理请求的容器,比晚一点发现故障代价大得多。探针端点要轻量(查内存标志位,不要查数据库、不要加锁)
- readiness 用于滚动发布:新版本 Pod 就绪探针通过后才接流量,配合
maxUnavailable实现不中断升级 - 慢启动必配 startupProbe,把
failureThreshold × periodSeconds设为最慢启动时间的 1.5 倍左右 - httpGet 是大多数场景的首选:tcpSocket 只能证明端口开着;exec 每次都在容器内 fork 进程,探针脚本重了会拖垮容器
- 就绪检查与存活检查用不同的端点:
/healthz(存活,进程活着)与/ready(就绪,能处理请求)分开实现,语义清晰 - 带副作用的重试逻辑不要放探针里:探针失败会重试
failureThreshold次,非幂等的检查逻辑会放大副作用

